简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
text-embedding-3-small Boyutları Açıklandı: Kalite ve Maliyet için Doğru Boyutu Seçme
text-embedding-3-small boyutlarına yönelik pratik bir rehber, 256, 512, 1024 ve 1536 boyutları arasında nasıl seçim yapacağınız.
text-embedding-3-small Boyutları Açıklandı: Kalite ve Maliyet için Doğru Boyutu Seçme#
1536 boyutta, float32 olarak saklanan tek bir text-embedding-3-small vektörü 6.144 bayt kullanır; bu nedenle 10 milyon vektör, indeks ek yükü hariç yaklaşık 61 GB gerektirir. Küçük ölçekte retrieval ucuz görünürken, corpus büyüdükten sonra bellek faturaları artıp sorgu süresi uzadığında bu sayı ekipleri hazırlıksız yakalar. Zor olan şudur: daha yüksek boyutlar bir veri kümesinde sıralamayı iyileştirebilirken, aynı ayar başka bir veri kümesinde depolamayı boşa harcayabilir ve gecikme ekleyebilir.
text-embedding-3-small Boyutları Açıklandı konusunun özü budur: her workload için kazanan evrensel bir ayar yoktur. Boyut büyüklüğünü, kendi relevance hedefinizi, p95 gecikme sınırınızı ve vektör depolama bütçenizi birlikte test ederek seçmeniz gerekir; tek tek değil. Yalnızca kalite için ayar yaparsanız maliyet hızla yükselir. Yalnızca boyutu küçültürseniz arama kalitesi kullanıcıların fark edeceği şekilde düşebilir.
Pratik bir seçim yöntemi göreceksiniz: küçük bir eval seti oluşturun, iki veya üç boyut büyüklüğünde relevance değerini karşılaştırın, uçtan uca yanıt süresini ölçün ve boyut sayısını milyon vektör başına gerçek depolama maliyetine dönüştürün. Bundan sonra doğru boyut, tahmin değil ölçülebilir bir mühendislik kararı haline gelir.
text-embedding-3-small İçinde "Boyutlar" Ne Anlama Gelir ve Sonuçları Neden Değiştirir?#
Basitçe söylemek gerekirse, text-embedding-3-small Boyutları Açıklandı tek bir anlama gelir: her vektörde ne kadar anlam tuttuğunuz. Boyut sayısı bir sıkıştırma düğmesidir, kalite anahtarı değil. text-embedding-3-small maksimum 1536 boyuta sahiptir (bilgi tabanındaki model spesifikasyonuna göre). Daha düşük boyutlar daha güçlü sıkıştırma yapar.
text-embedding-3-small boyutları açıklandı: semantik anlamdan sayısal vektörlere#
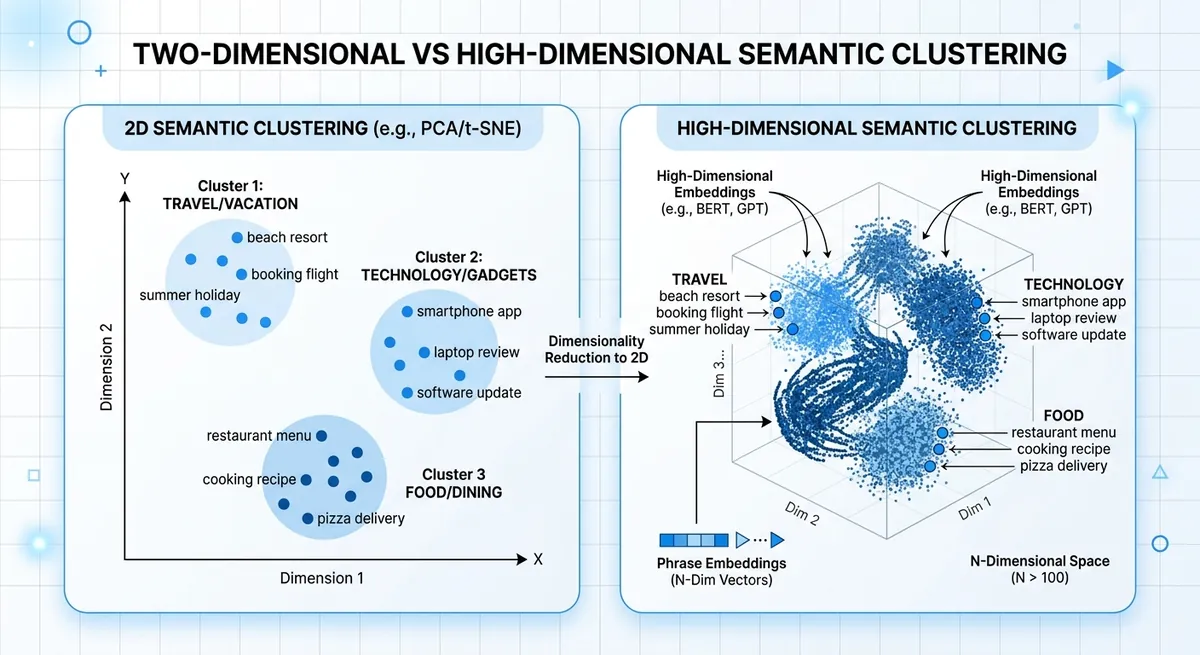
Bir embedding, benzer ifadelerin vektör uzayında birbirine yakın durması için metni sayılara dönüştürür. "Reset my password" ve "I cannot sign in" birbirine yakın konumlanmalıdır. Her ek boyut modele niyet, ton veya alan terimleri gibi nüansları saklamak için daha fazla alan verir. Vektörü küçültürseniz temel anlamı korur, ancak daha ince ayrıntıları kaybedersiniz.
text-embedding-3-small boyut büyüklüğü ve sıralama kalitesi değişimleri#
Daha düşük boyutlar aramayı hızlandırabilir ve depolamayı azaltabilir, ancak nearest-neighbor sıralaması değişebilir. Bu değişim, "cancel plan" ile "pause plan" gibi yüzeyde benzer görünen fakat eylem olarak farklı iki niyet olduğunda ortaya çıkar.
| Vektör boyutu seçimi | Semantik doğruluk | Çalışma zamanı hızı | 1M vektör başına depolama (float32) |
|---|---|---|---|
| 1536 (tam text-embedding-3-small) | En yüksek ayrıntı koruması | Daha küçük vektörlerden daha yavaş | ~6.1 GB |
| 768 (sıkıştırılmış) | Bir miktar ayrıntı kaybı | Daha hızlı | ~3.1 GB |
| 512 (sıkıştırılmış) | Yakın niyetlerde daha fazla kayıp riski | Daha da hızlı | ~2.0 GB |
Kaynak: text-embedding-3-small maksimum boyutu sağlanan bilgi tabanından; depolama hesabı boyut × 4 bayt üzerinden.
text-embedding-3-small Boyutları Açıklandı konusunun pratik özü budur: boyutları relevance testleri, p95 gecikme ve vektör depolamayla birlikte ayarlayın.
text-embedding-3-small Boyut Seçenekleri: Pratik Aralıklar ve Tradeoff'lar#
text-embedding-3-small için yerel vektör boyutu 1536 boyuttur. Gerçek sistemlerde ekipler RAM, disk ve ANN indeks yükünü azaltmak için vektörleri sık sık kısaltır. Depolama, boyut sayısıyla doğrusal olarak büyür; bu nedenle her boyut seçimi doğrudan bir maliyet ve gecikme seçimidir. text-embedding-3-small Boyutları Açıklandı konusunun pratik özü budur.
text-embedding-3-small Boyutları Açıklandı: yaygın ayarlar ve en uygun kullanım alanları#
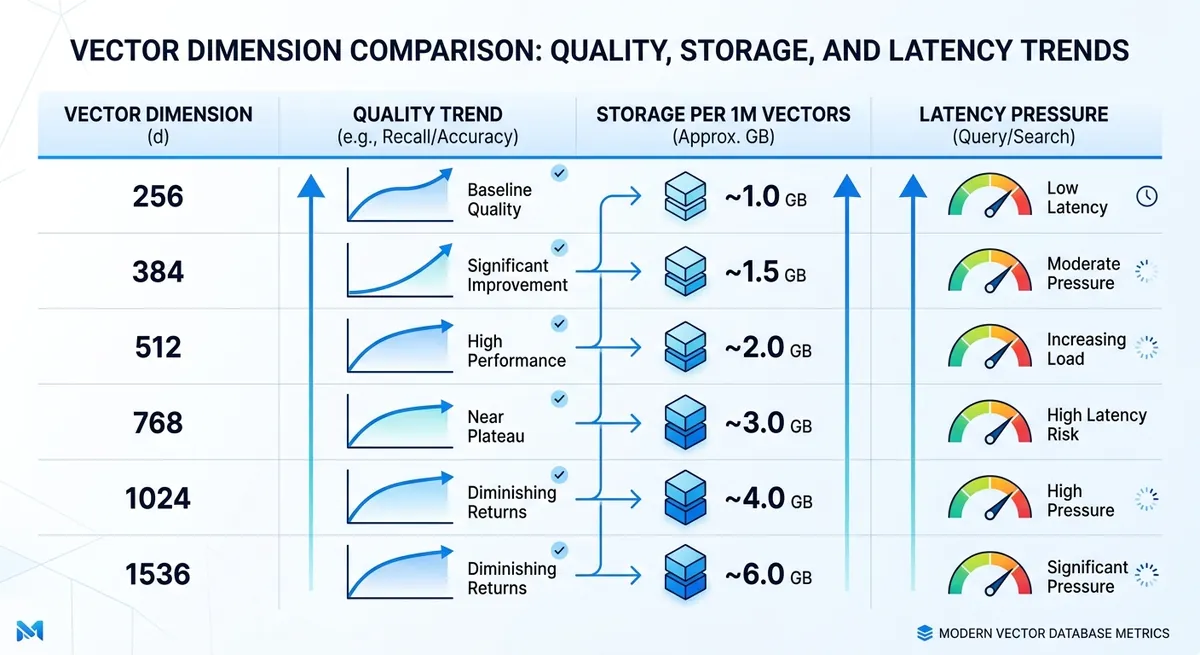
Kabaca varsayılanlara ihtiyacınız varsa, bu tablo A/B testleri için iyi bir başlangıç haritasıdır.
| Boyut | 1M vektör başına ham depolama (float32) | En uygun kullanım | Tipik risk |
|---|---|---|---|
| 256 | ~0.95 GB | Sıkı gecikme veya bütçe limitleri, basit niyet eşleştirme | Nüanslı sorgularda daha fazla kaçırma |
| 384 | ~1.43 GB | Kısa metinlerle maliyet odaklı semantik arama | Uç vakalarda daha düşük recall |
| 512 | ~1.91 GB | Destek dokümanları, ürün yardımı ve FAQ için dengeli arama | Bazı long-tail anlam kayıpları |
| 768 | ~2.86 GB | Dengeli-plus retrieval, karışık sorgu stilleri | Orta düzey altyapı maliyeti artışı |
| 1024 | ~3.81 GB | Yoğun dokümanlar üzerinde yüksek-recall RAG | Daha yüksek indeks belleği ve sorgu süresi |
| 1536 | ~5.72 GB | Tam doğruluklu retrieval, nüanslı benzerlik | En yüksek depolama ve gecikme baskısı |
Kaynak: boyut aralıkları sağlanan taslaktan ve model bilgisinden (text-embedding-3-small = 1536). Depolama, boyut × 4 bayt × 1.000.000 vektör olarak hesaplanmıştır.
text-embedding-3-small kalite tradeoff'ları: bozulma nerede başlar?#
Kalite kaybı genellikle precision ağırlıklı görevlerde daha erken görünür. FAQ retrieval 384 veya 512'de kullanılabilir kalabilirken, hukuki veya tıbbi arama ince anlam farklarını korumak için çoğu zaman 1024 veya 1536 gerektirir.
Dil karışımı da güvenli alt sınırı değiştirir. Tek dilli İngilizce workload'lar daha düşük boyutlarda dayanabilir. Çok dilli trafik, code-switching ve karışık yazı sistemleri, vektörler kısaldığında daha erken bozulma eğilimindedir.
Bu testi Crazyrouter üzerinden tek bir API anahtarıyla hızlıca çalıştırabilir ve aynı eval seti üzerinde 512, 768 ve 1536 için retrieval kalitesini karşılaştırabilirsiniz. Bu, tahmin yerine ölçülebilir bir eşik noktası verir.
Kalite, Gecikme ve Maliyet: Gerçekten İhtiyacınız Olan Üç Yönlü Benchmark#
Tek bir metriğin neden yanıltıcı olabileceğini zaten gördünüz. text-embedding-3-small Boyutları Açıklandı için pratik hamle, tek bir relevance hedefini, tek bir gecikme bütçesini ve tek bir depolama bütçesini aynı anda test etmektir. p95 gecikme limitiniz altında kalite eşiğinizi hâlâ geçen en küçük boyutu seçin.
text-embedding-3-small boyut test seti: güveneceğiniz offline relevance oluşturun#
Gerçek arama loglarını, destek taleplerini ve chat promptlarını kullanın. Yapabiliyorsanız 200-500 sorgu örneği oluşturun. Bu büyüklük, ekibinizi yavaşlatmadan zayıf noktaları ortaya çıkarmaya yeter.
Her sorgu için "iyi"nin ne anlama geldiğini etiketleyin. Etiketleri basit tutun: ilgili, kısmen ilgili, ilgili değil. Zor vakaları özellikle ekleyin: kısa sorgular, yazım hatalı sorgular, alan terimleri ve çok dilli sorgular. Uygulamanız karışık dillere hizmet veriyorsa aynı sete karışık dilli sorguları dahil edin.
Sonuçları yalnızca bir kişinin etiketlemesine izin vermeyin. İki değerlendirici yanlılığı hızla azaltır.
text-embedding-3-small boyutları benchmark metrikleri: kalite ve gecikme birlikte#
Sıralama kalitesini ve hızı tek bir çalıştırmada takip edin. Recall@k, doğru öğenin top-k içinde görünüp görünmediğini söyler. MRR ve nDCG, kullanıcıların tıkladığı üst sıralara yakın görünüp görünmediğini söyler.
Gecikme için yolu ayırın: embedding süresi ve retrieval süresi. Yalnızca ortalama gecikmeye değil, p95 ve p99'a bakın. Yavaş tail istekler kullanıcı deneyimini şekillendirir.
| Boyut adayı | Vektör başına bilinen boyut (float32) | Göreli indeks belleği | Takip edilecek kalite metrikleri | Takip edilecek gecikme metrikleri |
|---|---|---|---|---|
| 1536 (text-embedding-3-small) | 6,144 bytes | 1x baseline | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| 3072 (text-embedding-3-large) | 12,288 bytes | ~2x vs 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| Stack'inizdeki daha düşük boyutlu aday | dims × 4 bytes | dims / 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
Kaynak: model boyutları Crazyrouter model listesinden (text-embedding-3-small: 1536, text-embedding-3-large: 3072). Bayt hesabı float32 vektörleri kullanır.
text-embedding-3-small boyut maliyet modeli: depolamadan iş etkisine#
Rollout öncesinde boyutları paraya dönüştürün.
Milyon vektör başına depolama = dimension × 4 bytes × 1,000,000, ardından replica sayısıyla çarpın. Vektör veritabanınızdan gelen indeks ek yükünü ekleyin.
<.-- IMAGE: Boyut ve corpus büyüklüğüne göre vektör depolama ve yıllık maliyeti tahmin etmeye yönelik formül tarzı infografik. -->
Şimdi kalite artışını halihazırda takip ettiğiniz CTR, ticket deflection veya conversion gibi iş sinyallerine bağlayın. Daha büyük bir boyut nDCG'yi biraz yükseltiyor ancak belleği ikiye katlıyor ve p95'i kaçırıyorsa daha küçük ayarı koruyun. Ranked relevance değerini conversion'ı hareket ettirecek kadar yükseltiyorsa temiz bir iş gerekçeniz vardır.
Kullanım Alanına Göre Doğru Boyut Nasıl Seçilir?#
Boyut büyüklüğünü hâlâ tahmin ediyorsanız, text-embedding-3-small Boyutları Açıklandı bölümünün kestirme yolu şudur: boyutu workload ile eşleştirin, ardından rollout öncesinde küçük bir eval setiyle doğrulayın.
RAG ve kurumsal arama için text-embedding-3-small Boyutları Açıklandı#
RAG ve dahili arama, recall düştüğünde hızlı başarısız olur. Kullanıcılar bir soru sorar ve üst sonuçlar temel bilgileri kaçırırsa çıkar. Bu nedenle başlangıç noktanız depolama değil kalite olmalıdır.
text-embedding-3-small için baseline olarak 1536 kullanın, ardından yalnızca zor sorgularda recall değerini doğruladıktan sonra daha düşük bir boyutu test edin. Zor sorgular uzun sorular, nadir terimler ve karışık niyet anlamına gelir.
Chunking sonucu insanların beklediğinden daha fazla değiştirir. Küçük chunk'lar artı düşük boyutlar bağlamı iki kez kaybedebilir: bir kez bölmede, bir kez embedding'de. Chunk'larınız kısaysa daha yüksek boyutları koruyun. Chunk'larınız uzun ve temizse kör risk almadan daha düşük bir boyutu test edebilirsiniz.
Öneriler, kümeleme ve semantik yönlendirme için text-embedding-3-small boyutları#
Bu sistemler genellikle mükemmel top-1 recall'dan çok hız ve istikrarlı gruplamaya önem verir. Orta seviye bir ayar çoğu zaman en iyi tradeoff'u verir.
Yönlendirme için yaklaşık benzerlik çoğu zaman yeterlidir, çünkü ikinci aşama model yeniden sıralama veya doğrulama yapabilir. Bu, RAG'de yapacağınızdan daha erken düşük boyutları test edebileceğiniz anlamına gelir. Kümeleme için yalnızca tek bir offline çalıştırmayı değil, haftalık veri boyunca cluster purity ve drift'i değerlendirin.
Downstream metriğinizi iki tam trafik döngüsü boyunca hâlâ stabil tutan en küçük boyutu seçin.
Çok dilli ve alana özgü workload'lar için text-embedding-3-small Boyutları Açıklandı#
Alan dili oyunu değiştirir. Hukuki, tıbbi veya donanım terimleri düz dilde yakın görünebilir ama anlam olarak uzak olabilir. Daha düşük boyutlar bu sınırları bulanıklaştırabilir.
Çok dilli trafik dil başına kontrol gerektirir. Her şeyi tek bir skorda ortalamayın. Aynı niyet setini her büyük dil segmentinde çalıştırın, sonra kaçırma kalıplarını karşılaştırın. İngilizcede çalışan bir boyut, karışık dilli sorgularda veya transliterasyonlu terimlerde başarısız olabilir.
| Kullanım alanı | Önerilen başlangıç boyutu | Düşürmeden önce ölçülecekler | Yaygın başarısızlık işareti |
|---|---|---|---|
| RAG / kurumsal arama | 1536 | Zor sorgularda recall, cevap grounding | Doğru doküman üst sonuçlarda değil |
| Öneriler | Orta (1536 altında test edin) | CTR veya conversion stabilitesi | Benzer ama ilgisiz öğeler yükselir |
| Semantik yönlendirme | Orta ila düşük | Route accuracy + fallback rate | Yanlış route, daha yüksek fallback |
| Çok dilli / domain-heavy | 1536 | Dil başına recall, terim düzeyi hatalar | Nadir terimler genel anlama eşlenir |
Kaynak: model boyut bilgisi Crazyrouter model listesinden (text-embedding-3-small: 1536, text-embedding-3-large: 3072). <.-- IMAGE: Kullanım alanına göre karar matrisi (RAG, recsys, routing, multilingual) ve önerilen başlangıç boyutları. -->
Uygulama Kılavuzu: API, Vektör Şeması ve Migration Adımları#
API isteklerinde text-embedding-3-small boyutları açıklandı#
text-embedding-3-small için güvenli baseline 1536 boyuttur. dimensions alanıyla daha küçük bir boyut isteyebilirsiniz, ancak bu boyutu indeks başına sabit tutun. Doküman vektörleri 1024, sorgu vektörleri 1536 kullanıyorsa, iki çağrı da başarılı olsa bile retrieval kalitesi drift eder.
Yazma ve okuma path'leri için tek bir config değeri kullanın, ardından her istekte doğrulayın: input text boş değil, vektör uzunluğu yapılandırılmış boyuta eşit ve her değer gerçek bir sayı (NaN yok, Inf yok). Doğrulama başarısız olursa öğeyi retry queue'ya yönlendirin ve varsayılan boyutunuzla yeniden embed edin.
OpenAI SDK'yı https://ai.crazyrouter.us/v1 gibi uyumlu bir endpoint ile kullanabilir, ardından model ve dimensions değerlerini tüm servisler tarafından kullanılan tek bir paylaşılan config dosyasında sabitleyebilirsiniz.
Vektör şeması ve indeks tasarımında text-embedding-3-small boyut kontrolü#
İndeks başına tek bir boyut tutun ve sorgu ile doküman vektörlerini aynı boyutta tutun.
kb_d1536_v1 ve kb_d1024_v1 gibi boyut kilitli collection adları kullanın. Bu adlandırma migration'ları okunabilir tutar ve sessiz karışımı önler.
<.-- IMAGE: Ingestion, embedding servisi, çift vektör indeksleri ve query router gösteren mimari diyagram. -->
Boyut değiştiğinde indeks ayarlarını yeni vektörlerle yeniden oluşturun. HNSW için rebuild sonrasında graph ve search ayarlarını yeniden tune edin. IVF için centroid'leri yeni boyut büyüklüğündeki vektörler üzerinde yeniden eğitin. Eski indeks training verisini yeniden kullanmak recall'a zarar verebilir.
Eski modellerden migration için text-embedding-3-small boyutları açıklandı#
Migration'ı aşamalar halinde çalıştırın:
| Aşama | Write path | Read path | Kontrol edilecekler |
|---|---|---|---|
| Dual-write | Old + new embeddings | Old index | Write success rate ve vector validation errors |
| Shadow-read | Old + new embeddings | User sees old, logs new | Top-k overlap, latency, bad query cases |
| Cutover | Old + new embeddings | New index | Relevance pass rate ve p95 latency target |
| Rollback | Keep dual-write active | Switch back to old | Trigger on error spike or relevance drop |
Kaynak: Crazyrouter bilgi tabanı (text-embedding-3-small 1536 boyutta; OpenAI-compatible API; 300+ desteklenen model).
text-embedding-3-small Boyutları Açıklandı konusunun pratik özü budur: boyutları kilitleyin, shadow traffic ile test edin ve yalnızca ölçülmüş parity sonrasında cut over yapın.
Production Operasyonları: Drift, Kalite Regresyonları ve Ekip Workflow'unu İzleme#
Offline testlerle bir boyut büyüklüğü seçtiniz. İyi başlangıç. Asıl risk daha sonra, yeni içerik, yeni sorgu karışımı ve sıralama kaymaları production'a ulaştığında ortaya çıkar. text-embedding-3-small Boyutları Açıklandı içinde uzun vadeli kalite sıkı bir döngüden gelir: sabit eval verisi, canlı davranış kontrolleri ve kontrollü rollout adımları.
text-embedding-3-small boyut drift monitoring kurun#
Her boyut değişikliğinden önce eval setinizi ve metriklerinizi kilitleyin. Gerçek kullanıcı niyetiyle eşleşen bir golden query seti tutun, ardından her hafta aynı rubrikle skorlayın. Bunu canlı sinyallerle eşleştirerek drift'i destek talepleri birikmeden erken yakalayın.
| Sinyal | Drift nasıl görünür | İnceleme sıklığı | Aksiyon tetikleyicisi |
|---|---|---|---|
| Golden set relevance score | Üst sonuçlar bilinen iyi cevaplarla eşleşmeyi bırakır | Haftalık scorecard | Son stabil çalıştırmaya göre düşüş |
| Retrieval bloklarında CTR | Kullanıcılar önerilen dokümanlara daha az tıklar | Günlük | Sürekli düşüş |
| Task success rate | Daha fazla oturum hedef görevi bitiremez | Günlük | Segmente göre downtrend |
| No-result rate | Boş retrieval yanıtları artar | Günlük | Deploy sonrası spike |
Tablo kaynağı: bu bölümde kullanılan operational runbook pattern'i (sağlanan taslaktan golden set + online metrics).
<.-- IMAGE: Haftalık golden-set score, CTR trend, no-result rate ve alert thresholds gösteren dashboard mock'u -->
text-embedding-3-small boyut deneylerini staging ve production'da güvenli çalıştırın#
Son 7 ila 14 günden yeniden oynatılan sorgularla staging'de başlayın. Canary dilimiyle production'a geçin, ardından kullanıcı segmenti ve bölgeye göre genişletin. Rollback'i hazır tutun. Kalite düşerse trafik büyümesini duraklatın, son stabil boyuta geçin ve hangi sorgu türlerinin başarısız olduğunu loglayın. Bu, incident'ları kısa tutar ve sonraki test için temiz veri sağlar.
text-embedding-3-small Boyutları Açıklandı deneyleri için ekip workflow'u#
Ekipler arası değerlendirme, insanlar karışık tarayıcı oturumlarında test yaptığı için sık sık bozulur. SEO, ürün ve ML birbirlerinin durumunu ezebilir; sonra kimse sonuca güvenmez. Her rolün aynı build'i session conflict veya account crossover olmadan test etmesi için DICloak izole profillerini kullanabilirsiniz.
DICloak gibi araçlar profil başına sabit proxy ve session kuralları ayarlamanıza olanak tanır. Bu, "US-English account" ve "EU account" testlerinizin her seferinde stabil ağ koşullarında çalışması anlamına gelir. Yeniden üretilebilir kurulum, boyuta dayalı sıralama kontrollerini ekip arkadaşları arasında karşılaştırmayı kolaylaştırır ve süregelen text-embedding-3-small Boyutları Açıklandı çalışması için tekrarlanabilir, güvenli bir yol sağlar.
Yaygın Hatalar ve Son Boyut Seçim Kontrol Listesi#
Buraya kadar okuduysanız, text-embedding-3-small Boyutları Açıklandı bir tahminle değil, launch kararıyla bitmelidir.
Production'ı bozan text-embedding-3-small boyut hataları#
| Hata | Ne ters gider | Ne yapılmalı |
|---|---|---|
| Yalnızca vendor benchmark skorlarına güvenirsiniz | Testlerde arama iyi görünür, ancak gerçek sorgularınız niyeti kaçırır | Gerçek kullanıcı sorgularından dahili bir eval seti oluşturun, ardından her boyut ayarını bu sette skorlayın |
| Depolama maliyetini düşürür ve kalite kontrollerini atlarsınız | Daha düşük vektör boyutu para tasarrufu sağlar, ancak tıklama kalitesi düşer ve destek talepleri artar | Rollout öncesinde retrieval kalitesini ve kullanıcı davranışını birlikte takip edin |
| Yalnızca relevance test edersiniz | Hızlı indeks ayarları p95 hedefinizi yine de kaçırabilir | Uçtan uca gecikmeyi ölçün: embed + index search + rerank |
text-embedding-3-small Boyutları Açıklandı go-live için son 10 maddelik kontrol listesi#
- Kaynak verideki kopyaları ve bozuk metinleri temizleyin.
- Benchmark'ınızda head, mid ve tail sorguları kapsayın.
- En az iki boyutu karşılaştırın: 1536 (text-embedding-3-small) ve 3072 (text-embedding-3-large).
- Aynı sorgu setinde her boyut için top-k relevance kaydedin.
- API çağrısından son sıralanmış sonuca kadar p95 gecikmeyi kaydedin.
- Boyut sayısını milyon vektör başına depolama maliyetine dönüştürün.
- Gerçek trafik ve başarı metrikleriyle bir canary çalıştırın.
- Tam rollout öncesinde rollback adımlarını hazırlayın.
- Monitoring ve alert response için tek bir owner atayın.
- Retraining veya re-embedding inceleme sıklığı belirleyin.
Yalnızca relevance, p95 gecikme ve depolama maliyeti birlikte geçtiğinde yayına alın.
<.-- IMAGE: Embedding boyut kararları için tek sayfalık launch checklist grafiği. -->
Sıkça Sorulan Sorular#
text-embedding-3-small Boyutları Açıklandı içinde başlamak için en iyi varsayılan boyut nedir?#
Çoğu ekip için pratik başlangıç noktası 512'dir; içeriğiniz karmaşıksa (hukuki, teknik, uzun biçimli dokümanlar) 1024 tercih edilebilir. text-embedding-3-small Boyutları Açıklandı içinde bu, erken aşamada aşırı taahhüt vermeden kalite, hız ve maliyet arasında güçlü bir denge sağlar. Ardından gerçek kullanıcı sorgularınız ve beklenen filtrelerinizle küçük bir benchmark çalıştırın. Oyuncak bir testte en iyi görüneni değil, relevance hedefinizi hâlâ karşılayan en küçük boyutu seçin.
text-embedding-3-small Boyutları Açıklandı içinde boyutları düşürmek retrieval kalitesini her zaman azaltır mı?#
Daha düşük boyutlar sonuçlara her zaman anlamlı şekilde zarar vermez. Kısa FAQ araması veya dar domain'ler için düşüş küçük olabilir. Geniş kataloglar, çok dilli içerik veya nüanslı semantik eşleştirme için kalite daha hızlı düşebilir. text-embedding-3-small Boyutları Açıklandı içinde boyutu bir tuning düğmesi olarak ele alın: 256, 512 ve 1024'ü aynı sorgu setinde karşılaştırın. Gerçek kullanıcılarınız için kabul edilebilir Recall@k ve sıralama kalitesini koruyan en küçük boyutu tutun.
text-embedding-3-small boyutları vektör veritabanı maliyetini nasıl etkiler?#
Maliyet, boyut sayısıyla kabaca doğrusal ölçeklenir. Vektörleri 1024'ten 512'ye düşürürseniz ham vektör depolama yaklaşık yarıya iner. Aynı eğilim RAM kullanımı ve çoğu zaman sorgu compute için de geçerlidir. Ancak indeks ek yükünü dahil edin: ANN yapıları graph link'leri, metadata ve dahili bookkeeping için bellek ekler. Dolayısıyla toplam tasarruf güçlüdür, ancak yalnızca vektör baytlarından ibaret değildir. Pratikte, son boyutu belirlemeden önce yalnızca embedding boyutunu değil, tam indeks boyutunu tahmin edin.
Boyutları değiştirirken tüm dokümanları yeniden embed etmem gerekir mi?#
Evet. Bir boyutta oluşturulmuş bir vektör, tutarlı tek bir indekste başka bir boyuttaki vektörlerle karıştırılamaz. Boyutları değiştirdiğinizde tüm dokümanları yeniden embed edin ve indeksi yeniden oluşturun. Production sistemleri için daha güvenli bir migration kullanın: dual-index rollout çalıştırın. Yeni indeksi paralel oluşturun, trafiğin bir dilimini ona gönderin, kalite ve gecikmeyi karşılaştırın, ardından tamamen geçiş yapın. Bu, downtime'ı önler ve geçiş sırasında arama davranışını stabil tutar.
Boyutları karşılaştırırken hangi metrikleri takip etmeliyim?#
Üç grubu takip edin: relevance, hız ve maliyet. Relevance için etiketli bir sorgu setinde Recall@k, nDCG ve MRR kullanın. Hız için p50/p95/p99 gecikmeyi izleyin, çünkü tail latency kullanıcı deneyimini etkiler. Maliyet için milyon doküman başına depolama, RAM footprint ve 1.000 sorgu başına maliyeti ölçün. text-embedding-3-small Boyutları Açıklandı içinde bu scorecard, depolamadan tasarruf edip sıralama kalitesine fazla zarar verdiğiniz tek taraflı seçimlerden kaçınmanıza yardımcı olur.
text-embedding-3-small düşük boyutlarda çok dilli arama için uygun mu?#
Çalışabilir, ancak çok dilli arama tek dilli aramadan daha sıkı test gerektirir. Daha düşük boyutlar, özellikle kısa sorgular ve karışık yazı sistemlerinde diller arasındaki ince anlamları birleştirebilir. 512 veya 1024 ile başlayın, ardından dil çifti, sorgu uzunluğu ve alan terimlerine göre test edin. text-embedding-3-small Boyutları Açıklandı içinde çok dilli kurulumlar, precision önemli olduğunda çoğu zaman daha büyük boyutlardan fayda görür. Her önemli dil segmenti için relevance hedeflerini hâlâ karşılayan en küçük ayarı seçin.
Temel çıkarım şudur: text-embedding-3-small boyutları pratik bir tuning kaldıraçıdır; daha yüksek boyutlar semantik doğruluğu iyileştirebilirken, daha düşük boyutlar depolama, gecikme ve maliyeti azaltır. Bu nedenle doğru seçim retrieval kalite hedeflerinize ve sistem kısıtlarınıza bağlıdır. Varsayılanlara güvenmek yerine kendi veriniz üzerinde recall, sıralama kalitesi ve uçtan uca performansı benchmark ederek boyut büyüklüğünü ampirik bir karar olarak ele alın. Bu hafta kendi pipeline'ınızda birden fazla boyutu test edin, ardından production ayarınızı tahminle değil kanıtla kilitleyin.
Implementation Guides
Available in other languages: