简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
text-embedding-3-small Dimensjoner Forklart: Hvordan Velge Riktig Størrelse for Kvalitet og Kostnad
En praktisk guide til text-embedding-3-small dimensjoner, hvordan velge mellom 256, 512, 1024, og 1536 dimensjoner.
text-embedding-3-small Dimensjoner Forklart: Hvordan Velge Riktig Størrelse for Kvalitet og Kostnad#
Ved 1536 dimensjoner bruker én text-embedding-3-small-vektor lagret som float32 6,144 byte, så 10 millioner vektorer trenger omtrent 61 GB før indeks-overhead. Det tallet overrasker team når retrieval virker billig i liten skala, men minnekostnadene øker og spørringstiden vokser etter at korpuset utvides. Det vanskelige er at høyere dimensjoner kan forbedre rangeringen på ett datasett, mens den samme innstillingen kan sløse med lagring og legge til latenstid på et annet.
Det er kjernen i text-embedding-3-small Dimensjoner Forklart: det finnes ingen universell innstilling som vinner på alle arbeidslaster. Du må velge dimensjonsstørrelse ved å teste ditt eget relevansmål, din p95-latensgrense og ditt budsjett for vektorlagring samlet, ikke ett og ett. Hvis du bare optimaliserer for kvalitet, stiger kostnaden raskt. Hvis du bare kutter størrelsen, kan søkekvaliteten falle på måter brukerne merker.
Du får se en praktisk utvelgelsesmetode: bygg et lite evalueringssett, sammenlign relevans ved to eller tre dimensjonsstørrelser, mål ende-til-ende-responstid, og gjør dimensjonsantall om til reell lagringskostnad per million vektorer. Derfra blir riktig størrelse et målbart teknisk valg, ikke gjetning.
Hva "dimensjoner" betyr i text-embedding-3-small (og hvorfor det endrer resultatene)#
Enkelt sagt betyr text-embedding-3-small Dimensjoner Forklart én ting: hvor mye mening du beholder i hver vektor. Dimensjonsantall er en komprimeringsknott, ikke en kvalitetsbryter. text-embedding-3-small har en maksimal størrelse på 1536 dimensjoner (fra modellspesifikasjonen i kunnskapsbasen). Lavere størrelser komprimerer hardere.
text-embedding-3-small-dimensjoner forklart: semantisk mening til numeriske vektorer#
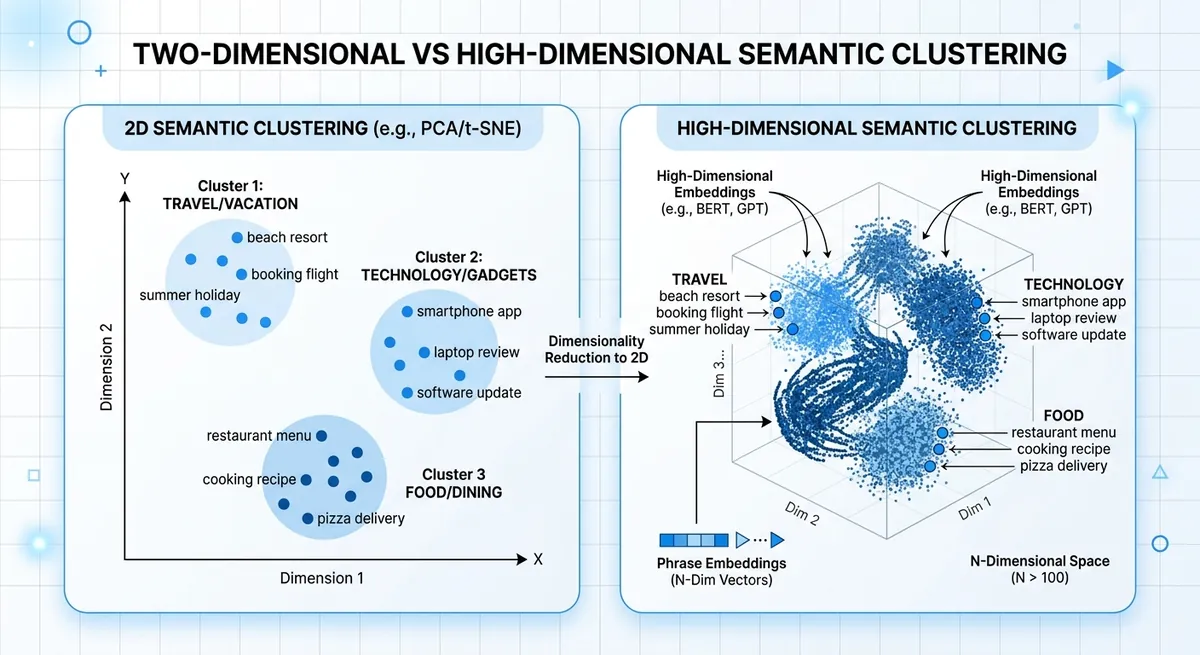
En embedding gjør tekst om til tall slik at lignende fraser ligger nær hverandre i vektorrommet. "Reset my password" og "I cannot sign in" bør havne nær hverandre. Hver ekstra dimensjon gir modellen mer rom til å lagre nyanser som intensjon, tone eller domenebegreper. Hvis du krymper vektoren, beholder du kjernemeningen, men mister finere detaljer.
text-embedding-3-small-dimensjonsstørrelse og endringer i rangeringskvalitet#
Lavere dimensjoner kan gjøre søk raskere og redusere lagring, men nærmeste-nabo-rangeringen kan forskyves. Den forskyvningen blir synlig når to intensjoner ser like ut på overflaten, men krever ulike handlinger, som "cancel plan" kontra "pause plan."
| Valg av vektorstørrelse | Semantisk presisjon | Kjørehastighet | Lagring per 1M vektorer (float32) |
|---|---|---|---|
| 1536 (full text-embedding-3-small) | Høyest detaljbevaring | Tregere enn mindre vektorer | ~6.1 GB |
| 768 (komprimert) | Noe detaljtap | Raskere | ~3.1 GB |
| 512 (komprimert) | Større risiko for tap ved nærliggende intensjoner | Enda raskere | ~2.0 GB |
Kilde: maksimal dimensjon for text-embedding-3-small fra oppgitt kunnskapsbase; lagringsberegning fra dimensjoner × 4 byte.
Det er den praktiske kjernen i text-embedding-3-small Dimensjoner Forklart: juster dimensjoner med relevanstester, p95-latens og vektorlagring samlet.
Dimensjonsalternativer for text-embedding-3-small: praktiske intervaller og avveininger#
For text-embedding-3-small er den native vektorstørrelsen 1536 dimensjoner. I reelle systemer forkorter team ofte vektorer for å redusere RAM, disk og ANN-indeksbelastning. Lagring vokser lineært med dimensjonsantall, så hvert størrelsesvalg er et direkte valg for kostnad og latenstid. Dette er den praktiske kjernen i text-embedding-3-small Dimensjoner Forklart.
text-embedding-3-small Dimensjoner Forklart: vanlige innstillinger og best egnede bruksområder#
Hvis du trenger grove standardvalg, er denne tabellen et godt startkart for A/B-tester.
| Dimensjon | Rå lagring per 1M vektorer (float32) | Passer best til | Typisk risiko |
|---|---|---|---|
| 256 | ~0.95 GB | Stramme latenstids- eller budsjettgrenser, enkel intensjonsmatching | Flere bom på nyanserte spørringer |
| 384 | ~1.43 GB | Kostnadsfokusert semantisk søk med korte tekster | Lavere recall på randtilfeller |
| 512 | ~1.91 GB | Balansert søk for supportdokumenter, produkthjelp, FAQ | Noe tap av long-tail-mening |
| 768 | ~2.86 GB | Balansert-pluss-retrieval, blandede spørringsstiler | Moderat vekst i infrastrukturkostnad |
| 1024 | ~3.81 GB | High-recall RAG over tette dokumenter | Høyere indeksminne og spørringstid |
| 1536 | ~5.72 GB | Retrieval med full presisjon, nyansert likhet | Høyest press på lagring og latenstid |
Kilde: dimensjonsintervaller fra oppgitt disposisjon og modellinformasjon (text-embedding-3-small = 1536). Lagring er beregnet som dimensjoner × 4 byte × 1,000,000 vektorer.
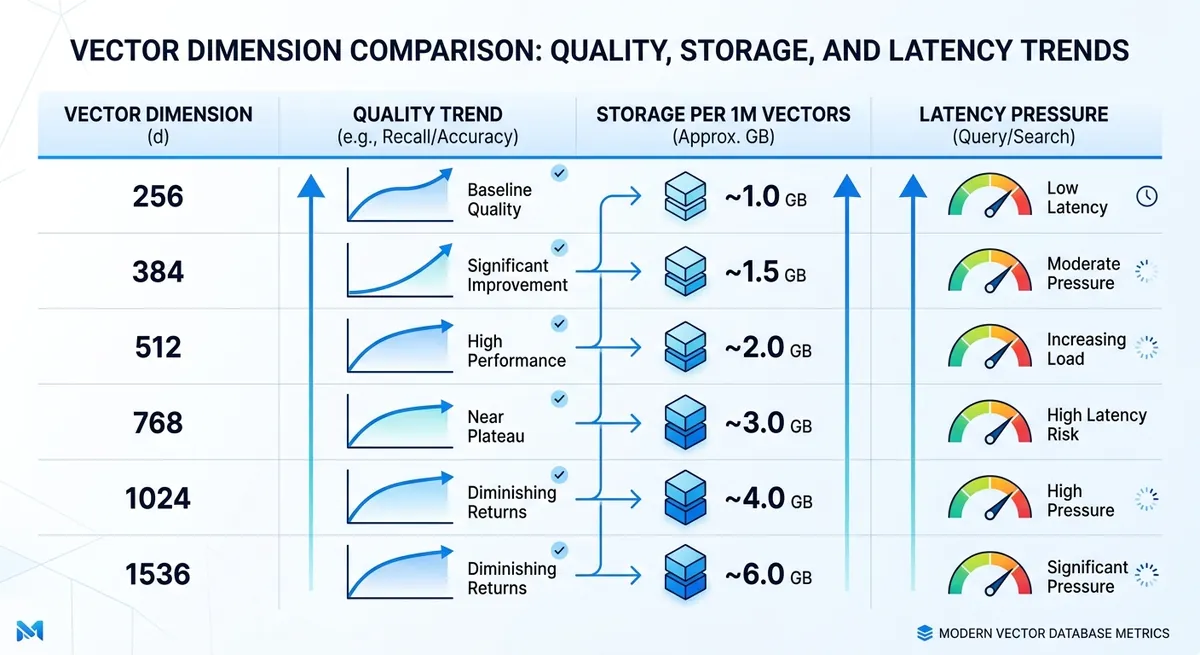
Kvalitetsavveininger for text-embedding-3-small: hvor degradering starter#
Kvalitetstap dukker vanligvis opp tidligere på presisjonstunge oppgaver. FAQ-retrieval kan forbli brukbart ved 384 eller 512, mens juridisk eller medisinsk søk ofte trenger 1024 eller 1536 for å bevare fine meningsforskjeller.
Språkmiks endrer også det trygge minimumsnivået. Enspråklige engelske arbeidslaster kan holde seg godt ved lavere størrelser. Flerspråklig trafikk, code-switching og blandede skriftsystemer har en tendens til å degradere tidligere når vektorene blir korte.
Du kan kjøre denne testen raskt gjennom Crazyrouter med én API-nøkkel og sammenligne retrieval-kvalitet ved 512, 768 og 1536 på det samme evalueringssettet. Det gir et målbart knekkpunkt i stedet for gjetning.
Kvalitet, latenstid og kostnad: treveis-benchmarken du faktisk trenger#
Du har allerede sett hvorfor én enkelt metrikk kan villede. For text-embedding-3-small Dimensjoner Forklart er det praktiske grepet å teste ett relevansmål, ett latenstidsbudsjett og ett lagringsbudsjett samtidig. Velg den minste dimensjonen som fortsatt klarer kvalitetskravet ditt innenfor p95-latensgrensen.
Testsett for text-embedding-3-small-dimensjon: bygg offline-relevans du stoler på#
Bruk ekte søkelogger, supportsaker og chat-prompter. Bygg 200–500 spørringseksempler hvis du kan. Den størrelsen er nok til å avdekke svake punkter uten å bremse teamet.
Merk hva "godt" betyr for hver spørring. Hold etikettene enkle: relevant, delvis relevant, ikke relevant. Legg bevisst til vanskelige tilfeller: korte spørringer, spørringer med skrivefeil, domenebegreper og flerspråklige spørringer. Hvis appen din betjener blandede språk, ta med spørringer med blandede språk i samme sett.
Ikke la bare én person merke resultater. To gjennomlesere reduserer bias raskt.
Benchmark-metrikker for text-embedding-3-small-dimensjoner: kvalitet og latenstid sammen#
Spor rangeringskvalitet og hastighet i én kjøring. Recall@k forteller deg om riktig element vises i top-k. MRR og nDCG forteller deg om det vises nær toppen, der brukere klikker.
For latenstid, del opp flyten: embedding-tid og retrieval-tid. Følg med på p95 og p99, ikke bare gjennomsnittlig latenstid. Trege haleforespørsler former brukeropplevelsen.
| Dimensjonskandidat | Kjent størrelse per vektor (float32) | Relativt indeksminne | Kvalitetsmetrikker å spore | Latenstidsmetrikker å spore |
|---|---|---|---|---|
| 1536 (text-embedding-3-small) | 6,144 bytes | 1x baseline | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| 3072 (text-embedding-3-large) | 12,288 bytes | ~2x vs 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| Kandidat med lavere dimensjon i stacken din | dims × 4 bytes | dims / 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
Kilde: modelldimensjoner fra Crazyrouter-modellisten (text-embedding-3-small: 1536, text-embedding-3-large: 3072). Byte-beregning bruker float32-vektorer.
Kostnadsmodell for text-embedding-3-small-dimensjon: fra lagring til forretningseffekt#
Gjør dimensjoner om til penger før utrulling.
Lagring per million vektorer = dimension × 4 bytes × 1,000,000, og multipliser deretter med antall replikaer. Legg til indeks-overhead fra vektordatabasen din.
<.-- IMAGE: Infografikk i formelstil for å estimere vektorlagring og årlig kostnad etter dimensjon og korpusstørrelse. -->
Knytt deretter kvalitetsløftet til forretningssignaler du allerede sporer, som CTR, ticket deflection eller konvertering. Hvis en større dimensjon løfter nDCG litt, men dobler minnet og ikke klarer p95, behold den mindre innstillingen. Hvis den løfter rangert relevans nok til å flytte konvertering, har du et tydelig forretningscase.
Hvordan velge riktig dimensjon etter bruksområde#
Hvis du fortsatt gjetter dimensjonsstørrelse, er denne delen av text-embedding-3-small Dimensjoner Forklart snarveien: koble dimensjon til arbeidslast, og verifiser deretter med et lite evalueringssett før utrulling.
text-embedding-3-small Dimensjoner Forklart for RAG og enterprise search#
RAG og internt søk feiler raskt når recall faller. Brukere stiller ett spørsmål og forsvinner hvis toppresultatene mangler nøkkelfakta. Derfor bør startpunktet ditt være kvalitet, ikke lagring.
Bruk 1536 som baseline for text-embedding-3-small, og test deretter bare én lavere størrelse etter at du har bekreftet recall på vanskelige spørringer. Vanskelige spørringer betyr lange spørsmål, sjeldne termer og blandet intensjon.
Chunking endrer resultatet mer enn folk forventer. Små chunks pluss lave dimensjoner kan miste kontekst to ganger: én gang i oppdelingen, én gang i embedding. Hvis chunkene dine er korte, behold høyere dimensjoner. Hvis chunkene dine er lange og rene, kan du teste en lavere størrelse uten blind risiko.
text-embedding-3-small-dimensjoner for anbefalinger, klynging og semantisk ruting#
Disse systemene bryr seg vanligvis om hastighet og stabil gruppering, ikke perfekt top-1 recall. En middels innstilling gir ofte den beste avveiningen.
For ruting er omtrentlig likhet ofte nok fordi en modell i et andre steg kan re-rangere eller verifisere. Det betyr at du kan teste lavere dimensjoner tidligere enn du ville gjort i RAG. For klynging bør du vurdere klyngepuritet og drift på tvers av ukentlige data, ikke bare én offline-kjøring.
Velg den minste dimensjonen som fortsatt holder nedstrømsmetrikken stabil i to fulle trafikksykluser.
text-embedding-3-small Dimensjoner Forklart for flerspråklige og domenespesifikke arbeidslaster#
Domenespråk endrer spillet. Juridiske, medisinske eller maskinvaretermer kan ligge nær hverandre i vanlig språk, men langt fra hverandre i betydning. Lavere dimensjoner kan gjøre disse grensene uklare.
Flerspråklig trafikk trenger kontroller per språk. Ikke gjennomsnitt alt inn i én score. Kjør det samme intensjonssettet på tvers av hvert store språksegment, og sammenlign deretter bommønstre. En størrelse som fungerer på engelsk, kan feile på spørringer med blandede språk eller translittererte termer.
| Bruksområde | Anbefalt startdimensjon | Hva du bør måle før du senker | Vanlig feiltegn |
|---|---|---|---|
| RAG / enterprise search | 1536 | Recall på vanskelige spørringer, svarforankring | Riktig dokument er ikke i toppresultatene |
| Anbefalinger | Middels (test under 1536) | Stabilitet i CTR eller konvertering | Lignende, men irrelevante elementer stiger |
| Semantisk ruting | Middels til lavere | Rutepresisjon + fallback-rate | Feil rute, høyere fallback |
| Flerspråklig / domenetungt | 1536 | Recall per språk, feil på termnivå | Sjeldne termer mappes til generisk mening |
Kilde: modelldimensjonsinformasjon fra Crazyrouter-modellisten (text-embedding-3-small: 1536, text-embedding-3-large: 3072). <.-- IMAGE: Beslutningsmatrise etter bruksområde (RAG, recsys, ruting, flerspråklig) med anbefalte startdimensjoner. -->
Implementeringsguide: API, vektorskjema og migrasjonstrinn#
text-embedding-3-small-dimensjoner forklart i API-forespørsler#
Den trygge baseline for text-embedding-3-small er 1536 dimensjoner. Du kan be om en mindre størrelse med feltet dimensions, men hold den størrelsen fast per indeks. Hvis dokumentvektorer bruker 1024 og spørringsvektorer bruker 1536, vil retrieval-kvaliteten drive selv om begge kallene lykkes.
Bruk én konfigurasjonsverdi for skrive- og lesestier, og valider deretter på hver forespørsel: input-tekst er ikke tom, vektorlengden er lik konfigurert dimensjon, og hver verdi er et reelt tall (ingen NaN, ingen Inf). Hvis validering feiler, send elementet til en retry-kø og embed på nytt med standardstørrelsen din.
Du kan bruke OpenAI SDK med et kompatibelt endepunkt som https://ai.crazyrouter.us/v1, og deretter pinne modell og dimensjoner i én delt konfigurasjonsfil som brukes av alle tjenester.
text-embedding-3-small-dimensjonskontroll i vektorskjema og indeksdesign#
Hold én dimensjon per indeks, og hold spørrings- og dokumentvektorer på samme størrelse.
Bruk dimensjonslåste samlingsnavn som kb_d1536_v1 og kb_d1024_v1. Denne navngivningen gjør migrasjoner lesbare og hindrer stille blanding.
<.-- IMAGE: Arkitekturdiagram som viser ingestion, embedding-tjeneste, doble vektorindekser og query router. -->
Når dimensionaliteten endres, bygg indeksinnstillingene på nytt med de nye vektorene. For HNSW må du retune graf- og søkeinnstillinger etter rebuild. For IVF må du trene sentroider på nytt på vektorer fra den nye dimensjonsstørrelsen. Gjenbruk av gamle indekstreningsdata kan skade recall.
text-embedding-3-small-dimensjoner forklart for migrasjon fra eldre modeller#
Kjør migrasjon i faser:
| Fase | Skrivebane | Lesebane | Hva du bør sjekke |
|---|---|---|---|
| Dual-write | Old + new embeddings | Old index | Write success rate and vector validation errors |
| Shadow-read | Old + new embeddings | User sees old, logs new | Top-k overlap, latency, bad query cases |
| Cutover | Old + new embeddings | New index | Relevance pass rate and p95 latency target |
| Rollback | Keep dual-write active | Switch back to old | Trigger on error spike or relevance drop |
Kilde: Crazyrouter-kunnskapsbase (text-embedding-3-small med 1536 dimensjoner; OpenAI-kompatibelt API; 300+ støttede modeller).
Dette er den praktiske kjernen i text-embedding-3-small Dimensjoner Forklart: lås dimensjoner, test med shadow-trafikk, og cut over først etter målt paritet.
Produksjonsdrift: overvåking av drift, kvalitetsregresjoner og teamarbeidsflyt#
Du valgte en dimensjonsstørrelse med offline-tester. God start. Reell risiko dukker opp senere, etter at nytt innhold, ny spørringsmiks og rangeringsforskyvninger treffer produksjon. I text-embedding-3-small Dimensjoner Forklart kommer langsiktig kvalitet fra en stram sløyfe: faste evalueringsdata, sjekker av live-atferd og kontrollerte utrullingstrinn.
Sett opp drift-overvåking for text-embedding-3-small-dimensjon#
Lås evalueringssettet og metrikkene før hver dimensjonsendring. Hold et golden query-sett som matcher ekte brukerintensjon, og score det deretter hver uke med samme rubrikk. Kombiner det med live-signaler slik at du fanger drift tidlig, ikke etter at supportsaker hoper seg opp.
| Signal | Slik ser drift ut | Gjennomgangsfrekvens | Handlingsutløser |
|---|---|---|---|
| Relevansscore for golden set | Toppresultater slutter å matche kjente gode svar | Ukentlig scorecard | Fall mot siste stabile kjøring |
| CTR på retrieval-blokker | Brukere klikker mindre på foreslåtte dokumenter | Daglig | Vedvarende nedgang |
| Oppgavesuksessrate | Flere økter klarer ikke å fullføre måloppgaven | Daglig | Nedtrend per segment |
| No-result rate | Tomme retrieval-svar øker | Daglig | Spike etter deploy |
Tabellkilde: operasjonelt runbook-mønster brukt i denne delen (golden set + online-metrikker fra oppgitt disposisjon).
<.-- IMAGE: dashboard-mockup som viser ukentlig golden-set-score, CTR-trend, no-result rate og alert-terskler -->
Kjør text-embedding-3-small-dimensjonseksperimenter trygt i staging og produksjon#
Start i staging med replayede spørringer fra de siste 7 til 14 dagene. Gå til produksjon med en canary-andel, og utvid deretter etter brukersegment og region. Hold rollback klar. Hvis kvaliteten faller, stopp trafikkveksten, bytt til siste stabile dimensjon, og logg hvilke spørringstyper som feilet. Dette holder hendelser korte og gir rene data til neste test.
Teamarbeidsflyt for eksperimenter med text-embedding-3-small Dimensjoner Forklart#
Evaluering på tvers av team bryter ofte sammen fordi folk tester i blandede nettleserøkter. SEO, produkt og ML kan overskrive hverandres tilstand, og da stoler ingen på resultatet. Du kan bruke isolerte profiler i DICloak slik at hver rolle tester samme build uten øktkonflikter eller kontokryssing.
Verktøy som DICloak lar deg sette faste proxy- og øktregler per profil. Det betyr at testene for "US-English account" og "EU account" kjører under stabile nettverksforhold hver gang. Reproduserbart oppsett gjør dimensjonsbaserte rangeringssjekker lettere å sammenligne på tvers av teammedlemmer, og det gir en repeterbar, sikker vei for løpende arbeid med text-embedding-3-small Dimensjoner Forklart.
Vanlige feil og en endelig sjekkliste for valg av dimensjon#
Hvis du har lest så langt, bør text-embedding-3-small Dimensjoner Forklart ende i en lanseringsbeslutning, ikke en gjetning.
Feil med text-embedding-3-small-dimensjon som ødelegger produksjon#
| Feil | Hva som går galt | Hva du bør gjøre |
|---|---|---|
| Du stoler bare på leverandørens benchmark-scorer | Søk ser bra ut i tester, men de ekte spørringene dine bommer på intensjon | Bygg et internt evalueringssett fra ekte brukerspørringer, og score deretter hver dimensjonsinnstilling på det settet |
| Du kutter lagringskostnad og hopper over kvalitetssjekker | Lavere vektorstørrelse sparer penger, men klikkvaliteten faller og supportsaker øker | Spor retrieval-kvalitet og brukeratferd sammen før utrulling |
| Du tester bare relevans | Raske indeksinnstillinger kan fortsatt feile p95-målet ditt | Mål ende-til-ende-latens: embed + index search + rerank |
Endelig 10-punkts sjekkliste for go-live med text-embedding-3-small Dimensjoner Forklart#
- Rens duplikater og ødelagt tekst i kildedata.
- Dekk head-, mid- og tail-spørringer i benchmarken din.
- Sammenlign minst to størrelser: 1536 (text-embedding-3-small) og 3072 (text-embedding-3-large).
- Registrer top-k-relevans for hver størrelse på samme spørringssett.
- Registrer p95-latens fra API-kall til endelig rangert resultat.
- Gjør dimensjonsantall om til lagringskostnad per million vektorer.
- Kjør en canary med ekte trafikk og suksessmetrikker.
- Forbered rollback-trinn før full utrulling.
- Tildel én eier for overvåking og alert-respons.
- Sett en gjennomgangsfrekvens for retrening eller re-embedding.
Ship bare når relevans, p95-latens og lagringskostnad består samlet.
<.-- IMAGE: Énsides lanseringssjekklistegrafikk for beslutninger om embedding-dimensjoner. -->
Ofte stilte spørsmål#
I text-embedding-3-small Dimensjoner Forklart, hva er den beste standarddimensjonen å starte med?#
Et praktisk startpunkt er 512 for de fleste team, eller 1024 hvis innholdet ditt er komplekst (juridisk, teknisk, lange dokumenter). I text-embedding-3-small Dimensjoner Forklart gir dette en sterk balanse mellom kvalitet, hastighet og kostnad uten å forplikte deg for mye tidlig. Kjør deretter en liten benchmark med de ekte brukerspørringene dine og forventede filtre. Velg den minste dimensjonen som fortsatt møter relevansmålet ditt, ikke bare den som ser best ut i en leketest.
Reduserer lavere dimensjoner i text-embedding-3-small Dimensjoner Forklart alltid retrieval-kvaliteten?#
Lavere dimensjoner skader ikke alltid resultatene på en meningsfull måte. For korte FAQ-søk eller smale domener kan fallet være lite. For brede kataloger, flerspråklig innhold eller nyansert semantisk matching kan kvaliteten falle raskere. I text-embedding-3-small Dimensjoner Forklart bør du behandle dimensjon som en justeringsknott: sammenlign 256, 512 og 1024 på samme spørringssett. Behold den minste størrelsen som bevarer akseptabel Recall@k og rangeringskvalitet for de ekte brukerne dine.
Hvordan påvirker text-embedding-3-small-dimensjoner kostnaden for vektordatabaser?#
Kostnaden skalerer omtrent lineært med dimensjonsantall. Hvis du kutter vektorer fra 1024 til 512, blir rå vektorlagring omtrent halvparten. Den samme trenden gjelder RAM-bruk og ofte spørringsberegning. Men ta med indeks-overhead: ANN-strukturer legger til minne for graflenker, metadata og intern bokføring. Så totalbesparelsen er sterk, men handler ikke bare om vektorbytene. I praksis bør du estimere full indeksstørrelse, ikke bare embedding-størrelse, før du setter en endelig dimensjon.
Må jeg re-embedde alle dokumenter når jeg endrer dimensjoner?#
Ja. En vektor bygget med én dimensjon kan ikke blandes med vektorer fra en annen dimensjon i én konsistent indeks. Når du endrer dimensjoner, må du re-embedde alle dokumenter og bygge indeksen på nytt. For produksjonssystemer bør du bruke en tryggere migrasjon: kjør en utrulling med dual-index. Bygg den nye indeksen parallelt, send en andel trafikk til den, sammenlign kvalitet og latenstid, og bytt deretter helt over. Dette unngår nedetid og holder søkeatferden stabil under overgangen.
Hvilke metrikker bør jeg spore når jeg sammenligner dimensjoner?#
Spor tre grupper: relevans, hastighet og kostnad. For relevans bruker du Recall@k, nDCG og MRR på et merket spørringssett. For hastighet følger du med på p50/p95/p99-latens, siden hale-latens påvirker brukeropplevelsen. For kostnad måler du lagring per million dokumenter, RAM-avtrykk og kostnad per 1,000 spørringer. I text-embedding-3-small Dimensjoner Forklart hjelper dette scorecardet deg å unngå ensidige valg der du sparer lagring, men skader rangeringskvaliteten for mye.
Er text-embedding-3-small egnet for flerspråklig søk ved lavere dimensjoner?#
Det kan fungere, men flerspråklig søk trenger strengere testing enn enspråklig søk. Lavere dimensjoner kan slå sammen subtile betydninger på tvers av språk, særlig for korte spørringer og blandede skriftsystemer. Start på 512 eller 1024, og test deretter etter språkpar, spørringslengde og domenebegreper. I text-embedding-3-small Dimensjoner Forklart har flerspråklige oppsett ofte nytte av større dimensjoner når presisjon er viktig. Velg den minste innstillingen som fortsatt møter relevansmålene for hvert viktige språksegment.
Hovedpoenget er at dimensjoner i text-embedding-3-small er en praktisk justeringsmekanisme: høyere dimensjoner kan forbedre semantisk presisjon, mens lavere dimensjoner reduserer lagring, latenstid og kostnad, så riktig valg avhenger av målene dine for retrieval-kvalitet og systembegrensningene dine. Behandle dimensjonsstørrelse som en empirisk beslutning ved å benchmarke recall, rangeringskvalitet og ende-til-ende-ytelse på dine egne data i stedet for å stole på standardverdier. Test flere dimensjoner i din egen pipeline denne uken, og lås deretter produksjonsinnstillingen med bevis, ikke gjetning.
Implementation Guides
Available in other languages: