简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
text-embedding-3-small dimensioner: Vælg den rigtige størrelse
En praktisk guide til text-embedding-3-small dimensioner, hvordan du vælger mellem 256, 512, 1024 og 1536 dimensioner.
text-embedding-3-small dimensioner: Vælg den rigtige størrelse#
Ved 1536 dimensioner bruger én text-embedding-3-small-vektor gemt som float32 6,144 bytes, så 10 millioner vektorer kræver cirka 61 GB før indeks-overhead. Det tal overrasker ofte teams, når retrieval virker billigt i lille skala, men hukommelsesregningerne stiger, og forespørgselstiden vokser, efterhånden som korpusset udvides. Det svære er, at højere dimensioner kan forbedre rangeringen på ét datasæt, mens den samme indstilling kan spilde lagerplads og tilføje latency på et andet.
Det er kernen i text-embedding-3-small Dimensions Explained: Der findes ingen universel indstilling, der vinder på alle workloads. Du skal vælge dimensionsstørrelse ved at teste dit eget relevansmål, din p95-latencygrænse og dit budget for vektorlager samlet, ikke hver for sig. Hvis du kun optimerer efter kvalitet, stiger omkostningerne hurtigt. Hvis du kun reducerer størrelsen, kan søgekvaliteten falde på måder, brugerne bemærker.
Du får her en praktisk metode til valg: byg et lille evalueringssæt, sammenlign relevans ved to eller tre dimensionsstørrelser, mål end-to-end svartid, og omregn antallet af dimensioner til reel lageromkostning pr. million vektorer. Derfra bliver den rigtige størrelse et målbart ingeniørvalg, ikke gætværk.
Hvad "dimensioner" betyder i text-embedding-3-small (og hvorfor det ændrer resultater)#
Kort sagt betyder text-embedding-3-small Dimensions Explained én ting: hvor meget betydning du bevarer i hver vektor. Antallet af dimensioner er en komprimeringsknap, ikke en kvalitetskontakt. text-embedding-3-small har en maksimal størrelse på 1536 dimensioner (fra modelspecifikationen i vidensbasen). Lavere størrelser komprimerer hårdere.
text-embedding-3-small dimensioner forklaret: semantisk betydning til numeriske vektorer#
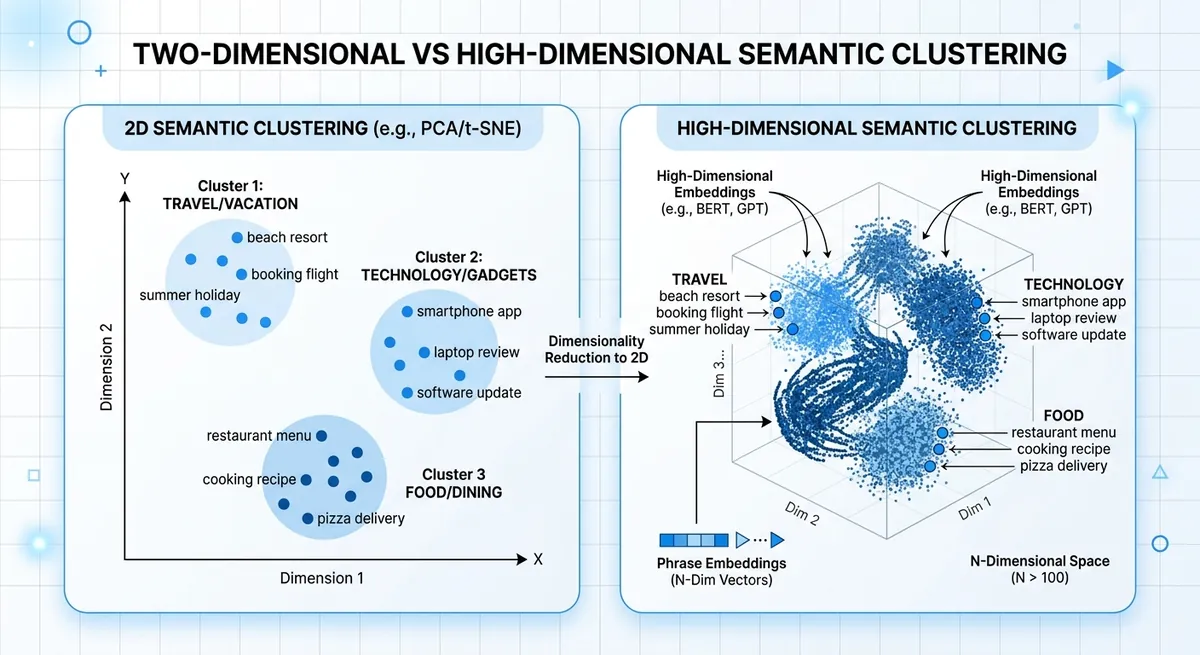
En embedding omsætter tekst til tal, så lignende fraser ligger tæt på hinanden i vektorrummet. "Reset my password" og "I cannot sign in" bør ende tæt på hinanden. Hver ekstra dimension giver modellen mere plads til at gemme nuancer som intention, tone eller domæneudtryk. Hvis du gør vektoren mindre, bevarer du kernebetydningen, men mister finere detaljer.
text-embedding-3-small dimensionsstørrelse og ændringer i rangeringskvalitet#
Lavere dimensioner kan gøre søgning hurtigere og reducere lagerforbrug, men nearest-neighbor-rangeringen kan flytte sig. Den forskydning viser sig, når to intentioner ligner hinanden på overfladen, men kræver forskellige handlinger, som "cancel plan" kontra "pause plan."
| Valg af vektorstørrelse | Semantisk trofasthed | Køretidshastighed | Lager pr. 1M vektorer (float32) |
|---|---|---|---|
| 1536 (fuld text-embedding-3-small) | Højeste detaljefastholdelse | Langsommere end mindre vektorer | ~6.1 GB |
| 768 (komprimeret) | Noget detaljetab | Hurtigere | ~3.1 GB |
| 512 (komprimeret) | Større tabsrisiko ved nærliggende intentioner | Endnu hurtigere | ~2.0 GB |
Kilde: text-embedding-3-small maksimal dimension fra den leverede vidensbase; lagerberegning fra dimensioner × 4 bytes.
Det er den praktiske kerne i text-embedding-3-small Dimensions Explained: finjuster dimensioner med relevanstests, p95-latency og vektorlager samlet.
text-embedding-3-small dimensionsmuligheder: praktiske intervaller og afvejninger#
For text-embedding-3-small er den native vektorstørrelse 1536 dimensioner. I virkelige systemer forkorter teams ofte vektorer for at reducere RAM, disk og ANN-indeksbelastning. Lagerforbrug vokser lineært med antallet af dimensioner, så hvert valg af størrelse er et direkte valg om omkostning og latency. Det er den praktiske kerne i text-embedding-3-small Dimensions Explained.
text-embedding-3-small Dimensions Explained: almindelige indstillinger og bedst egnede use cases#
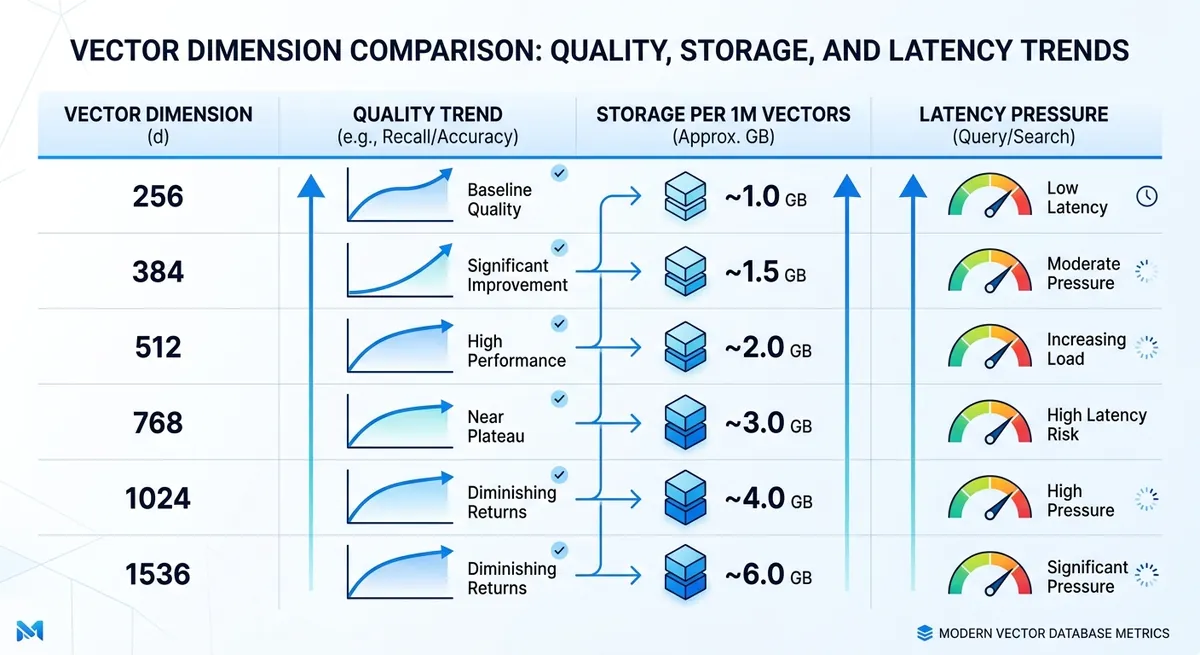
Hvis du har brug for grove standardvalg, er denne tabel et godt startkort til A/B-tests.
| Dimension | Råt lager pr. 1M vektorer (float32) | Bedst egnet til | Typisk risiko |
|---|---|---|---|
| 256 | ~0.95 GB | Stramme latency- eller budgetgrænser, simpel intentionsmatching | Flere misses på nuancerede forespørgsler |
| 384 | ~1.43 GB | Omkostningsfokuseret semantisk søgning med korte tekster | Lavere recall på edge cases |
| 512 | ~1.91 GB | Balanceret søgning til supportdokumenter, produkthjælp, FAQ | Noget long-tail-betydningstab |
| 768 | ~2.86 GB | Balanced-plus retrieval, blandede forespørgselsstile | Moderat vækst i infrastrukturomkostninger |
| 1024 | ~3.81 GB | High-recall RAG over tætte dokumenter | Højere indekshukommelse og forespørgselstid |
| 1536 | ~5.72 GB | Retrieval med fuld trofasthed, nuanceret lighed | Højeste pres på lager og latency |
Kilde: dimensionsintervaller fra den leverede disposition og modelinfo (text-embedding-3-small = 1536). Lager beregnes som dimensioner × 4 bytes × 1,000,000 vektorer.
text-embedding-3-small kvalitetsafvejninger: hvor degradering starter#
Kvalitetstab viser sig normalt tidligere på præcisionstunge opgaver. FAQ-retrieval kan forblive brugbar ved 384 eller 512, mens juridisk eller medicinsk søgning ofte kræver 1024 eller 1536 for at bevare fine betydningsforskelle.
Sprogblanding ændrer også den sikre nedre grænse. Ensprogede engelske workloads kan klare sig ved lavere størrelser. Flersproget trafik, code-switching og blandede skriftsystemer har tendens til at degradere tidligere, når vektorer bliver korte.
Du kan køre denne test hurtigt gennem Crazyrouter med én API-nøgle og sammenligne retrieval-kvalitet ved 512, 768 og 1536 på det samme evalueringssæt. Det giver et målbart cutoff-punkt i stedet for gætværk.
Kvalitet, latency og omkostning: den trevejsbenchmark, du faktisk har brug for#
Du har allerede set, hvorfor én metrisk værdi kan vildlede. For text-embedding-3-small Dimensions Explained er det praktiske greb at teste ét relevansmål, ét latencybudget og ét lagerbudget på samme tid. Vælg den mindste dimension, der stadig klarer din kvalitetsbar under din p95-latencygrænse.
text-embedding-3-small dimensionstest-sæt: byg offline-relevans, du stoler på#
Brug rigtige søgelogs, supporttickets og chatprompts. Byg 200–500 forespørgselseksempler, hvis du kan. Den størrelse er nok til at afsløre svage punkter uden at bremse dit team.
Label, hvad "god" betyder for hver forespørgsel. Hold labels simple: relevant, delvist relevant, ikke relevant. Tilføj bevidst svære cases: korte forespørgsler, forespørgsler med tastefejl, domæneudtryk og flersprogede forespørgsler. Hvis din app betjener blandede sprog, så inkluder blandetsprogede forespørgsler i det samme sæt.
Lad ikke kun én person label resultater. To reviewere reducerer hurtigt bias.
text-embedding-3-small dimensionsbenchmark-metrikker: kvalitet og latency sammen#
Spor rangeringskvalitet og hastighed i én kørsel. Recall@k fortæller dig, om det rigtige element vises i top-k. MRR og nDCG fortæller dig, om det vises tæt på toppen, hvor brugerne klikker.
For latency skal du opdele stien: embedding-tid og retrieval-tid. Hold øje med p95 og p99, ikke kun gennemsnitlig latency. Langsomme tail-requests former brugeroplevelsen.
| Dimensionskandidat | Kendt størrelse pr. vektor (float32) | Relativ indekshukommelse | Kvalitetsmetrikker at spore | Latencymetrikker at spore |
|---|---|---|---|---|
| 1536 (text-embedding-3-small) | 6,144 bytes | 1x baseline | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| 3072 (text-embedding-3-large) | 12,288 bytes | ~2x vs 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| Kandidat med lavere dimension i din stack | dims × 4 bytes | dims / 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
Kilde: modeldimensioner fra Crazyrouter-modellisten (text-embedding-3-small: 1536, text-embedding-3-large: 3072). Byteberegningen bruger float32-vektorer.
text-embedding-3-small dimensionsomkostningsmodel: fra lager til forretningspåvirkning#
Omregn dimensioner til penge før rollout.
Lager pr. million vektorer = dimension × 4 bytes × 1,000,000, og gang derefter med antallet af replikaer. Tilføj indeks-overhead fra din vektordatabase.
<.-- IMAGE: Formelbaseret infografik til estimering af vektorlager og årlige omkostninger efter dimension og korpusstørrelse. -->
Knyt derefter kvalitetsløftet til forretningssignaler, du allerede sporer, som CTR, ticket deflection eller konvertering. Hvis en større dimension løfter nDCG en smule, men fordobler hukommelsen og misser p95, så behold den mindre indstilling. Hvis den løfter rangeret relevans nok til at flytte konvertering, har du en ren business case.
Sådan vælger du den rigtige dimension efter use case#
Hvis du stadig gætter på dimensionsstørrelse, er denne del af text-embedding-3-small Dimensions Explained genvejen: map dimension til workload, og verificer derefter med et lille evalueringssæt før rollout.
text-embedding-3-small Dimensions Explained for RAG og enterprise search#
RAG og intern søgning fejler hurtigt, når recall falder. Brugere stiller ét spørgsmål og forlader flowet, hvis topresultaterne mangler nøglefakta. Derfor bør dit udgangspunkt være kvalitet, ikke lager.
Brug 1536 som baseline for text-embedding-3-small, og test derefter kun én lavere størrelse, efter du har bekræftet recall på svære forespørgsler. Svære forespørgsler betyder lange spørgsmål, sjældne udtryk og blandet intention.
Chunking ændrer resultatet mere, end mange forventer. Små chunks plus lave dimensioner kan miste kontekst to gange: én gang i opdelingen, én gang i embedding. Hvis dine chunks er korte, så behold højere dimensioner. Hvis dine chunks er lange og rene, kan du teste en lavere størrelse uden blind risiko.
text-embedding-3-small dimensioner til anbefalinger, clustering og semantisk routing#
Disse systemer går normalt mere op i hastighed og stabile grupperinger end perfekt top-1 recall. En mellemindstilling giver ofte den bedste afvejning.
Til routing er approksimativ lighed ofte nok, fordi en second-stage model kan re-ranke eller verificere. Det betyder, at du kan teste lavere dimensioner tidligere, end du ville i RAG. Til clustering skal du vurdere cluster purity og drift på tværs af ugentlige data, ikke kun én offline-kørsel.
Vælg den mindste dimension, der stadig holder din downstream-metrik stabil gennem to fulde trafikcyklusser.
text-embedding-3-small Dimensions Explained for flersprogede og domænespecifikke workloads#
Domænesprog ændrer spillet. Juridiske, medicinske eller hardwareudtryk kan ligge tæt i almindeligt sprog, men langt fra hinanden i betydning. Lavere dimensioner kan udviske disse grænser.
Flersproget trafik kræver kontroller pr. sprog. Lad være med at gennemsnitte alt til én score. Kør det samme intentionssæt på tværs af hvert større sprogsegment, og sammenlign derefter mønstre for misses. En størrelse, der virker på engelsk, kan fejle på blandetsprogede forespørgsler eller translittererede udtryk.
| Use case | Anbefalet startdimension | Hvad du skal måle før sænkning | Almindeligt fejlsignal |
|---|---|---|---|
| RAG / enterprise search | 1536 | Recall på svære forespørgsler, svar-grounding | Korrekt dokument er ikke i topresultater |
| Anbefalinger | Medium (test under 1536) | CTR- eller konverteringsstabilitet | Lignende, men irrelevante elementer stiger |
| Semantisk routing | Medium til lavere | Rutenøjagtighed + fallback-rate | Forkert rute, højere fallback |
| Flersproget / domænetung | 1536 | Recall pr. sprog, fejl på termniveau | Sjældne udtryk mappes til generisk betydning |
Kilde: modeldimensionsinfo fra Crazyrouter-modellisten (text-embedding-3-small: 1536, text-embedding-3-large: 3072). <.-- IMAGE: Beslutningsmatrix efter use case (RAG, recsys, routing, multilingual) med anbefalede startdimensioner. -->
Implementeringsguide: API, vektorskema og migrationstrin#
text-embedding-3-small dimensioner forklaret i API-requests#
Den sikre baseline for text-embedding-3-small er 1536 dimensioner. Du kan anmode om en mindre størrelse med feltet dimensions, men hold den størrelse fast pr. indeks. Hvis dokumentvektorer bruger 1024, og query-vektorer bruger 1536, vil retrieval-kvaliteten drive, selv hvis begge kald lykkes.
Brug én konfigurationsværdi til write- og read-paths, og valider derefter på hver request: inputtekst må ikke være tom, vektorlængden skal matche den konfigurerede dimension, og hver værdi skal være et reelt tal (ingen NaN, ingen Inf). Hvis valideringen fejler, så send elementet til en retry-kø og re-embed med din standardstørrelse.
Du kan bruge OpenAI SDK med et kompatibelt endpoint som https://ai.crazyrouter.us/v1 og derefter pinne model og dimensioner i én fælles konfigurationsfil, som bruges af alle services.
text-embedding-3-small dimensionsstyring i vektorskema og indeksdesign#
Hold én dimension pr. indeks, og hold query- og dokumentvektorer på den samme størrelse.
Brug dimensionslåste collection-navne som kb_d1536_v1 og kb_d1024_v1. Denne navngivning gør migrationer læsbare og forhindrer stille sammenblanding.
<.-- IMAGE: Arkitekturdiagram, der viser ingestion, embedding service, dobbelte vektorindekser og query router. -->
Når dimensionalitet ændres, skal indeksindstillingerne genopbygges med de nye vektorer. For HNSW skal graf- og søgeindstillinger retunes efter genopbygningen. For IVF skal centroids genoplæres på vektorer fra den nye dimensionsstørrelse. Genbrug af gamle indeks-træningsdata kan skade recall.
text-embedding-3-small dimensioner forklaret for migration fra ældre modeller#
Kør migrationen i faser:
| Fase | Write path | Read path | Hvad du skal kontrollere |
|---|---|---|---|
| Dual-write | Gamle + nye embeddings | Gammelt indeks | Write success rate og vektorvalideringsfejl |
| Shadow-read | Gamle + nye embeddings | Brugeren ser gammelt, logger nyt | Top-k overlap, latency, dårlige query-cases |
| Cutover | Gamle + nye embeddings | Nyt indeks | Relevance pass rate og p95-latencymål |
| Rollback | Hold dual-write aktiv | Skift tilbage til gammelt | Trigger ved error spike eller relevansfald |
Kilde: Crazyrouter-vidensbase (text-embedding-3-small ved 1536 dimensioner; OpenAI-kompatibel API; 300+ understøttede modeller).
Det er den praktiske kerne i text-embedding-3-small Dimensions Explained: lås dimensioner, test med shadow traffic, og cut over først efter målt paritet.
Produktionsdrift: overvågning af drift, kvalitetsregressioner og teamworkflow#
Du har valgt en dimensionsstørrelse med offline-tests. God start. Den reelle risiko viser sig senere, efter nyt indhold, ny query-mix og rangeringsskift rammer produktion. I text-embedding-3-small Dimensions Explained kommer langsigtet kvalitet fra en stram loop: faste evalueringsdata, live adfærdskontroller og kontrollerede rollout-trin.
Opsæt overvågning af text-embedding-3-small dimension drift#
Lås dit evalueringssæt og dine metrikker før hver dimensionsændring. Hold et golden query set, der matcher reel brugerintention, og scor det derefter hver uge med samme rubric. Kombiner det med live-signaler, så du opdager drift tidligt, ikke først når supporttickets hober sig op.
| Signal | Hvordan drift ser ud | Review-kadence | Handlings-trigger |
|---|---|---|---|
| Golden set-relevansscore | Topresultater stopper med at matche kendt-gode svar | Ugentlig scorecard | Fald vs seneste stabile kørsel |
| CTR på retrieval-blokke | Brugere klikker mindre på foreslåede dokumenter | Dagligt | Vedvarende fald |
| Task success rate | Flere sessioner fuldfører ikke målhandling | Dagligt | Nedadgående trend pr. segment |
| No-result rate | Tomme retrieval-svar stiger | Dagligt | Spike efter deploy |
Tabelkilde: operational runbook-mønster brugt i dette afsnit (golden set + online metrikker fra den leverede disposition).
<.-- IMAGE: Dashboard-mock, der viser ugentlig golden-set-score, CTR-trend, no-result rate og alarmtærskler -->
Kør text-embedding-3-small dimensionseksperimenter sikkert i staging og produktion#
Start i staging med replayede forespørgsler fra de seneste 7 til 14 dage. Gå videre til produktion med et canary-slice, og udvid derefter efter brugersegment og region. Hold rollback klar. Hvis kvaliteten falder, så stop trafikvæksten midlertidigt, skift til den seneste stabile dimension, og log hvilke query-typer der fejlede. Det holder incidents korte og giver rene data til den næste test.
Teamworkflow for text-embedding-3-small Dimensions Explained-eksperimenter#
Evaluering på tværs af teams bryder ofte sammen, fordi folk tester i blandede browsersessioner. SEO, product og ML kan overskrive hinandens state, og så stoler ingen på resultatet. Du kan bruge DICloak isolerede profiler, så hver rolle tester det samme build uden sessionskonflikter eller account crossover.
Værktøjer som DICloak lader dig sætte faste proxy- og sessionsregler pr. profil. Det betyder, at dine "US-English account"- og "EU account"-tests kører under stabile netværksforhold hver gang. Reproducerbart setup gør dimensionsbaserede rangeringskontroller lettere at sammenligne på tværs af teammedlemmer, og det giver dig en gentagelig, sikker vej til løbende text-embedding-3-small Dimensions Explained-arbejde.
Almindelige fejl og en afsluttende tjekliste til dimensionsvalg#
Hvis du har læst hertil, bør text-embedding-3-small Dimensions Explained ende i en launch-beslutning, ikke et gæt.
text-embedding-3-small dimensionsfejl, der ødelægger produktion#
| Fejl | Hvad der går galt | Hvad du skal gøre |
|---|---|---|
| Du stoler kun på vendor benchmark-scores | Søgning ser fin ud i tests, men dine rigtige forespørgsler misser intention | Byg et internt evalueringssæt fra rigtige brugerforespørgsler, og scor derefter hver dimensionsindstilling på det sæt |
| Du reducerer lageromkostning og springer kvalitetskontroller over | Lavere vektorstørrelse sparer penge, men klikkvaliteten falder, og supporttickets stiger | Spor retrieval-kvalitet og brugeradfærd samlet før rollout |
| Du tester kun relevans | Hurtige indeksindstillinger kan stadig fejle dit p95-mål | Mål end-to-end latency: embed + index search + rerank |
Afsluttende 10-punkts tjekliste til text-embedding-3-small Dimensions Explained go-live#
- Rens dubletter og ødelagt tekst i kildedata.
- Dæk head-, mid- og tail-forespørgsler i din benchmark.
- Sammenlign mindst to størrelser: 1536 (text-embedding-3-small) og 3072 (text-embedding-3-large).
- Registrer top-k-relevans for hver størrelse på det samme forespørgselssæt.
- Registrer p95-latency fra API-kald til endeligt rangeret resultat.
- Omregn dimension count til lageromkostning pr. million vektorer.
- Kør en canary med reel trafik og success metrics.
- Forbered rollback-trin før fuld rollout.
- Tildel én owner til overvågning og alarmrespons.
- Fastlæg en kadence for retraining eller re-embedding review.
Ship kun, når relevans, p95-latency og lageromkostning består samlet.
<.-- IMAGE: En-sides launch checklist-grafik for beslutninger om embedding-dimensioner. -->
Ofte stillede spørgsmål#
I text-embedding-3-small Dimensions Explained, hvad er den bedste standarddimension at starte med?#
Et praktisk udgangspunkt er 512 for de fleste teams, eller 1024 hvis dit indhold er komplekst (juridiske, tekniske eller lange dokumenter). I text-embedding-3-small Dimensions Explained giver det en stærk balance mellem kvalitet, hastighed og omkostning uden at binde sig for hårdt tidligt. Kør derefter en lille benchmark med dine rigtige brugerforespørgsler og forventede filtre. Vælg den mindste dimension, der stadig opfylder dit relevansmål, ikke bare den der ser bedst ud i en legetøjstest.
Reducerer lavere dimensioner i text-embedding-3-small Dimensions Explained altid retrieval-kvalitet?#
Lavere dimensioner skader ikke altid resultaterne på en meningsfuld måde. For kort FAQ-søgning eller snævre domæner kan faldet være lille. For brede kataloger, flersproget indhold eller nuanceret semantisk matching kan kvaliteten falde hurtigere. I text-embedding-3-small Dimensions Explained skal du behandle dimension som en tuning-knap: sammenlign 256, 512 og 1024 på det samme forespørgselssæt. Behold den mindste størrelse, der bevarer acceptabel Recall@k og rangeringskvalitet for dine rigtige brugere.
Hvordan påvirker text-embedding-3-small dimensioner omkostningen i en vektordatabase?#
Omkostningen skalerer omtrent lineært med antallet af dimensioner. Hvis du reducerer vektorer fra 1024 til 512, er råt vektorlager cirka halvt så stort. Den samme tendens gælder RAM-forbrug og ofte query compute. Men medregn indeks-overhead: ANN-strukturer tilføjer hukommelse til graph links, metadata og intern bookkeeping. Så de samlede besparelser er stærke, men handler ikke kun om vektorbytes. I praksis bør du estimere den fulde indeksstørrelse, ikke kun embedding-størrelsen, før du fastsætter en endelig dimension.
Skal jeg re-embedde alle dokumenter, når jeg ændrer dimensioner?#
Ja. En vektor bygget ved én dimension kan ikke blandes med vektorer fra en anden dimension i ét konsistent indeks. Når du ændrer dimensioner, skal du re-embedde alle dokumenter og genopbygge indekset. For produktionssystemer skal du bruge en mere sikker migration: kør en dual-index rollout. Byg det nye indeks parallelt, send et slice trafik til det, sammenlign kvalitet og latency, og skift derefter fuldt over. Det undgår nedetid og holder søgeadfærd stabil under overgangen.
Hvilke metrikker skal jeg spore, når jeg sammenligner dimensioner?#
Spor tre grupper: relevans, hastighed og omkostning. For relevans skal du bruge Recall@k, nDCG og MRR på et labeleret forespørgselssæt. For hastighed skal du holde øje med p50/p95/p99 latency, da tail latency påvirker brugeroplevelsen. For omkostning skal du måle lager pr. million dokumenter, RAM-footprint og omkostning pr. 1,000 forespørgsler. I text-embedding-3-small Dimensions Explained hjælper dette scorecard dig med at undgå ensidige valg, hvor du sparer lager, men skader rangeringskvaliteten for meget.
Er text-embedding-3-small egnet til flersproget søgning ved lavere dimensioner?#
Det kan fungere, men flersproget søgning kræver strengere test end ensproget søgning. Lavere dimensioner kan sammenflette subtile betydninger på tværs af sprog, især ved korte forespørgsler og blandede skriftsystemer. Start ved 512 eller 1024, og test derefter efter sprogpar, forespørgselslængde og domæneudtryk. I text-embedding-3-small Dimensions Explained har flersprogede setups ofte gavn af større dimensioner, når præcision betyder noget. Vælg den mindste indstilling, der stadig opfylder relevansmålene for hvert vigtigt sprogsegment.
Hovedpointen er, at text-embedding-3-small-dimensioner er et praktisk tuning-greb: højere dimensioner kan forbedre semantisk trofasthed, mens lavere dimensioner reducerer lager, latency og omkostning, så det rigtige valg afhænger af dine mål for retrieval-kvalitet og dine systembegrænsninger. Behandl dimensionsstørrelse som en empirisk beslutning ved at benchmarke recall, rangeringskvalitet og end-to-end performance på dine egne data i stedet for at stole på standardværdier. Test flere dimensioner i din egen pipeline denne uge, og lås derefter din produktionsindstilling med evidens, ikke gætværk.
Implementation Guides
Available in other languages: