简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Text-embedding-3-small Dimensioni Spiegate: Come Scegliere la Giusta Dimensione per Qualità e Costo
Una guida pratica alle dimensioni di text-embedding-3-small, come scegliere tra 256, 512, 1024 e 1536 dimensioni.
Text-embedding-3-small Dimensioni Spiegate: Come Scegliere la Giusta Dimensione per Qualità e Costo#
A 1536 dimensioni, un vettore text-embedding-3-small archiviato come float32 usa 6,144 byte, quindi 10 milioni di vettori richiedono circa 61 GB prima dell'overhead dell'indice. Questo numero coglie di sorpresa i team quando il retrieval sembra economico su piccola scala, poi i costi di memoria aumentano e il tempo di query cresce dopo l'espansione del corpus. La parte difficile è che dimensioni più alte possono migliorare il ranking su un dataset, ma la stessa impostazione può sprecare storage e aggiungere latenza su un altro.
Questo è il nucleo di text-embedding-3-small Dimensioni Spiegate: non esiste un'impostazione universale che vinca su ogni workload. Devi scegliere la dimensione testando insieme il tuo obiettivo di rilevanza, il limite di latenza p95 e il budget di storage vettoriale, non uno alla volta. Se ottimizzi solo per la qualità, il costo cresce rapidamente. Se riduci solo la dimensione, la qualità della ricerca può peggiorare in modi che gli utenti notano.
Vedrai un metodo pratico di selezione: costruire un piccolo set di valutazione, confrontare la rilevanza su due o tre dimensioni, misurare il tempo di risposta end-to-end e convertire il numero di dimensioni in costo reale di storage per milione di vettori. Da lì, la dimensione corretta diventa una scelta ingegneristica misurabile, non una supposizione.
Cosa Significa "Dimensioni" in text-embedding-3-small (e Perché Cambia i Risultati)#
In termini semplici, text-embedding-3-small Dimensioni Spiegate significa una cosa: quanta semantica mantieni in ogni vettore. Il numero di dimensioni è una manopola di compressione, non un interruttore di qualità. text-embedding-3-small ha una dimensione massima di 1536 dimensioni (dalla specifica del modello nella knowledge base). Dimensioni inferiori comprimono di più.
text-embedding-3-small dimensioni spiegate: dal significato semantico ai vettori numerici#
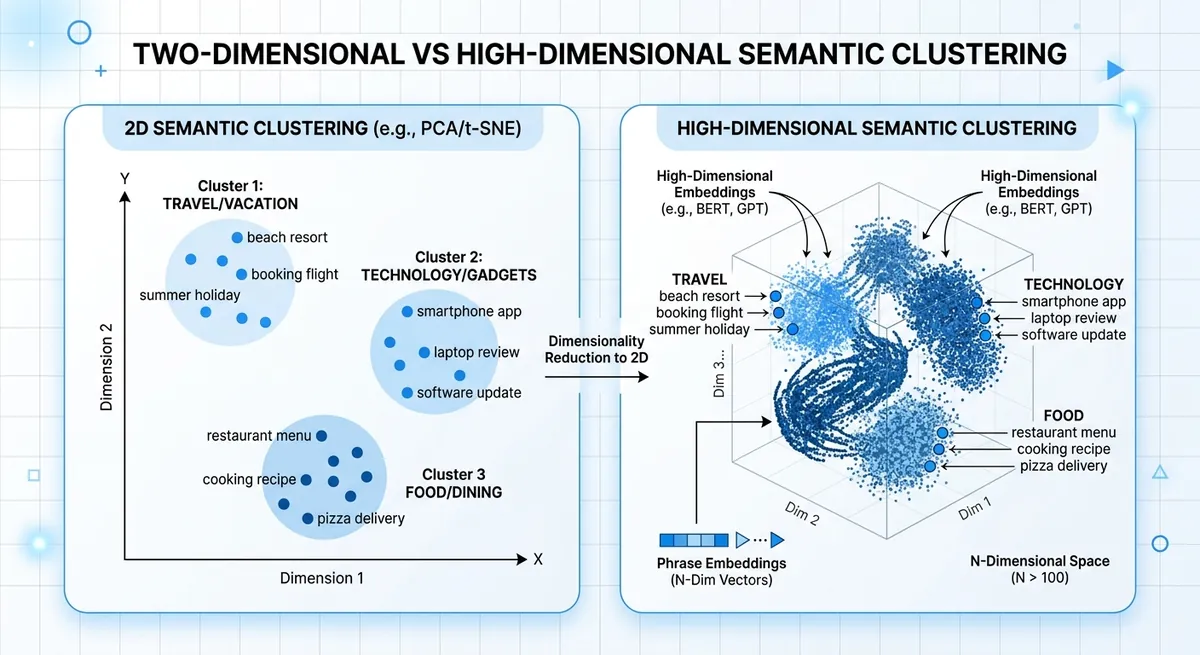
Un embedding trasforma il testo in numeri, così frasi simili si trovano vicine nello spazio vettoriale. "Reset my password" e "I cannot sign in" dovrebbero finire vicine. Ogni dimensione extra offre al modello più spazio per memorizzare sfumature come intento, tono o termini di dominio. Se riduci il vettore, mantieni il significato principale ma perdi dettagli più fini.
dimensione di text-embedding-3-small e cambiamenti nella qualità del ranking#
Dimensioni inferiori possono accelerare la ricerca e ridurre lo storage, ma il ranking dei nearest neighbor può cambiare. Questo cambiamento emerge quando due intenti sembrano simili in superficie ma differiscono nell'azione, come "cancel plan" rispetto a "pause plan."
| Scelta della dimensione del vettore | Fedeltà semantica | Velocità runtime | Storage per 1M vettori (float32) |
|---|---|---|---|
| 1536 (text-embedding-3-small completo) | Massima conservazione dei dettagli | Più lento rispetto a vettori più piccoli | ~6.1 GB |
| 768 (compresso) | Una certa perdita di dettagli | Più veloce | ~3.1 GB |
| 512 (compresso) | Maggior rischio di perdita su intenti vicini | Ancora più veloce | ~2.0 GB |
Fonte: dimensione massima di text-embedding-3-small dalla knowledge base fornita; calcolo dello storage da dimensioni × 4 byte.
Questo è il nucleo pratico di text-embedding-3-small Dimensioni Spiegate: calibra le dimensioni insieme a test di rilevanza, latenza p95 e storage vettoriale.
Opzioni di Dimensione di text-embedding-3-small: Intervalli Pratici e Tradeoff#
Per text-embedding-3-small, la dimensione nativa del vettore è 1536 dimensioni. Nei sistemi reali, i team spesso accorciano i vettori per ridurre RAM, disco e carico dell'indice ANN. Lo storage cresce linearmente con il numero di dimensioni, quindi ogni scelta di dimensione è una scelta diretta di costo e latenza. Questo è il nucleo pratico di text-embedding-3-small Dimensioni Spiegate.
text-embedding-3-small Dimensioni Spiegate: impostazioni comuni e casi d'uso più adatti#
Se ti servono default approssimativi, questa tabella è una buona mappa iniziale per test A/B.
| Dimensione | Storage grezzo per 1M vettori (float32) | Uso più adatto | Rischio tipico |
|---|---|---|---|
| 256 | ~0.95 GB | Limiti stretti di latenza o budget, matching di intenti semplice | Più mancate corrispondenze su query sfumate |
| 384 | ~1.43 GB | Ricerca semantica orientata al costo con testi brevi | Recall più basso sui casi limite |
| 512 | ~1.91 GB | Ricerca bilanciata per documentazione di supporto, help di prodotto, FAQ | Una certa perdita di significato nella long tail |
| 768 | ~2.86 GB | Retrieval bilanciato-plus, stili di query misti | Crescita moderata del costo infrastrutturale |
| 1024 | ~3.81 GB | RAG ad alto recall su documenti densi | Maggiore memoria dell'indice e tempo di query |
| 1536 | ~5.72 GB | Retrieval a piena fedeltà, similarità sfumata | Massima pressione su storage e latenza |
Fonte: intervalli di dimensione dal brief fornito e dalle informazioni del modello (text-embedding-3-small = 1536). Lo storage è calcolato come dimensioni × 4 byte × 1,000,000 vettori.
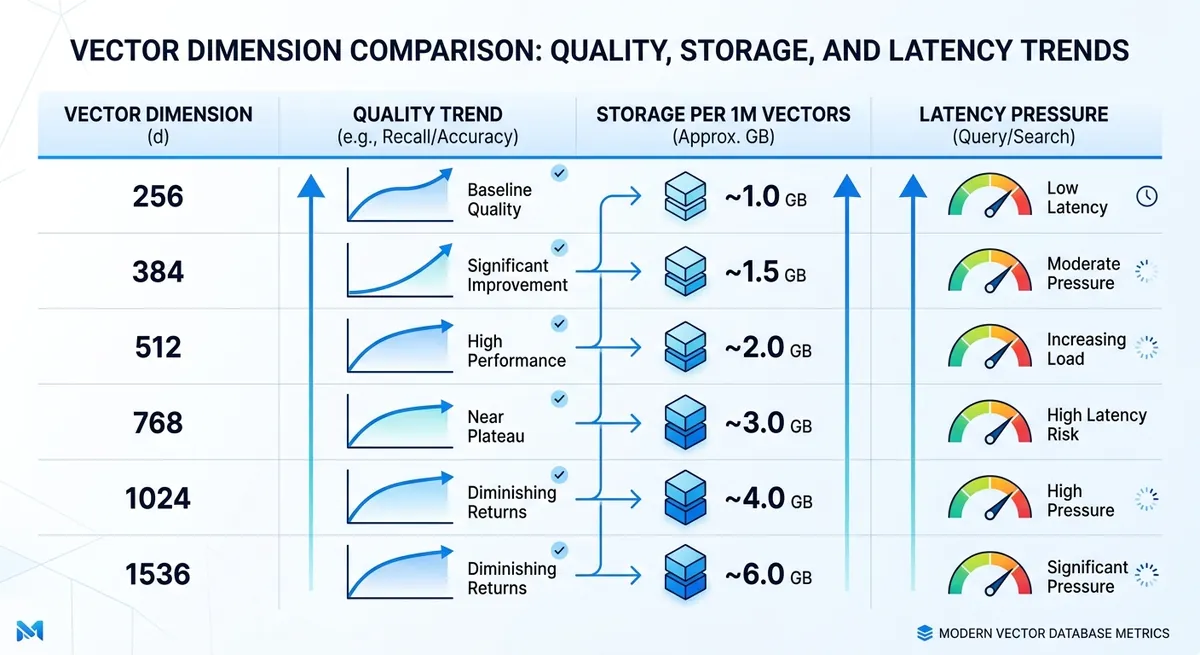
tradeoff di qualità di text-embedding-3-small: dove inizia il degrado#
La perdita di qualità di solito compare prima nei task in cui la precisione è critica. Il retrieval di FAQ può restare utilizzabile a 384 o 512, mentre la ricerca legale o medica spesso richiede 1024 o 1536 per preservare differenze sottili di significato.
Anche il mix linguistico cambia la soglia minima sicura. Workload monolingua in inglese possono reggere a dimensioni inferiori. Traffico multilingua, code-switching e script misti tendono a degradare prima quando i vettori diventano corti.
Puoi eseguire rapidamente questo test tramite Crazyrouter con una sola chiave API e confrontare la qualità del retrieval a 512, 768 e 1536 sullo stesso set di valutazione. Questo offre un punto di cutoff misurabile invece di una supposizione.
Qualità, Latenza e Costo: Il Benchmark a Tre Vie di Cui Hai Davvero Bisogno#
Hai già visto perché una singola metrica può trarre in inganno. Per text-embedding-3-small Dimensioni Spiegate, la mossa pratica è testare contemporaneamente un obiettivo di rilevanza, un budget di latenza e un budget di storage. Scegli la dimensione più piccola che supera comunque la tua soglia di qualità entro il limite di latenza p95.
set di test delle dimensioni di text-embedding-3-small: costruisci una rilevanza offline di cui ti fidi#
Usa log di ricerca reali, ticket di supporto e prompt di chat. Costruisci 200–500 esempi di query se puoi. Questa dimensione è sufficiente a esporre punti deboli senza rallentare il team.
Etichetta cosa significa "buono" per ogni query. Mantieni le etichette semplici: rilevante, parzialmente rilevante, non rilevante. Aggiungi intenzionalmente casi difficili: query brevi, query con refusi, termini di dominio e query multilingua. Se la tua app serve lingue miste, includi query miste nello stesso set.
Non lasciare che una sola persona etichetti i risultati. Due revisori riducono rapidamente i bias.
metriche di benchmark delle dimensioni di text-embedding-3-small: qualità e latenza insieme#
Traccia qualità del ranking e velocità in un'unica esecuzione. Recall@k ti dice se l'elemento corretto compare nella top-k. MRR e nDCG ti dicono se compare vicino alla cima, dove gli utenti cliccano.
Per la latenza, separa il percorso: tempo di embedding e tempo di retrieval. Osserva p95 e p99, non solo la latenza media. Le richieste lente in coda modellano l'esperienza utente.
| Dimensione candidata | Dimensione nota per vettore (float32) | Memoria indice relativa | Metriche di qualità da tracciare | Metriche di latenza da tracciare |
|---|---|---|---|---|
| 1536 (text-embedding-3-small) | 6,144 bytes | baseline 1x | Recall@k, MRR, nDCG | Latenza embedding, retrieval p95/p99 |
| 3072 (text-embedding-3-large) | 12,288 bytes | ~2x vs 1536 | Recall@k, MRR, nDCG | Latenza embedding, retrieval p95/p99 |
| Candidato a dimensione inferiore nel tuo stack | dims × 4 bytes | dims / 1536 | Recall@k, MRR, nDCG | Latenza embedding, retrieval p95/p99 |
Fonte: dimensioni del modello dalla lista modelli Crazyrouter (text-embedding-3-small: 1536, text-embedding-3-large: 3072). Il calcolo in byte usa vettori float32.
modello di costo delle dimensioni di text-embedding-3-small: dallo storage all'impatto sul business#
Converti le dimensioni in denaro prima del rollout.
Storage per milione di vettori = dimension × 4 bytes × 1,000,000, poi moltiplica per il numero di repliche. Aggiungi l'overhead dell'indice del tuo database vettoriale.
<.-- IMAGE: Infografica in stile formula per stimare storage vettoriale e costo annuale per dimensione e dimensione del corpus. -->
Ora collega il miglioramento di qualità ai segnali di business che già monitori, come CTR, deflessione dei ticket o conversione. Se una dimensione maggiore aumenta leggermente nDCG ma raddoppia la memoria e manca p95, mantieni l'impostazione più piccola. Se aumenta abbastanza la rilevanza ordinata da muovere la conversione, hai un business case pulito.
Come Scegliere la Dimensione Corretta in Base al Caso d'Uso#
Se stai ancora indovinando la dimensione, questa parte di text-embedding-3-small Dimensioni Spiegate è la scorciatoia: mappa la dimensione al workload, poi verifica con un piccolo set di valutazione prima del rollout.
text-embedding-3-small Dimensioni Spiegate per RAG e ricerca enterprise#
RAG e ricerca interna falliscono rapidamente quando il recall cala. Gli utenti fanno una domanda, poi abbandonano se i risultati principali mancano fatti chiave. Quindi il tuo punto di partenza dovrebbe essere la qualità, non lo storage.
Usa 1536 come baseline per text-embedding-3-small, poi testa una sola dimensione inferiore solo dopo aver confermato il recall sulle query difficili. Query difficili significa domande lunghe, termini rari e intento misto.
Il chunking cambia il risultato più di quanto molti si aspettino. Chunk piccoli più basse dimensioni possono perdere contesto due volte: una nella suddivisione, una nell'embedding. Se i tuoi chunk sono brevi, mantieni dimensioni più alte. Se i chunk sono lunghi e puliti, puoi testare una dimensione inferiore senza rischio cieco.
dimensioni di text-embedding-3-small per raccomandazioni, clustering e routing semantico#
Questi sistemi di solito si preoccupano di velocità e raggruppamento stabile, non di un recall top-1 perfetto. Un'impostazione media spesso offre il miglior tradeoff.
Per il routing, una similarità approssimata è spesso sufficiente perché un modello di secondo stadio può riordinare o verificare. Questo significa che puoi testare dimensioni inferiori prima di quanto faresti in RAG. Per il clustering, valuta purezza dei cluster e drift sui dati settimanali, non solo una singola esecuzione offline.
Scegli la dimensione più piccola che mantiene stabile la tua metrica downstream per due cicli completi di traffico.
text-embedding-3-small Dimensioni Spiegate per workload multilingua e specifici di dominio#
Il linguaggio di dominio cambia le regole. Termini legali, medici o hardware possono essere vicini nel linguaggio comune ma lontani nel significato. Dimensioni inferiori possono sfocare questi confini.
Il traffico multilingua richiede controlli per lingua. Non mediare tutto in un unico punteggio. Esegui lo stesso set di intenti su ogni segmento linguistico principale, poi confronta i pattern di errore. Una dimensione che funziona in inglese può fallire su query miste o termini traslitterati.
| Caso d'uso | Dimensione iniziale consigliata | Cosa misurare prima di ridurre | Segnale comune di fallimento |
|---|---|---|---|
| RAG / ricerca enterprise | 1536 | Recall su query difficili, grounding della risposta | Documento corretto assente dai risultati principali |
| Raccomandazioni | Media (test sotto 1536) | Stabilità di CTR o conversione | Elementi simili ma irrilevanti salgono |
| Routing semantico | Da media a bassa | Accuratezza del routing + tasso di fallback | Route errata, fallback più alto |
| Multilingua / forte dominio | 1536 | Recall per lingua, errori a livello di termine | Termini rari mappati a significato generico |
Fonte: informazioni sulle dimensioni del modello dalla lista modelli Crazyrouter (text-embedding-3-small: 1536, text-embedding-3-large: 3072). <.-- IMAGE: Matrice decisionale per caso d'uso (RAG, recsys, routing, multilingua) con dimensioni iniziali consigliate. -->
Guida all'Implementazione: API, Schema Vettoriale e Passi di Migrazione#
text-embedding-3-small dimensioni spiegate nelle richieste API#
La baseline sicura per text-embedding-3-small è 1536 dimensioni. Puoi richiedere una dimensione inferiore con il campo dimensions, ma mantieni quella dimensione fissa per indice. Se i vettori dei documenti usano 1024 e i vettori delle query usano 1536, la qualità del retrieval devierà anche se entrambe le chiamate vanno a buon fine.
Usa un unico valore di configurazione per i percorsi di scrittura e lettura, poi valida ogni richiesta: il testo di input non è vuoto, la lunghezza del vettore è uguale alla dimensione configurata e ogni valore è un numero reale (nessun NaN, nessun Inf). Se la validazione fallisce, instrada l'elemento a una coda di retry e riesegui l'embedding con la dimensione predefinita.
Puoi usare l'OpenAI SDK con un endpoint compatibile come https://ai.crazyrouter.us/v1, poi fissare modello e dimensioni in un unico file di configurazione condiviso usato da tutti i servizi.
controllo delle dimensioni di text-embedding-3-small nello schema vettoriale e nel design dell'indice#
Mantieni una sola dimensione per indice e mantieni vettori di query e documenti sulla stessa dimensione.
Usa nomi di collection vincolati alla dimensione come kb_d1536_v1 e kb_d1024_v1. Questa convenzione mantiene leggibili le migrazioni e previene mix silenziosi.
<.-- IMAGE: Diagramma architetturale che mostra ingestion, servizio di embedding, doppi indici vettoriali e router delle query. -->
Quando la dimensionalità cambia, ricostruisci le impostazioni dell'indice con i nuovi vettori. Per HNSW, ritara le impostazioni di grafo e ricerca dopo la ricostruzione. Per IVF, riaddestra i centroidi sui vettori della nuova dimensione. Riutilizzare vecchi dati di training dell'indice può danneggiare il recall.
text-embedding-3-small dimensioni spiegate per la migrazione da modelli precedenti#
Esegui la migrazione per fasi:
| Fase | Percorso di scrittura | Percorso di lettura | Cosa controllare |
|---|---|---|---|
| Dual-write | Vecchi + nuovi embedding | Vecchio indice | Tasso di successo in scrittura ed errori di validazione dei vettori |
| Shadow-read | Vecchi + nuovi embedding | L'utente vede il vecchio, si logga il nuovo | Overlap top-k, latenza, casi di query problematici |
| Cutover | Vecchi + nuovi embedding | Nuovo indice | Tasso di superamento della rilevanza e target di latenza p95 |
| Rollback | Mantieni attivo il dual-write | Torna al vecchio | Trigger su picco di errori o calo della rilevanza |
Fonte: knowledge base Crazyrouter (text-embedding-3-small a 1536 dimensioni; API compatibile con OpenAI; 300+ modelli supportati).
Questo è il nucleo pratico di text-embedding-3-small Dimensioni Spiegate: blocca le dimensioni, testa con traffico shadow e fai cutover solo dopo aver misurato la parità.
Operatività in Produzione: Monitoraggio di Drift, Regressioni di Qualità e Workflow del Team#
Hai scelto una dimensione con test offline. Buon inizio. Il rischio reale emerge più tardi, quando nuovi contenuti, nuovo mix di query e cambiamenti di ranking arrivano in produzione. In text-embedding-3-small Dimensioni Spiegate, la qualità a lungo termine deriva da un ciclo stretto: dati di valutazione fissi, controlli sul comportamento live e passaggi di rollout controllati.
Configurare il monitoraggio del drift delle dimensioni di text-embedding-3-small#
Blocca il tuo set di valutazione e le metriche prima di ogni cambio di dimensione. Mantieni un golden query set che corrisponde agli intenti reali degli utenti, poi valutalo ogni settimana con la stessa rubrica. Abbinalo a segnali live così intercetti il drift presto, non dopo l'accumulo di ticket di supporto.
| Segnale | Aspetto del drift | Cadenza di revisione | Trigger di azione |
|---|---|---|---|
| Punteggio di rilevanza del golden set | I risultati principali smettono di corrispondere alle risposte note come buone | Scorecard settimanale | Calo rispetto all'ultima esecuzione stabile |
| CTR sui blocchi di retrieval | Gli utenti cliccano meno sui documenti suggeriti | Giornaliera | Calo sostenuto |
| Tasso di successo del task | Più sessioni non completano il task target | Giornaliera | Trend negativo per segmento |
| Tasso di nessun risultato | Aumentano le risposte di retrieval vuote | Giornaliera | Picco dopo il deploy |
Fonte tabella: pattern di runbook operativo usato in questa sezione (golden set + metriche online dal brief fornito).
<.-- IMAGE: Mock di dashboard che mostra punteggio settimanale del golden set, trend CTR, tasso di nessun risultato e soglie di alert -->
Eseguire esperimenti sulle dimensioni di text-embedding-3-small in modo sicuro in staging e produzione#
Inizia in staging con query riprodotte dagli ultimi 7 a 14 giorni. Passa in produzione con una slice canary, poi espandi per segmento utente e regione. Tieni pronto il rollback. Se la qualità cala, metti in pausa la crescita del traffico, torna all'ultima dimensione stabile e registra quali tipi di query hanno fallito. Questo mantiene brevi gli incidenti e fornisce dati puliti per il test successivo.
Workflow del team per esperimenti su text-embedding-3-small Dimensioni Spiegate#
La valutazione cross-team spesso si rompe perché le persone testano in sessioni browser miste. SEO, prodotto e ML possono sovrascrivere lo stato l'uno dell'altro, poi nessuno si fida del risultato. Puoi usare profili isolati DICloak così ogni ruolo testa la stessa build senza conflitti di sessione o incroci di account.
Strumenti come DICloak ti permettono di impostare regole fisse di proxy e sessione per profilo. Questo significa che i tuoi test "US-English account" ed "EU account" vengono eseguiti ogni volta in condizioni di rete stabili. Un setup riproducibile rende più facili da confrontare tra colleghi i controlli di ranking basati sulle dimensioni e offre un percorso ripetibile e sicuro per il lavoro continuo su text-embedding-3-small Dimensioni Spiegate.
Errori Comuni e Checklist Finale per la Selezione della Dimensione#
Se sei arrivato fin qui, text-embedding-3-small Dimensioni Spiegate dovrebbe concludersi con una decisione di lancio, non con una supposizione.
errori sulle dimensioni di text-embedding-3-small che rompono la produzione#
| Errore | Cosa va storto | Cosa fare |
|---|---|---|
| Ti fidi solo dei benchmark del vendor | La ricerca sembra corretta nei test, ma le tue query reali mancano l'intento | Costruisci un set di valutazione interno da query utente reali, poi valuta ogni impostazione di dimensione su quel set |
| Riduci il costo di storage e salti i controlli di qualità | Una dimensione vettoriale inferiore fa risparmiare, ma la qualità dei clic cala e i ticket di supporto aumentano | Traccia insieme qualità del retrieval e comportamento utente prima del rollout |
| Testi solo la rilevanza | Impostazioni di indice veloci possono comunque fallire il tuo target p95 | Misura la latenza end-to-end: embed + ricerca indice + rerank |
Checklist finale in 10 punti per il go-live di text-embedding-3-small Dimensioni Spiegate#
- Pulisci duplicati e testo corrotto nei dati sorgente.
- Copri query head, mid e tail nel tuo benchmark.
- Confronta almeno due dimensioni: 1536 (text-embedding-3-small) e 3072 (text-embedding-3-large).
- Registra la rilevanza top-k per ogni dimensione sullo stesso set di query.
- Registra la latenza p95 dalla chiamata API al risultato finale ordinato.
- Converti il numero di dimensioni in costo di storage per milione di vettori.
- Esegui un canary con traffico reale e metriche di successo.
- Prepara i passaggi di rollback prima del rollout completo.
- Assegna un owner per monitoraggio e risposta agli alert.
- Imposta una cadenza di revisione per retraining o re-embedding.
Rilascia solo quando rilevanza, latenza p95 e costo di storage passano insieme.
<.-- IMAGE: Grafica checklist di una pagina per le decisioni sulle dimensioni degli embedding. -->
Domande frequenti#
In text-embedding-3-small Dimensioni Spiegate, qual è la migliore dimensione predefinita da cui partire?#
Un punto di partenza pratico è 512 per la maggior parte dei team, oppure 1024 se i tuoi contenuti sono complessi (documenti legali, tecnici, long-form). In text-embedding-3-small Dimensioni Spiegate, questo offre un forte equilibrio tra qualità, velocità e costo senza impegnarsi troppo presto. Poi esegui un piccolo benchmark usando le tue query utente reali e i filtri attesi. Scegli la dimensione più piccola che soddisfa ancora il tuo obiettivo di rilevanza, non solo quella che sembra migliore in un test giocattolo.
Ridurre le dimensioni in text-embedding-3-small Dimensioni Spiegate riduce sempre la qualità del retrieval?#
Dimensioni inferiori non danneggiano sempre i risultati in modo significativo. Per la ricerca su FAQ brevi o domini ristretti, il calo può essere piccolo. Per cataloghi ampi, contenuti multilingua o matching semantico sfumato, la qualità può scendere più rapidamente. In text-embedding-3-small Dimensioni Spiegate, tratta la dimensione come una manopola di tuning: confronta 256, 512 e 1024 sullo stesso set di query. Mantieni la dimensione più piccola che preserva Recall@k e qualità di ranking accettabili per i tuoi utenti reali.
In che modo le dimensioni di text-embedding-3-small influenzano il costo del database vettoriale?#
Il costo scala approssimativamente in modo lineare con il numero di dimensioni. Se riduci i vettori da 1024 a 512, lo storage vettoriale grezzo è circa la metà. La stessa tendenza si applica all'uso di RAM e spesso al compute delle query. Ma includi l'overhead dell'indice: le strutture ANN aggiungono memoria per link del grafo, metadati e bookkeeping interno. Quindi i risparmi totali sono forti, ma non riguardano solo i byte dei vettori. In pratica, stima la dimensione completa dell'indice, non solo la dimensione degli embedding, prima di fissare una dimensione finale.
Devo rieseguire l'embedding di tutti i documenti quando cambio dimensione?#
Sì. Un vettore costruito a una dimensione non può essere mescolato con vettori di un'altra dimensione in un unico indice coerente. Quando cambi dimensione, riesegui l'embedding di tutti i documenti e ricostruisci l'indice. Per sistemi di produzione, usa una migrazione più sicura: esegui un rollout dual-index. Costruisci il nuovo indice in parallelo, invia una slice di traffico, confronta qualità e latenza, poi passa completamente al nuovo. Questo evita downtime e mantiene stabile il comportamento della ricerca durante la transizione.
Quali metriche dovrei tracciare quando confronto le dimensioni?#
Traccia tre gruppi: rilevanza, velocità e costo. Per la rilevanza, usa Recall@k, nDCG e MRR su un set di query etichettato. Per la velocità, osserva latenza p50/p95/p99, perché la latenza in coda influisce sull'esperienza utente. Per il costo, misura storage per milione di documenti, footprint RAM e costo per 1,000 query. In text-embedding-3-small Dimensioni Spiegate, questa scorecard ti aiuta a evitare scelte sbilanciate in cui risparmi storage ma danneggi troppo la qualità del ranking.
text-embedding-3-small è adatto alla ricerca multilingua a dimensioni inferiori?#
Può funzionare, ma la ricerca multilingua richiede test più rigorosi rispetto alla ricerca monolingua. Dimensioni inferiori possono fondere sfumature di significato tra lingue, soprattutto per query brevi e script misti. Parti da 512 o 1024, poi testa per coppia linguistica, lunghezza della query e termini di dominio. In text-embedding-3-small Dimensioni Spiegate, le configurazioni multilingua spesso beneficiano di dimensioni maggiori quando la precisione conta. Scegli l'impostazione più piccola che soddisfa ancora gli obiettivi di rilevanza per ogni segmento linguistico chiave.
Il punto essenziale è che le dimensioni di text-embedding-3-small sono una leva pratica di tuning: dimensioni più alte possono migliorare la fedeltà semantica, mentre dimensioni più basse riducono storage, latenza e costo, quindi la scelta corretta dipende dai tuoi obiettivi di qualità del retrieval e dai vincoli del sistema. Tratta la dimensione come una decisione empirica, facendo benchmark di recall, qualità del ranking e prestazioni end-to-end sui tuoi dati invece di affidarti ai default. Testa più dimensioni nella tua pipeline questa settimana, poi blocca l'impostazione di produzione con prove, non supposizioni.
Implementation Guides
Available in other languages: