简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Giải Thích Về Kích Thước text-embedding-3-small: Cách Chọn Kích Thước Phù Hợp Cho Chất Lượng và Chi Phí
Hướng dẫn thực tế về kích thước text-embedding-3-small, cách lựa chọn giữa 256, 512, 1024 và 1536 chiều.
Giải Thích Về Kích Thước text-embedding-3-small: Cách Chọn Kích Thước Phù Hợp Cho Chất Lượng và Chi Phí#
Ở 1536 chiều, một vector text-embedding-3-small được lưu dưới dạng float32 dùng 6,144 bytes, vì vậy 10 triệu vector cần khoảng 61 GB trước khi tính phần overhead của chỉ mục. Con số đó thường khiến các nhóm bất ngờ: retrieval có vẻ rẻ ở quy mô nhỏ, rồi chi phí bộ nhớ tăng lên và thời gian truy vấn dài hơn khi corpus mở rộng. Phần khó là số chiều cao hơn có thể cải thiện xếp hạng trên một tập dữ liệu, nhưng cùng thiết lập đó lại có thể lãng phí lưu trữ và tăng độ trễ trên tập khác.
Đó là cốt lõi của Giải Thích Về Kích Thước text-embedding-3-small: không có một thiết lập phổ quát nào thắng trên mọi workload. Bạn cần chọn kích thước chiều bằng cách kiểm thử đồng thời mục tiêu relevance, giới hạn độ trễ p95 và ngân sách lưu trữ vector của chính mình, không phải từng yếu tố riêng lẻ. Nếu bạn chỉ tối ưu cho chất lượng, chi phí sẽ tăng rất nhanh. Nếu bạn chỉ cắt giảm kích thước, chất lượng tìm kiếm có thể suy giảm theo cách người dùng nhận ra.
Bạn sẽ thấy một phương pháp lựa chọn thực tế: xây dựng một eval set nhỏ, so sánh relevance ở hai hoặc ba kích thước chiều, đo thời gian phản hồi end-to-end, và chuyển số chiều thành chi phí lưu trữ thực tế trên mỗi triệu vector. Từ đó, kích thước phù hợp trở thành một lựa chọn kỹ thuật có thể đo lường, không phải phỏng đoán.
"Dimensions" Nghĩa Là Gì Trong text-embedding-3-small (Và Vì Sao Nó Thay Đổi Kết Quả)#
Nói đơn giản, Giải Thích Về Kích Thước text-embedding-3-small có một ý nghĩa: lượng ngữ nghĩa bạn giữ lại trong mỗi vector. Số chiều là một núm điều chỉnh nén, không phải một công tắc chất lượng. text-embedding-3-small có kích thước tối đa 1536 chiều (theo thông số model trong knowledge base). Kích thước thấp hơn sẽ nén mạnh hơn.
Giải thích kích thước text-embedding-3-small: từ ý nghĩa ngữ nghĩa đến vector số#
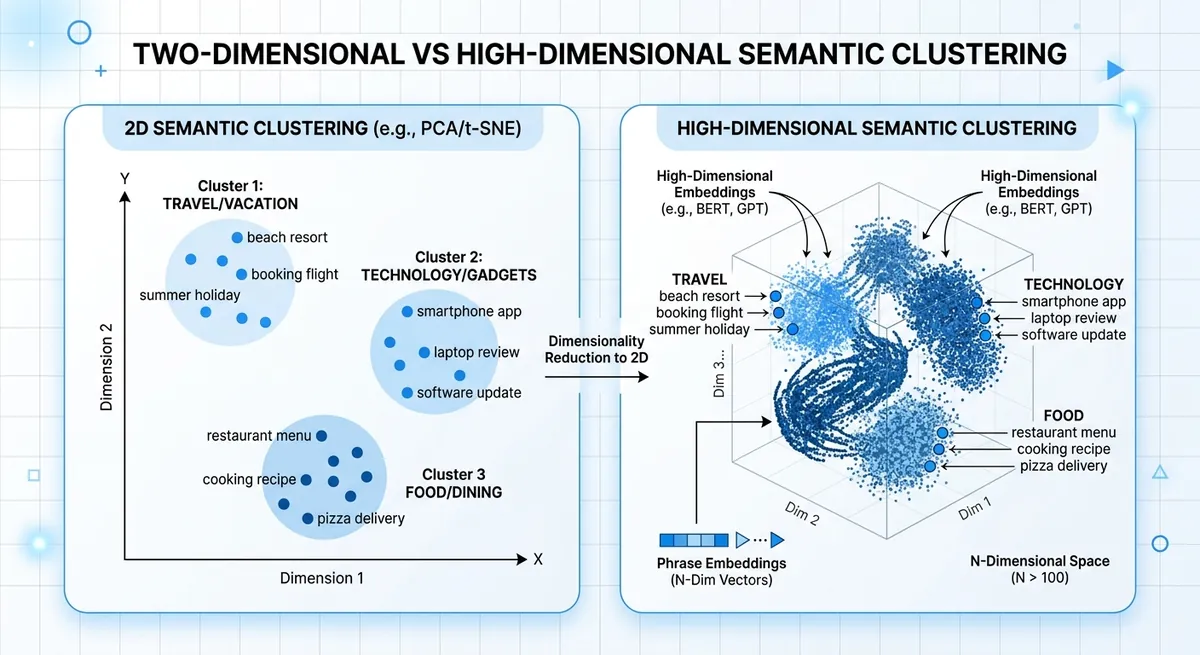
Embedding biến văn bản thành các con số để những cụm từ tương tự nằm gần nhau trong không gian vector. "Reset my password" và "I cannot sign in" nên nằm gần nhau. Mỗi chiều bổ sung cho model thêm không gian để lưu sắc thái như ý định, giọng điệu hoặc thuật ngữ miền. Nếu bạn thu nhỏ vector, bạn giữ lại ý nghĩa cốt lõi nhưng làm mất chi tiết tinh hơn.
Kích thước chiều text-embedding-3-small và thay đổi chất lượng xếp hạng#
Số chiều thấp hơn có thể tăng tốc tìm kiếm và giảm lưu trữ, nhưng thứ hạng nearest-neighbor có thể thay đổi. Sự thay đổi đó xuất hiện khi hai ý định nhìn bề ngoài tương tự nhau nhưng khác hành động, như "cancel plan" so với "pause plan."
| Lựa chọn kích thước vector | Độ trung thực ngữ nghĩa | Tốc độ runtime | Lưu trữ trên 1M vector (float32) |
|---|---|---|---|
| 1536 (text-embedding-3-small đầy đủ) | Giữ chi tiết cao nhất | Chậm hơn vector nhỏ hơn | ~6.1 GB |
| 768 (nén) | Mất một phần chi tiết | Nhanh hơn | ~3.1 GB |
| 512 (nén) | Rủi ro mất mát cao hơn ở các ý định gần nhau | Vẫn nhanh hơn | ~2.0 GB |
Nguồn: kích thước tối đa của text-embedding-3-small từ knowledge base được cung cấp; phép tính lưu trữ từ số chiều × 4 bytes.
Đó là cốt lõi thực tế của Giải Thích Về Kích Thước text-embedding-3-small: điều chỉnh số chiều cùng với kiểm thử relevance, độ trễ p95 và lưu trữ vector.
Các Tùy Chọn Kích Thước text-embedding-3-small: Phạm Vi Thực Tế và Đánh Đổi#
Với text-embedding-3-small, kích thước vector native là 1536 chiều. Trong các hệ thống thực tế, các nhóm thường rút ngắn vector để giảm tải RAM, ổ đĩa và chỉ mục ANN. Lưu trữ tăng tuyến tính theo số chiều, vì vậy mỗi lựa chọn kích thước là một lựa chọn trực tiếp về chi phí và độ trễ. Đây là cốt lõi thực tế của Giải Thích Về Kích Thước text-embedding-3-small.
Giải Thích Về Kích Thước text-embedding-3-small: thiết lập phổ biến và use case phù hợp nhất#
Nếu bạn cần các mặc định tham khảo, bảng này là bản đồ khởi đầu tốt cho A/B test.
| Số chiều | Lưu trữ thô trên 1M vector (float32) | Phù hợp nhất | Rủi ro thường gặp |
|---|---|---|---|
| 256 | ~0.95 GB | Giới hạn độ trễ hoặc ngân sách chặt, matching intent đơn giản | Bỏ sót nhiều hơn trên truy vấn nhiều sắc thái |
| 384 | ~1.43 GB | Semantic search tập trung vào chi phí với văn bản ngắn | Recall thấp hơn ở edge case |
| 512 | ~1.91 GB | Tìm kiếm cân bằng cho tài liệu hỗ trợ, trợ giúp sản phẩm, FAQ | Mất một phần ý nghĩa long-tail |
| 768 | ~2.86 GB | Retrieval cân bằng nâng cao, nhiều kiểu truy vấn pha trộn | Chi phí hạ tầng tăng vừa phải |
| 1024 | ~3.81 GB | RAG high-recall trên tài liệu dày đặc | Bộ nhớ chỉ mục và thời gian truy vấn cao hơn |
| 1536 | ~5.72 GB | Retrieval độ trung thực đầy đủ, similarity nhiều sắc thái | Áp lực lưu trữ và độ trễ cao nhất |
Nguồn: phạm vi số chiều từ outline và thông tin model được cung cấp (text-embedding-3-small = 1536). Lưu trữ được tính bằng số chiều × 4 bytes × 1,000,000 vector.
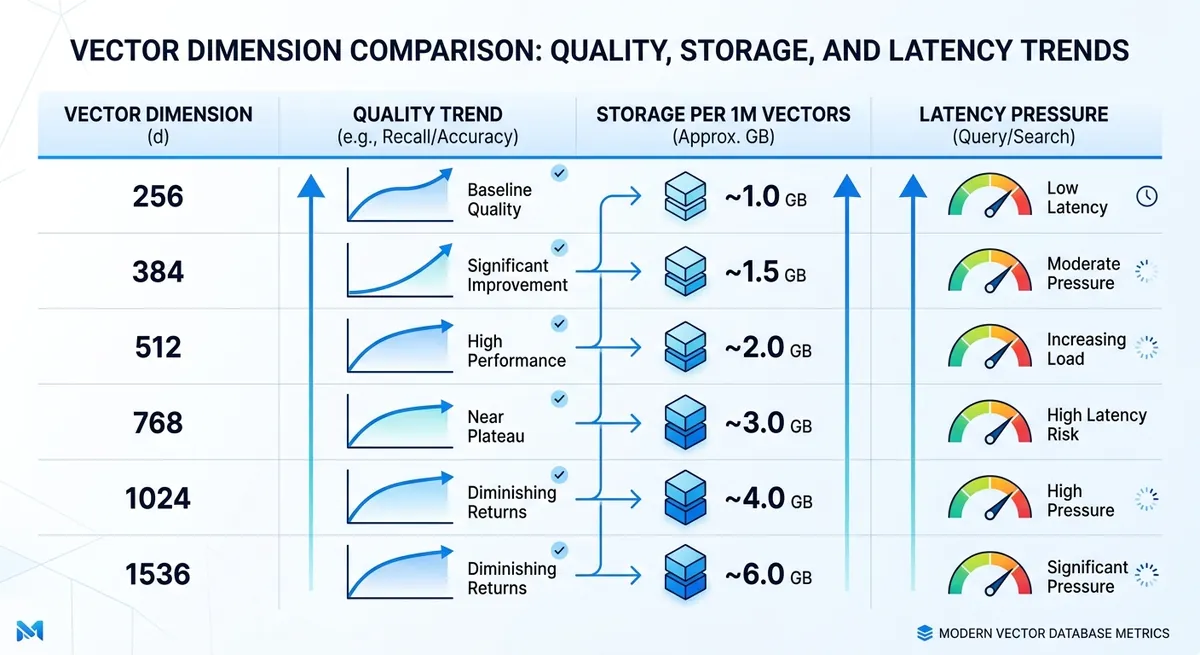
Đánh đổi chất lượng của text-embedding-3-small: suy giảm bắt đầu ở đâu#
Mất chất lượng thường xuất hiện sớm hơn trên các tác vụ đòi hỏi precision cao. FAQ retrieval có thể vẫn dùng tốt ở 384 hoặc 512, trong khi tìm kiếm pháp lý hoặc y tế thường cần 1024 hoặc 1536 để giữ các khác biệt ý nghĩa tinh tế.
Hỗn hợp ngôn ngữ cũng thay đổi ngưỡng an toàn. Workload đơn ngữ tiếng Anh có thể trụ vững ở kích thước thấp hơn. Traffic đa ngôn ngữ, code-switching và chữ viết pha trộn có xu hướng suy giảm sớm hơn khi vector ngắn lại.
Bạn có thể chạy kiểm thử này nhanh qua Crazyrouter với một API key và so sánh chất lượng retrieval ở 512, 768 và 1536 trên cùng một eval set. Điều đó cho bạn một điểm cắt có thể đo lường thay vì phỏng đoán.
Chất Lượng, Độ Trễ và Chi Phí: Benchmark Ba Chiều Bạn Thực Sự Cần#
Bạn đã thấy vì sao một metric đơn lẻ có thể gây hiểu nhầm. Với Giải Thích Về Kích Thước text-embedding-3-small, bước thực tế là kiểm thử đồng thời một mục tiêu relevance, một ngân sách độ trễ và một ngân sách lưu trữ. Chọn số chiều nhỏ nhất vẫn vượt qua ngưỡng chất lượng của bạn dưới giới hạn độ trễ p95.
Test set kích thước text-embedding-3-small: xây dựng relevance offline đáng tin cậy#
Dùng log tìm kiếm thật, ticket hỗ trợ và prompt chat. Xây dựng 200–500 ví dụ truy vấn nếu có thể. Quy mô đó đủ để lộ điểm yếu mà không làm chậm nhóm của bạn.
Gắn nhãn thế nào là "tốt" cho từng truy vấn. Giữ nhãn đơn giản: relevant, partially relevant, not relevant. Cố ý thêm các trường hợp khó: truy vấn ngắn, truy vấn có lỗi chính tả, thuật ngữ miền và truy vấn đa ngôn ngữ. Nếu app của bạn phục vụ nhiều ngôn ngữ pha trộn, hãy đưa truy vấn mixed-language vào cùng một tập.
Đừng để chỉ một người gắn nhãn kết quả. Hai reviewer giảm bias rất nhanh.
Metric benchmark kích thước text-embedding-3-small: chất lượng và độ trễ cùng nhau#
Theo dõi chất lượng xếp hạng và tốc độ trong một lần chạy. Recall@k cho bạn biết item đúng có xuất hiện trong top-k hay không. MRR và nDCG cho biết nó có xuất hiện gần đầu danh sách, nơi người dùng click, hay không.
Với độ trễ, hãy tách đường đi: thời gian embedding và thời gian retrieval. Theo dõi p95 và p99, không chỉ độ trễ trung bình. Các request chậm ở đuôi định hình trải nghiệm người dùng.
| Ứng viên số chiều | Kích thước đã biết trên mỗi vector (float32) | Bộ nhớ chỉ mục tương đối | Metric chất lượng cần theo dõi | Metric độ trễ cần theo dõi |
|---|---|---|---|---|
| 1536 (text-embedding-3-small) | 6,144 bytes | baseline 1x | Recall@k, MRR, nDCG | Độ trễ embedding, retrieval p95/p99 |
| 3072 (text-embedding-3-large) | 12,288 bytes | ~2x so với 1536 | Recall@k, MRR, nDCG | Độ trễ embedding, retrieval p95/p99 |
| Ứng viên số chiều thấp hơn trong stack của bạn | dims × 4 bytes | dims / 1536 | Recall@k, MRR, nDCG | Độ trễ embedding, retrieval p95/p99 |
Nguồn: số chiều model từ danh sách model Crazyrouter (text-embedding-3-small: 1536, text-embedding-3-large: 3072). Phép tính byte dùng vector float32.
Mô hình chi phí kích thước text-embedding-3-small: từ lưu trữ đến tác động kinh doanh#
Chuyển số chiều thành tiền trước khi rollout.
Lưu trữ trên mỗi triệu vector = dimension × 4 bytes × 1,000,000, sau đó nhân với số replica. Cộng thêm overhead chỉ mục từ vector database của bạn.
<.-- IMAGE: Infographic dạng công thức để ước tính lưu trữ vector và chi phí hằng năm theo số chiều và kích thước corpus. -->
Bây giờ hãy gắn mức tăng chất lượng với các tín hiệu kinh doanh bạn đã theo dõi, như CTR, ticket deflection hoặc conversion. Nếu số chiều lớn hơn nâng nDCG một chút nhưng làm gấp đôi bộ nhớ và trượt p95, hãy giữ thiết lập nhỏ hơn. Nếu nó nâng relevance đã xếp hạng đủ để tác động đến conversion, bạn có một business case rõ ràng.
Cách Chọn Kích Thước Phù Hợp Theo Use Case#
Nếu bạn vẫn đang đoán kích thước chiều, phần này của Giải Thích Về Kích Thước text-embedding-3-small là lối tắt: ánh xạ số chiều với workload, rồi xác minh bằng một eval set nhỏ trước khi rollout.
Giải Thích Về Kích Thước text-embedding-3-small cho RAG và enterprise search#
RAG và tìm kiếm nội bộ thất bại rất nhanh khi recall giảm. Người dùng hỏi một câu, rồi rời đi nếu các kết quả đầu bỏ lỡ sự thật quan trọng. Vì vậy điểm bắt đầu của bạn nên là chất lượng, không phải lưu trữ.
Dùng 1536 làm baseline cho text-embedding-3-small, sau đó chỉ kiểm thử một kích thước thấp hơn sau khi bạn xác nhận recall trên truy vấn khó. Truy vấn khó nghĩa là câu hỏi dài, thuật ngữ hiếm và ý định pha trộn.
Chunking thay đổi kết quả nhiều hơn mọi người thường nghĩ. Chunk nhỏ cộng với số chiều thấp có thể làm mất ngữ cảnh hai lần: một lần khi chia nhỏ, một lần khi embedding. Nếu chunk của bạn ngắn, hãy giữ số chiều cao hơn. Nếu chunk dài và sạch, bạn có thể kiểm thử kích thước thấp hơn mà không phải chịu rủi ro mù.
Kích thước text-embedding-3-small cho recommendation, clustering và semantic routing#
Các hệ thống này thường quan tâm đến tốc độ và nhóm ổn định, không phải recall top-1 hoàn hảo. Một thiết lập trung bình thường đem lại đánh đổi tốt nhất.
Với routing, approximate similarity thường là đủ vì model giai đoạn hai có thể re-rank hoặc xác minh. Điều đó nghĩa là bạn có thể kiểm thử số chiều thấp hơn sớm hơn so với RAG. Với clustering, hãy đánh giá cluster purity và drift trên dữ liệu hằng tuần, không chỉ một lần chạy offline.
Chọn số chiều nhỏ nhất vẫn giữ metric downstream ổn định trong hai chu kỳ traffic đầy đủ.
Giải Thích Về Kích Thước text-embedding-3-small cho workload đa ngôn ngữ và đặc thù miền#
Ngôn ngữ miền thay đổi cuộc chơi. Thuật ngữ pháp lý, y tế hoặc phần cứng có thể nằm gần nhau trong ngôn ngữ thường nhưng khác xa về ý nghĩa. Số chiều thấp hơn có thể làm mờ các ranh giới này.
Traffic đa ngôn ngữ cần kiểm tra theo từng ngôn ngữ. Đừng gom trung bình mọi thứ thành một điểm số. Chạy cùng một intent set trên từng phân khúc ngôn ngữ chính, rồi so sánh mẫu bỏ sót. Một kích thước hoạt động tốt bằng tiếng Anh có thể thất bại trên truy vấn mixed-language hoặc thuật ngữ chuyển tự.
| Use case | Số chiều khởi đầu được khuyến nghị | Cần đo gì trước khi giảm | Dấu hiệu lỗi thường gặp |
|---|---|---|---|
| RAG / enterprise search | 1536 | Recall trên truy vấn khó, grounding của câu trả lời | Tài liệu đúng không nằm trong top kết quả |
| Recommendation | Trung bình (kiểm thử dưới 1536) | Độ ổn định CTR hoặc conversion | Item tương tự nhưng không liên quan tăng hạng |
| Semantic routing | Trung bình đến thấp hơn | Độ chính xác route + fallback rate | Sai route, fallback cao hơn |
| Đa ngôn ngữ / nặng đặc thù miền | 1536 | Recall theo từng ngôn ngữ, lỗi ở cấp thuật ngữ | Thuật ngữ hiếm bị ánh xạ thành nghĩa chung |
Nguồn: thông tin số chiều model từ danh sách model Crazyrouter (text-embedding-3-small: 1536, text-embedding-3-large: 3072). <.-- IMAGE: Ma trận quyết định theo use case (RAG, recsys, routing, multilingual) với số chiều khởi đầu được khuyến nghị. -->
Hướng Dẫn Triển Khai: API, Vector Schema và Các Bước Migration#
Giải thích kích thước text-embedding-3-small trong request API#
Baseline an toàn cho text-embedding-3-small là 1536 chiều. Bạn có thể yêu cầu kích thước nhỏ hơn bằng trường dimensions, nhưng hãy giữ kích thước đó cố định cho mỗi index. Nếu vector tài liệu dùng 1024 và vector truy vấn dùng 1536, chất lượng retrieval sẽ drift ngay cả khi cả hai call đều thành công.
Dùng một giá trị config cho cả write path và read path, rồi validate trên mọi request: input text không rỗng, độ dài vector bằng số chiều đã cấu hình, và mọi giá trị đều là số thực (không NaN, không Inf). Nếu validation thất bại, route item vào retry queue và re-embed với kích thước mặc định của bạn.
Bạn có thể dùng OpenAI SDK với endpoint tương thích như https://ai.crazyrouter.us/v1, rồi pin model và dimensions trong một file config dùng chung cho mọi service.
Kiểm soát kích thước text-embedding-3-small trong vector schema và thiết kế index#
Giữ một số chiều cho mỗi index, và giữ vector truy vấn cùng vector tài liệu ở cùng kích thước đó.
Dùng tên collection khóa theo số chiều như kb_d1536_v1 và kb_d1024_v1. Cách đặt tên này giúp migration dễ đọc và ngăn trộn lẫn âm thầm.
<.-- IMAGE: Sơ đồ kiến trúc hiển thị ingestion, embedding service, dual vector indexes và query router. -->
Khi dimensionality thay đổi, hãy rebuild thiết lập index với vector mới. Với HNSW, retune graph và search settings sau khi rebuild. Với IVF, retrain centroids trên vector từ kích thước chiều mới. Tái sử dụng dữ liệu huấn luyện index cũ có thể làm giảm recall.
Giải thích kích thước text-embedding-3-small khi migration từ model cũ#
Chạy migration theo từng pha:
| Pha | Write path | Read path | Cần kiểm tra gì |
|---|---|---|---|
| Dual-write | Old + new embeddings | Old index | Tỷ lệ write thành công và lỗi validation vector |
| Shadow-read | Old + new embeddings | Người dùng thấy old, log new | Top-k overlap, độ trễ, các trường hợp truy vấn xấu |
| Cutover | Old + new embeddings | New index | Tỷ lệ pass relevance và mục tiêu độ trễ p95 |
| Rollback | Giữ dual-write hoạt động | Chuyển lại old | Kích hoạt khi lỗi tăng đột biến hoặc relevance giảm |
Nguồn: Crazyrouter knowledge base (text-embedding-3-small ở 1536 chiều; OpenAI-compatible API; hơn 300 model được hỗ trợ).
Đây là cốt lõi thực tế của Giải Thích Về Kích Thước text-embedding-3-small: khóa số chiều, kiểm thử bằng shadow traffic, và chỉ cut over sau khi đã đo được parity.
Vận Hành Production: Theo Dõi Drift, Regression Chất Lượng và Workflow Nhóm#
Bạn đã chọn kích thước chiều bằng kiểm thử offline. Đó là khởi đầu tốt. Rủi ro thật xuất hiện về sau, sau khi nội dung mới, mix truy vấn mới và thay đổi xếp hạng tác động đến production. Trong Giải Thích Về Kích Thước text-embedding-3-small, chất lượng dài hạn đến từ một vòng lặp chặt: dữ liệu eval cố định, kiểm tra hành vi live và các bước rollout có kiểm soát.
Thiết lập giám sát drift cho kích thước text-embedding-3-small#
Khóa eval set và metric trước mỗi thay đổi số chiều. Giữ một golden query set khớp với intent thật của người dùng, rồi chấm điểm hằng tuần bằng cùng rubric. Kết hợp nó với tín hiệu live để bạn bắt drift sớm, không phải sau khi ticket hỗ trợ chất đống.
| Tín hiệu | Drift trông như thế nào | Nhịp review | Trigger hành động |
|---|---|---|---|
| Điểm relevance của golden set | Kết quả đầu không còn khớp câu trả lời known-good | Scorecard hằng tuần | Giảm so với lần chạy ổn định gần nhất |
| CTR trên retrieval blocks | Người dùng click ít hơn vào tài liệu được gợi ý | Hằng ngày | Suy giảm kéo dài |
| Tỷ lệ thành công tác vụ | Nhiều session hơn không hoàn tất tác vụ mục tiêu | Hằng ngày | Xu hướng giảm theo phân khúc |
| Tỷ lệ no-result | Phản hồi retrieval rỗng tăng | Hằng ngày | Tăng đột biến sau deploy |
Nguồn bảng: mẫu runbook vận hành dùng trong phần này (golden set + online metrics từ outline được cung cấp).
<.-- IMAGE: Mock dashboard hiển thị điểm golden-set hằng tuần, xu hướng CTR, tỷ lệ no-result và ngưỡng cảnh báo -->
Chạy thử nghiệm kích thước text-embedding-3-small an toàn trong staging và production#
Bắt đầu ở staging với truy vấn được replay từ 7 đến 14 ngày gần nhất. Chuyển sang production bằng một lát canary, rồi mở rộng theo phân khúc người dùng và khu vực. Giữ rollback sẵn sàng. Nếu chất lượng giảm, tạm dừng tăng traffic, chuyển về số chiều ổn định gần nhất và log loại truy vấn nào thất bại. Cách này giữ incident ngắn và cung cấp dữ liệu sạch cho lần kiểm thử tiếp theo.
Workflow nhóm cho các thử nghiệm Giải Thích Về Kích Thước text-embedding-3-small#
Đánh giá liên nhóm thường bị hỏng vì mọi người kiểm thử trong các phiên trình duyệt lẫn lộn. SEO, product và ML có thể ghi đè trạng thái của nhau, rồi không ai còn tin kết quả. Bạn có thể dùng profile cô lập của DICloak để mỗi vai trò kiểm thử cùng một build mà không xung đột session hoặc chồng chéo tài khoản.
Các công cụ như DICloak cho phép bạn đặt proxy và quy tắc session cố định cho từng profile. Điều đó nghĩa là các bài test "US-English account" và "EU account" của bạn chạy trong điều kiện mạng ổn định mỗi lần. Thiết lập có thể tái lập giúp việc kiểm tra ranking dựa trên số chiều dễ so sánh hơn giữa các đồng đội, đồng thời cung cấp một đường dẫn lặp lại, bảo mật cho công việc Giải Thích Về Kích Thước text-embedding-3-small liên tục.
Các Lỗi Thường Gặp và Checklist Chọn Kích Thước Cuối Cùng#
Nếu bạn đã đọc đến đây, Giải Thích Về Kích Thước text-embedding-3-small nên kết thúc bằng một quyết định launch, không phải một phỏng đoán.
Các lỗi về kích thước text-embedding-3-small làm hỏng production#
| Lỗi | Điều gì xảy ra sai | Cần làm gì |
|---|---|---|
| Bạn chỉ tin điểm benchmark của vendor | Tìm kiếm trông ổn trong test, nhưng truy vấn thật của bạn bỏ lỡ intent | Xây dựng eval set nội bộ từ truy vấn người dùng thật, rồi chấm điểm từng thiết lập số chiều trên tập đó |
| Bạn cắt chi phí lưu trữ và bỏ qua kiểm tra chất lượng | Kích thước vector thấp hơn tiết kiệm tiền, nhưng chất lượng click giảm và ticket hỗ trợ tăng | Theo dõi chất lượng retrieval và hành vi người dùng cùng nhau trước rollout |
| Bạn chỉ test relevance | Thiết lập index nhanh vẫn có thể trượt mục tiêu p95 của bạn | Đo độ trễ end-to-end: embed + index search + rerank |
Checklist 10 điểm cuối cùng để go-live Giải Thích Về Kích Thước text-embedding-3-small#
- Dọn trùng lặp và văn bản hỏng trong dữ liệu nguồn.
- Bao phủ truy vấn head, mid và tail trong benchmark của bạn.
- So sánh ít nhất hai kích thước: 1536 (text-embedding-3-small) và 3072 (text-embedding-3-large).
- Ghi lại relevance top-k cho từng kích thước trên cùng query set.
- Ghi lại độ trễ p95 từ API call đến kết quả xếp hạng cuối cùng.
- Chuyển số chiều thành chi phí lưu trữ trên mỗi triệu vector.
- Chạy canary với traffic thật và metric thành công.
- Chuẩn bị các bước rollback trước rollout đầy đủ.
- Gán một owner cho monitoring và phản hồi alert.
- Thiết lập nhịp review retraining hoặc re-embedding.
Chỉ ship khi relevance, độ trễ p95 và chi phí lưu trữ cùng đạt yêu cầu.
<.-- IMAGE: Đồ họa checklist launch một trang cho quyết định kích thước embedding. -->
Câu hỏi thường gặp#
Trong Giải Thích Về Kích Thước text-embedding-3-small, số chiều mặc định tốt nhất để bắt đầu là gì?#
Điểm bắt đầu thực tế là 512 cho hầu hết các nhóm, hoặc 1024 nếu nội dung của bạn phức tạp (pháp lý, kỹ thuật, tài liệu dài). Trong Giải Thích Về Kích Thước text-embedding-3-small, mức này đem lại cân bằng mạnh giữa chất lượng, tốc độ và chi phí mà không cam kết quá mức từ sớm. Sau đó chạy một benchmark nhỏ bằng truy vấn người dùng thật và filter kỳ vọng của bạn. Chọn số chiều nhỏ nhất vẫn đáp ứng mục tiêu relevance, không chỉ số chiều trông tốt nhất trong một toy test.
Việc giảm số chiều trong Giải Thích Về Kích Thước text-embedding-3-small có luôn làm giảm chất lượng retrieval không?#
Số chiều thấp hơn không phải lúc nào cũng làm kết quả xấu đi một cách đáng kể. Với tìm kiếm FAQ ngắn hoặc miền hẹp, mức giảm có thể nhỏ. Với catalog rộng, nội dung đa ngôn ngữ hoặc semantic matching nhiều sắc thái, chất lượng có thể giảm nhanh hơn. Trong Giải Thích Về Kích Thước text-embedding-3-small, hãy coi số chiều là một núm điều chỉnh: so sánh 256, 512 và 1024 trên cùng query set. Giữ kích thước nhỏ nhất vẫn bảo toàn Recall@k và chất lượng xếp hạng chấp nhận được cho người dùng thật của bạn.
Kích thước text-embedding-3-small ảnh hưởng đến chi phí vector database như thế nào?#
Chi phí tỷ lệ gần tuyến tính với số chiều. Nếu bạn cắt vector từ 1024 xuống 512, lưu trữ vector thô khoảng một nửa. Xu hướng tương tự áp dụng cho mức dùng RAM và thường cả compute truy vấn. Nhưng hãy tính cả overhead chỉ mục: cấu trúc ANN thêm bộ nhớ cho graph links, metadata và bookkeeping nội bộ. Vì vậy tổng tiết kiệm là đáng kể, nhưng không chỉ nằm ở byte của vector. Trong thực tế, hãy ước tính kích thước index đầy đủ, không chỉ kích thước embedding, trước khi đặt số chiều cuối cùng.
Tôi có cần re-embed tất cả tài liệu khi thay đổi số chiều không?#
Có. Một vector được tạo ở một số chiều không thể trộn với vector từ số chiều khác trong một index nhất quán. Khi bạn thay đổi số chiều, hãy re-embed toàn bộ tài liệu và rebuild index. Với hệ thống production, dùng migration an toàn hơn: chạy rollout dual-index. Xây index mới song song, gửi một lát traffic tới đó, so sánh chất lượng và độ trễ, rồi chuyển hoàn toàn. Cách này tránh downtime và giữ hành vi tìm kiếm ổn định trong quá trình chuyển đổi.
Tôi nên theo dõi metric nào khi so sánh số chiều?#
Theo dõi ba nhóm: relevance, tốc độ và chi phí. Với relevance, dùng Recall@k, nDCG và MRR trên một query set đã gắn nhãn. Với tốc độ, theo dõi độ trễ p50/p95/p99, vì tail latency ảnh hưởng đến trải nghiệm người dùng. Với chi phí, đo lưu trữ trên mỗi triệu tài liệu, footprint RAM và chi phí trên 1,000 truy vấn. Trong Giải Thích Về Kích Thước text-embedding-3-small, scorecard này giúp bạn tránh lựa chọn một chiều, nơi bạn tiết kiệm lưu trữ nhưng làm tổn hại chất lượng xếp hạng quá nhiều.
text-embedding-3-small có phù hợp cho tìm kiếm đa ngôn ngữ ở số chiều thấp hơn không?#
Có thể hoạt động, nhưng tìm kiếm đa ngôn ngữ cần kiểm thử nghiêm ngặt hơn tìm kiếm đơn ngữ. Số chiều thấp hơn có thể gộp các sắc thái ý nghĩa giữa các ngôn ngữ, đặc biệt với truy vấn ngắn và chữ viết pha trộn. Bắt đầu ở 512 hoặc 1024, rồi kiểm thử theo cặp ngôn ngữ, độ dài truy vấn và thuật ngữ miền. Trong Giải Thích Về Kích Thước text-embedding-3-small, các thiết lập đa ngôn ngữ thường hưởng lợi từ số chiều lớn hơn khi precision quan trọng. Chọn thiết lập nhỏ nhất vẫn đáp ứng mục tiêu relevance cho từng phân khúc ngôn ngữ chính.
Điểm cốt lõi là kích thước text-embedding-3-small là một đòn bẩy điều chỉnh thực tế: số chiều cao hơn có thể cải thiện độ trung thực ngữ nghĩa, trong khi số chiều thấp hơn giảm lưu trữ, độ trễ và chi phí, nên lựa chọn phù hợp phụ thuộc vào mục tiêu chất lượng retrieval và ràng buộc hệ thống của bạn. Hãy coi kích thước chiều là một quyết định thực nghiệm bằng cách benchmark recall, chất lượng xếp hạng và hiệu năng end-to-end trên dữ liệu của chính bạn thay vì dựa vào mặc định. Hãy kiểm thử nhiều kích thước trong pipeline của bạn ngay tuần này, rồi khóa thiết lập production bằng bằng chứng, không phải phỏng đoán.
Implementation Guides
Available in other languages: