简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
text-embedding-3-small Dimensiones Explicadas: Cómo Elegir el Tamaño Correcto para Calidad y Costo
Una guía práctica sobre las dimensiones de text-embedding-3-small, cómo elegir entre 256, 512, 1024 y 1536 dimensiones.
text-embedding-3-small Dimensiones Explicadas: Cómo Elegir el Tamaño Correcto para Calidad y Costo#
Con 1536 dimensiones, un vector de text-embedding-3-small almacenado como float32 usa 6,144 bytes, por lo que 10 millones de vectores necesitan alrededor de 61 GB antes de la sobrecarga del índice. Esa cifra sorprende a los equipos cuando la recuperación parece barata a pequeña escala, pero luego las facturas de memoria suben y el tiempo de consulta crece a medida que el corpus se expande. Lo difícil es que más dimensiones pueden mejorar el ranking en un conjunto de datos, mientras que esa misma configuración puede desperdiciar almacenamiento y añadir latencia en otro.
Ese es el núcleo de text-embedding-3-small Dimensiones Explicadas: no existe una configuración universal que gane en todas las cargas de trabajo. Debes elegir el tamaño de dimensión probando juntos tu objetivo de relevancia, tu límite de latencia p95 y tu presupuesto de almacenamiento vectorial, no uno por uno. Si solo optimizas por calidad, el costo sube rápido. Si solo reduces tamaño, la calidad de búsqueda puede degradarse de formas que los usuarios notan.
Verás un método práctico de selección: crear un pequeño conjunto de evaluación, comparar la relevancia en dos o tres tamaños de dimensión, medir el tiempo de respuesta de extremo a extremo y convertir el número de dimensiones en costo real de almacenamiento por millón de vectores. A partir de ahí, el tamaño correcto se convierte en una decisión de ingeniería medible, no en una conjetura.
Qué Significa "Dimensiones" en text-embedding-3-small (y Por Qué Cambia los Resultados)#
En términos simples, text-embedding-3-small Dimensiones Explicadas significa una cosa: cuánto significado conservas en cada vector. El número de dimensiones es un control de compresión, no un interruptor de calidad. text-embedding-3-small tiene un tamaño máximo de 1536 dimensiones (según la especificación del modelo en la base de conocimiento). Los tamaños menores comprimen más.
text-embedding-3-small dimensiones explicadas: del significado semántico a vectores numéricos#
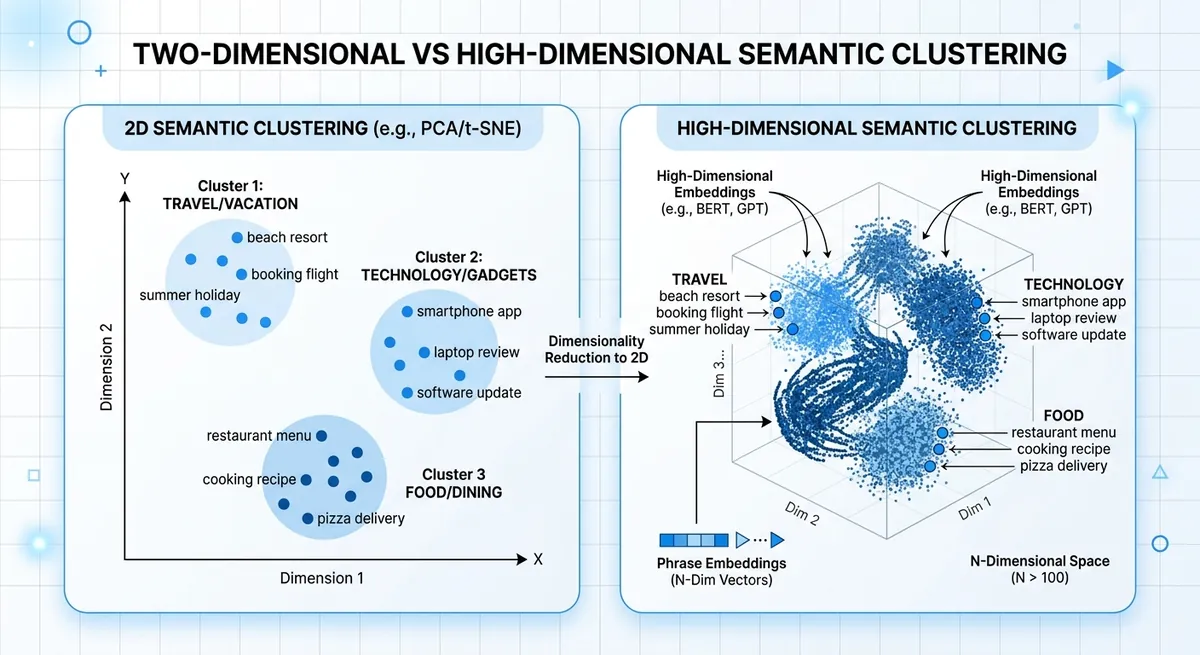
Un embedding convierte texto en números para que frases similares queden cerca entre sí en el espacio vectorial. "Reset my password" y "I cannot sign in" deberían quedar cerca. Cada dimensión adicional da al modelo más espacio para almacenar matices como intención, tono o términos de dominio. Si reduces el vector, conservas el significado central pero pierdes detalles más finos.
Tamaño de dimensión de text-embedding-3-small y cambios en la calidad del ranking#
Menos dimensiones pueden acelerar la búsqueda y reducir el almacenamiento, pero el ranking de vecinos más cercanos puede cambiar. Ese cambio aparece cuando dos intenciones parecen similares en la superficie pero difieren en la acción, como "cancel plan" frente a "pause plan."
| Elección de tamaño de vector | Fidelidad semántica | Velocidad de ejecución | Almacenamiento por 1M de vectores (float32) |
|---|---|---|---|
| 1536 (text-embedding-3-small completo) | Mayor retención de detalle | Más lento que vectores más pequeños | ~6.1 GB |
| 768 (comprimido) | Algo de pérdida de detalle | Más rápido | ~3.1 GB |
| 512 (comprimido) | Mayor riesgo de pérdida en intenciones cercanas | Aún más rápido | ~2.0 GB |
Fuente: dimensión máxima de text-embedding-3-small de la base de conocimiento proporcionada; cálculo de almacenamiento a partir de dimensiones × 4 bytes.
Ese es el núcleo práctico de text-embedding-3-small Dimensiones Explicadas: ajustar dimensiones con pruebas de relevancia, latencia p95 y almacenamiento vectorial en conjunto.
Opciones de Dimensión de text-embedding-3-small: Rangos Prácticos y Tradeoffs#
Para text-embedding-3-small, el tamaño vectorial nativo es de 1536 dimensiones. En sistemas reales, los equipos suelen acortar vectores para reducir RAM, disco y carga del índice ANN. El almacenamiento crece linealmente con el número de dimensiones, así que cada elección de tamaño es una decisión directa de costo y latencia. Este es el núcleo práctico de text-embedding-3-small Dimensiones Explicadas.
text-embedding-3-small Dimensiones Explicadas: configuraciones comunes y mejores casos de uso#
Si necesitas valores iniciales aproximados, esta tabla es un buen mapa de partida para pruebas A/B.
| Dimensión | Almacenamiento bruto por 1M de vectores (float32) | Mejor encaje | Riesgo típico |
|---|---|---|---|
| 256 | ~0.95 GB | Límites estrictos de latencia o presupuesto, coincidencia simple de intención | Más omisiones en consultas con matices |
| 384 | ~1.43 GB | Búsqueda semántica enfocada en costo con textos cortos | Menor recall en casos límite |
| 512 | ~1.91 GB | Búsqueda equilibrada para docs de soporte, ayuda de producto, FAQ | Algo de pérdida de significado de cola larga |
| 768 | ~2.86 GB | Recuperación equilibrada ampliada, estilos de consulta mixtos | Crecimiento moderado del costo de infraestructura |
| 1024 | ~3.81 GB | RAG de alto recall sobre documentos densos | Más memoria de índice y tiempo de consulta |
| 1536 | ~5.72 GB | Recuperación de fidelidad completa, similitud con matices | Mayor presión de almacenamiento y latencia |
Fuente: rangos de dimensión del esquema y la información del modelo proporcionados (text-embedding-3-small = 1536). El almacenamiento se calcula como dimensiones × 4 bytes × 1,000,000 vectores.
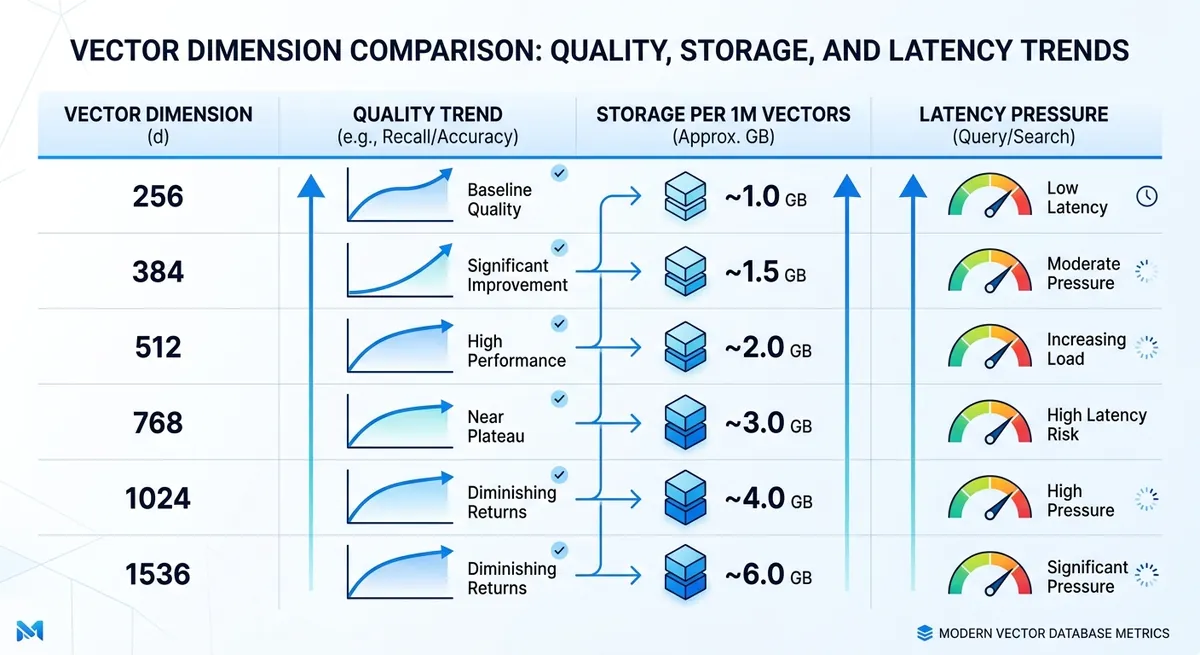
Tradeoffs de calidad de text-embedding-3-small: dónde empieza la degradación#
La pérdida de calidad suele aparecer antes en tareas que exigen mucha precisión. La recuperación de FAQ puede seguir siendo utilizable en 384 o 512, mientras que la búsqueda legal o médica a menudo necesita 1024 o 1536 para conservar diferencias finas de significado.
La mezcla de idiomas también cambia el mínimo seguro. Las cargas monolingües en inglés pueden mantenerse bien con tamaños menores. El tráfico multilingüe, el cambio de idioma dentro de una misma consulta y las escrituras mixtas tienden a degradarse antes cuando los vectores se acortan.
Puedes ejecutar esta prueba rápidamente mediante Crazyrouter con una sola API key y comparar la calidad de recuperación en 512, 768 y 1536 sobre el mismo conjunto de evaluación. Eso da un punto de corte medible en lugar de conjeturas.
Calidad, Latencia y Costo: El Benchmark de Tres Vías que Realmente Necesitas#
Ya viste por qué una sola métrica puede inducir a error. Para text-embedding-3-small Dimensiones Explicadas, el movimiento práctico es probar un objetivo de relevancia, un presupuesto de latencia y un presupuesto de almacenamiento al mismo tiempo. Elige la dimensión más pequeña que todavía supere tu barra de calidad bajo tu límite de latencia p95.
Conjunto de prueba de dimensiones de text-embedding-3-small: crea relevancia offline en la que confíes#
Usa logs reales de búsqueda, tickets de soporte y prompts de chat. Crea 200-500 ejemplos de consulta si puedes. Ese tamaño basta para exponer puntos débiles sin ralentizar al equipo.
Etiqueta qué significa "bueno" para cada consulta. Mantén etiquetas simples: relevante, parcialmente relevante, no relevante. Añade casos difíciles a propósito: consultas cortas, consultas con errores tipográficos, términos de dominio y consultas multilingües. Si tu app atiende idiomas mixtos, incluye consultas en varios idiomas en el mismo conjunto.
No dejes que solo una persona etiquete los resultados. Dos revisores reducen el sesgo rápidamente.
Métricas de benchmark de dimensiones de text-embedding-3-small: calidad y latencia juntas#
Haz seguimiento de la calidad del ranking y la velocidad en una sola ejecución. Recall@k te dice si el elemento correcto aparece en el top-k. MRR y nDCG te dicen si aparece cerca de la parte superior, donde los usuarios hacen clic.
Para la latencia, separa el recorrido: tiempo de embedding y tiempo de recuperación. Observa p95 y p99, no solo la latencia promedio. Las solicitudes lentas de cola determinan la experiencia de usuario.
| Candidato de dimensión | Tamaño conocido por vector (float32) | Memoria relativa de índice | Métricas de calidad a seguir | Métricas de latencia a seguir |
|---|---|---|---|---|
| 1536 (text-embedding-3-small) | 6,144 bytes | Línea base 1x | Recall@k, MRR, nDCG | Latencia de embedding, p95/p99 de recuperación |
| 3072 (text-embedding-3-large) | 12,288 bytes | ~2x vs 1536 | Recall@k, MRR, nDCG | Latencia de embedding, p95/p99 de recuperación |
| Candidato de menor dimensión en tu stack | dims × 4 bytes | dims / 1536 | Recall@k, MRR, nDCG | Latencia de embedding, p95/p99 de recuperación |
Fuente: dimensiones de modelo de la lista de modelos de Crazyrouter (text-embedding-3-small: 1536, text-embedding-3-large: 3072). El cálculo de bytes usa vectores float32.
Modelo de costo de dimensiones de text-embedding-3-small: del almacenamiento al impacto de negocio#
Convierte dimensiones en dinero antes del despliegue.
Almacenamiento por millón de vectores = dimension × 4 bytes × 1,000,000, luego multiplica por el número de réplicas. Añade la sobrecarga de índice de tu base de datos vectorial.
<.-- IMAGE: Infografía estilo fórmula para estimar almacenamiento vectorial y costo anual por dimensión y tamaño de corpus. -->
Ahora conecta la mejora de calidad con señales de negocio que ya sigues, como CTR, desvío de tickets o conversión. Si una dimensión mayor mejora un poco nDCG pero duplica memoria y no cumple p95, conserva la configuración menor. Si mejora la relevancia ordenada lo suficiente como para mover la conversión, tienes un caso de negocio claro.
Cómo Elegir la Dimensión Correcta por Caso de Uso#
Si todavía estás adivinando el tamaño de dimensión, esta parte de text-embedding-3-small Dimensiones Explicadas es el atajo: asigna la dimensión a la carga de trabajo y luego verifica con un pequeño conjunto de evaluación antes del despliegue.
text-embedding-3-small Dimensiones Explicadas para RAG y búsqueda empresarial#
RAG y la búsqueda interna fallan rápido cuando cae el recall. Los usuarios hacen una pregunta y luego abandonan si los resultados principales no contienen hechos clave. Por eso tu punto de partida debería ser la calidad, no el almacenamiento.
Usa 1536 como línea base para text-embedding-3-small, luego prueba un solo tamaño menor únicamente después de confirmar el recall en consultas difíciles. Consultas difíciles significa preguntas largas, términos raros e intención mixta.
El chunking cambia el resultado más de lo que la gente espera. Chunks pequeños más dimensiones bajas pueden perder contexto dos veces: una al dividir, otra al generar el embedding. Si tus chunks son cortos, mantén dimensiones más altas. Si tus chunks son largos y limpios, puedes probar un tamaño menor sin riesgo a ciegas.
Dimensiones de text-embedding-3-small para recomendaciones, clustering y enrutamiento semántico#
Estos sistemas suelen priorizar velocidad y agrupamiento estable, no un recall top-1 perfecto. Una configuración media a menudo ofrece el mejor tradeoff.
Para enrutamiento, la similitud aproximada suele ser suficiente porque un modelo de segunda etapa puede reordenar o verificar. Eso significa que puedes probar dimensiones menores antes de lo que harías en RAG. Para clustering, evalúa la pureza de los clusters y la deriva sobre datos semanales, no solo una ejecución offline.
Elige la dimensión más pequeña que todavía mantenga estable tu métrica downstream durante dos ciclos completos de tráfico.
text-embedding-3-small Dimensiones Explicadas para cargas multilingües y específicas de dominio#
El lenguaje de dominio cambia las reglas. Términos legales, médicos o de hardware pueden estar cerca en lenguaje común pero lejos en significado. Menos dimensiones pueden difuminar estos límites.
El tráfico multilingüe necesita comprobaciones por idioma. No promedies todo en una sola puntuación. Ejecuta el mismo conjunto de intenciones en cada segmento principal de idioma y luego compara patrones de omisión. Un tamaño que funciona en inglés puede fallar en consultas de idioma mixto o términos transliterados.
| Caso de uso | Dimensión inicial recomendada | Qué medir antes de reducir | Señal común de fallo |
|---|---|---|---|
| RAG / búsqueda empresarial | 1536 | Recall en consultas difíciles, grounding de respuestas | El documento correcto no aparece en los resultados superiores |
| Recomendaciones | Media (probar por debajo de 1536) | Estabilidad de CTR o conversión | Suben elementos similares pero irrelevantes |
| Enrutamiento semántico | Media a baja | Precisión de ruta + tasa de fallback | Ruta incorrecta, mayor fallback |
| Multilingüe / alta carga de dominio | 1536 | Recall por idioma, errores a nivel de término | Términos raros asignados a significado genérico |
Fuente: información de dimensiones de modelo de la lista de modelos de Crazyrouter (text-embedding-3-small: 1536, text-embedding-3-large: 3072). <.-- IMAGE: Matriz de decisión por caso de uso (RAG, recsys, routing, multilingüe) con dimensiones iniciales recomendadas. -->
Guía de Implementación: API, Esquema Vectorial y Pasos de Migración#
text-embedding-3-small dimensiones explicadas en solicitudes de API#
La línea base segura para text-embedding-3-small es 1536 dimensiones. Puedes solicitar un tamaño menor con el campo dimensions, pero mantén ese tamaño fijo por índice. Si los vectores de documentos usan 1024 y los vectores de consulta usan 1536, la calidad de recuperación derivará aunque ambas llamadas funcionen.
Usa un único valor de configuración para las rutas de escritura y lectura, y luego valida en cada solicitud: el texto de entrada no está vacío, la longitud del vector coincide con la dimensión configurada y cada valor es un número real (sin NaN, sin Inf). Si la validación falla, envía el elemento a una cola de reintentos y vuelve a generar el embedding con tu tamaño predeterminado.
Puedes usar el OpenAI SDK con un endpoint compatible como https://ai.crazyrouter.us/v1, y luego fijar el modelo y las dimensiones en un único archivo de configuración compartido por todos los servicios.
Control de dimensión de text-embedding-3-small en el esquema vectorial y diseño de índice#
Mantén una dimensión por índice, y mantén los vectores de consulta y documento en ese mismo tamaño.
Usa nombres de colección bloqueados por dimensión como kb_d1536_v1 y kb_d1024_v1. Esta nomenclatura hace que las migraciones sean legibles y evita mezclas silenciosas.
<.-- IMAGE: Diagrama de arquitectura que muestra ingesta, servicio de embeddings, índices vectoriales duales y router de consultas. -->
Cuando cambia la dimensionalidad, reconstruye la configuración del índice con los nuevos vectores. Para HNSW, vuelve a ajustar los parámetros de grafo y búsqueda después de la reconstrucción. Para IVF, vuelve a entrenar centroides con vectores del nuevo tamaño de dimensión. Reutilizar datos antiguos de entrenamiento de índice puede perjudicar el recall.
text-embedding-3-small dimensiones explicadas para migración desde modelos anteriores#
Ejecuta la migración por fases:
| Fase | Ruta de escritura | Ruta de lectura | Qué comprobar |
|---|---|---|---|
| Escritura dual | Embeddings antiguos + nuevos | Índice antiguo | Tasa de éxito de escritura y errores de validación vectorial |
| Lectura en sombra | Embeddings antiguos + nuevos | El usuario ve lo antiguo, se registra lo nuevo | Solapamiento top-k, latencia, casos de consulta problemáticos |
| Cambio | Embeddings antiguos + nuevos | Índice nuevo | Tasa de aprobación de relevancia y objetivo de latencia p95 |
| Rollback | Mantener escritura dual activa | Volver al antiguo | Activar ante pico de errores o caída de relevancia |
Fuente: base de conocimiento de Crazyrouter (text-embedding-3-small en 1536 dimensiones; API compatible con OpenAI; más de 300 modelos soportados).
Este es el núcleo práctico de text-embedding-3-small Dimensiones Explicadas: bloquear dimensiones, probar con tráfico en sombra y hacer el cambio solo después de medir paridad.
Operaciones en Producción: Monitoreo de Deriva, Regresiones de Calidad y Flujo de Trabajo del Equipo#
Elegiste un tamaño de dimensión con pruebas offline. Buen comienzo. El riesgo real aparece después, cuando nuevo contenido, una nueva mezcla de consultas y cambios de ranking llegan a producción. En text-embedding-3-small Dimensiones Explicadas, la calidad a largo plazo viene de un ciclo cerrado: datos de evaluación fijos, comprobaciones de comportamiento en vivo y pasos de despliegue controlados.
Configurar monitoreo de deriva de dimensiones de text-embedding-3-small#
Bloquea tu conjunto de evaluación y métricas antes de cada cambio de dimensión. Mantén un conjunto dorado de consultas que coincida con la intención real del usuario, luego puntúalo cada semana con la misma rúbrica. Combínalo con señales en vivo para detectar deriva temprano, no después de que se acumulen tickets de soporte.
| Señal | Cómo se ve la deriva | Cadencia de revisión | Disparador de acción |
|---|---|---|---|
| Puntuación de relevancia del conjunto dorado | Los resultados superiores dejan de coincidir con respuestas conocidas como buenas | Scorecard semanal | Caída frente a la última ejecución estable |
| CTR en bloques de recuperación | Los usuarios hacen menos clic en docs sugeridos | Diario | Descenso sostenido |
| Tasa de éxito de tarea | Más sesiones no logran completar la tarea objetivo | Diario | Tendencia descendente por segmento |
| Tasa sin resultados | Aumentan las respuestas de recuperación vacías | Diario | Pico después del despliegue |
Fuente de la tabla: patrón de runbook operativo usado en esta sección (conjunto dorado + métricas online del esquema proporcionado).
<.-- IMAGE: Mock de dashboard que muestra puntuación semanal del conjunto dorado, tendencia de CTR, tasa sin resultados y umbrales de alerta -->
Ejecutar experimentos de dimensiones de text-embedding-3-small de forma segura en staging y producción#
Empieza en staging con consultas reproducidas de los últimos 7 a 14 días. Pasa a producción con un segmento canary y luego expande por segmento de usuario y región. Mantén listo el rollback. Si la calidad cae, pausa el crecimiento de tráfico, vuelve a la última dimensión estable y registra qué tipos de consulta fallaron. Esto mantiene los incidentes cortos y da datos limpios para la siguiente prueba.
Flujo de trabajo de equipo para experimentos de text-embedding-3-small Dimensiones Explicadas#
La evaluación entre equipos suele romperse porque las personas prueban en sesiones de navegador mezcladas. SEO, producto y ML pueden sobrescribir el estado de los demás, y luego nadie confía en el resultado. Puedes usar perfiles aislados de DICloak para que cada rol pruebe la misma build sin conflictos de sesión ni cruces de cuenta.
Herramientas como DICloak te permiten fijar reglas de proxy y sesión por perfil. Eso significa que tus pruebas de "US-English account" y "EU account" se ejecutan cada vez en condiciones de red estables. Una configuración reproducible facilita comparar comprobaciones de ranking basadas en dimensiones entre compañeros de equipo, y te da una ruta repetible y segura para el trabajo continuo de text-embedding-3-small Dimensiones Explicadas.
Errores Comunes y una Checklist Final de Selección de Dimensión#
Si has llegado hasta aquí, text-embedding-3-small Dimensiones Explicadas debería terminar en una decisión de lanzamiento, no en una conjetura.
Errores de dimensión de text-embedding-3-small que rompen producción#
| Error | Qué sale mal | Qué hacer |
|---|---|---|
| Confías solo en puntuaciones de benchmarks del proveedor | La búsqueda parece bien en pruebas, pero tus consultas reales pierden intención | Crea un conjunto de evaluación interno a partir de consultas reales de usuarios y luego puntúa cada configuración de dimensión en ese conjunto |
| Reduces costo de almacenamiento y omites comprobaciones de calidad | El tamaño vectorial menor ahorra dinero, pero cae la calidad de clics y suben los tickets de soporte | Haz seguimiento conjunto de calidad de recuperación y comportamiento de usuario antes del despliegue |
| Solo pruebas relevancia | Una configuración de índice rápida aún puede incumplir tu objetivo p95 | Mide latencia de extremo a extremo: embed + búsqueda en índice + rerank |
Checklist final de 10 puntos para el go-live de text-embedding-3-small Dimensiones Explicadas#
- Limpia duplicados y texto roto en los datos fuente.
- Cubre consultas head, mid y tail en tu benchmark.
- Compara al menos dos tamaños: 1536 (text-embedding-3-small) y 3072 (text-embedding-3-large).
- Registra la relevancia top-k de cada tamaño sobre el mismo conjunto de consultas.
- Registra la latencia p95 desde la llamada a la API hasta el resultado ordenado final.
- Convierte el número de dimensiones en costo de almacenamiento por millón de vectores.
- Ejecuta un canary con tráfico real y métricas de éxito.
- Prepara pasos de rollback antes del despliegue completo.
- Asigna un único owner para monitoreo y respuesta a alertas.
- Define una cadencia de revisión para reentrenamiento o re-embedding.
Lanza solo cuando relevancia, latencia p95 y costo de almacenamiento pasen juntos.
<.-- IMAGE: Gráfico de checklist de lanzamiento de una página para decisiones de dimensión de embeddings. -->
Preguntas frecuentes#
En text-embedding-3-small Dimensiones Explicadas, ¿cuál es la mejor dimensión predeterminada para empezar?#
Un punto de partida práctico es 512 para la mayoría de los equipos, o 1024 si tu contenido es complejo (legal, técnico, docs de formato largo). En text-embedding-3-small Dimensiones Explicadas, esto ofrece un equilibrio sólido de calidad, velocidad y costo sin comprometerte demasiado pronto. Luego ejecuta un pequeño benchmark usando tus consultas reales de usuarios y los filtros esperados. Elige la dimensión más pequeña que todavía cumpla tu objetivo de relevancia, no solo la que se vea mejor en una prueba de juguete.
¿Reducir dimensiones en text-embedding-3-small Dimensiones Explicadas siempre reduce la calidad de recuperación?#
Menos dimensiones no siempre perjudican los resultados de forma significativa. Para búsqueda de FAQ cortas o dominios estrechos, la caída puede ser pequeña. Para catálogos amplios, contenido multilingüe o coincidencia semántica con matices, la calidad puede caer más rápido. En text-embedding-3-small Dimensiones Explicadas, trata la dimensión como un control de ajuste: compara 256, 512 y 1024 sobre el mismo conjunto de consultas. Mantén el tamaño más pequeño que preserve Recall@k y calidad de ranking aceptables para tus usuarios reales.
¿Cómo afectan las dimensiones de text-embedding-3-small al costo de la base de datos vectorial?#
El costo escala aproximadamente de forma lineal con el número de dimensiones. Si reduces vectores de 1024 a 512, el almacenamiento vectorial bruto es aproximadamente la mitad. La misma tendencia aplica al uso de RAM y, a menudo, al cómputo de consulta. Pero incluye la sobrecarga del índice: las estructuras ANN añaden memoria para enlaces de grafo, metadatos y contabilidad interna. Así que el ahorro total es fuerte, pero no son solo los bytes del vector. En la práctica, estima el tamaño completo del índice, no solo el tamaño del embedding, antes de fijar una dimensión final.
¿Necesito volver a generar embeddings para todos los documentos al cambiar dimensiones?#
Sí. Un vector creado con una dimensión no puede mezclarse con vectores de otra dimensión en un índice consistente. Cuando cambias dimensiones, vuelve a generar embeddings para todos los documentos y reconstruye el índice. Para sistemas en producción, usa una migración más segura: ejecuta un despliegue de índice dual. Crea el nuevo índice en paralelo, envíale una parte del tráfico, compara calidad y latencia, y luego cambia por completo. Esto evita downtime y mantiene estable el comportamiento de búsqueda durante la transición.
¿Qué métricas debería seguir al comparar dimensiones?#
Sigue tres grupos: relevancia, velocidad y costo. Para relevancia, usa Recall@k, nDCG y MRR sobre un conjunto de consultas etiquetado. Para velocidad, observa la latencia p50/p95/p99, ya que la latencia de cola afecta la experiencia de usuario. Para costo, mide almacenamiento por millón de docs, huella de RAM y costo por 1,000 consultas. En text-embedding-3-small Dimensiones Explicadas, esta scorecard te ayuda a evitar decisiones unilaterales donde ahorras almacenamiento pero dañas demasiado la calidad del ranking.
¿text-embedding-3-small es adecuado para búsqueda multilingüe con dimensiones bajas?#
Puede funcionar, pero la búsqueda multilingüe necesita pruebas más estrictas que la búsqueda en un solo idioma. Menos dimensiones pueden fusionar significados sutiles entre idiomas, especialmente en consultas cortas y escrituras mixtas. Empieza en 512 o 1024, luego prueba por par de idiomas, longitud de consulta y términos de dominio. En text-embedding-3-small Dimensiones Explicadas, las configuraciones multilingües suelen beneficiarse de dimensiones mayores cuando importa la precisión. Elige la configuración más pequeña que todavía cumpla los objetivos de relevancia para cada segmento de idioma clave.
La idea central es que las dimensiones de text-embedding-3-small son una palanca práctica de ajuste: las dimensiones más altas pueden mejorar la fidelidad semántica, mientras que las dimensiones más bajas reducen almacenamiento, latencia y costo, así que la elección correcta depende de tus objetivos de calidad de recuperación y de las restricciones del sistema. Trata el tamaño de dimensión como una decisión empírica mediante benchmarks de recall, calidad de ranking y rendimiento de extremo a extremo sobre tus propios datos, en lugar de depender de valores predeterminados. Prueba varias dimensiones en tu propio pipeline esta semana y luego fija tu configuración de producción con evidencia, no conjeturas.
Implementation Guides
Available in other languages: