简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
text-embedding-3-small: Объяснение размерности. Как выбрать оптимальный размер для качества и стоимости
Практическое руководство по размерности text-embedding-3-small, как выбрать между 256, 512, 1024 и 1536 измерениями.
text-embedding-3-small: Объяснение размерности. Как выбрать оптимальный размер для качества и стоимости#
При 1536 измерениях один вектор text-embedding-3-small, сохраненный как float32, занимает 6,144 байта, поэтому 10 миллионов векторов требуют около 61 GB еще до накладных расходов индекса. Это часто застает команды врасплох: на малом масштабе retrieval кажется дешевым, а затем, по мере роста корпуса, увеличиваются счета за память и время запросов. Сложность в том, что большая размерность может улучшить ранжирование на одном наборе данных, но на другом та же настройка будет зря расходовать хранилище и добавлять задержку.
В этом и состоит суть text-embedding-3-small Dimensions Explained: не существует универсальной настройки, которая выигрывает на любой нагрузке. Размерность нужно выбирать, одновременно проверяя целевой уровень релевантности, ограничение p95 latency и бюджет на векторное хранилище, а не по отдельности. Если оптимизировать только качество, стоимость быстро растет. Если только сокращать размер, качество поиска может просесть так, что пользователи это заметят.
Ниже вы увидите практический метод выбора: собрать небольшой eval set, сравнить релевантность на двух или трех размерах размерности, измерить end-to-end response time и перевести количество измерений в реальную стоимость хранения на миллион векторов. После этого правильный размер становится измеримым инженерным решением, а не догадкой.
Что означает "Dimensions" в text-embedding-3-small и почему это меняет результат#
Проще говоря, text-embedding-3-small Dimensions Explained означает одно: сколько смысла вы сохраняете в каждом векторе. Количество измерений — это ручка сжатия, а не переключатель качества. Максимальный размер text-embedding-3-small составляет 1536 измерений (согласно спецификации модели в базе знаний). Меньшие размеры означают более сильное сжатие.
text-embedding-3-small dimensions explained: от семантического смысла к числовым векторам#
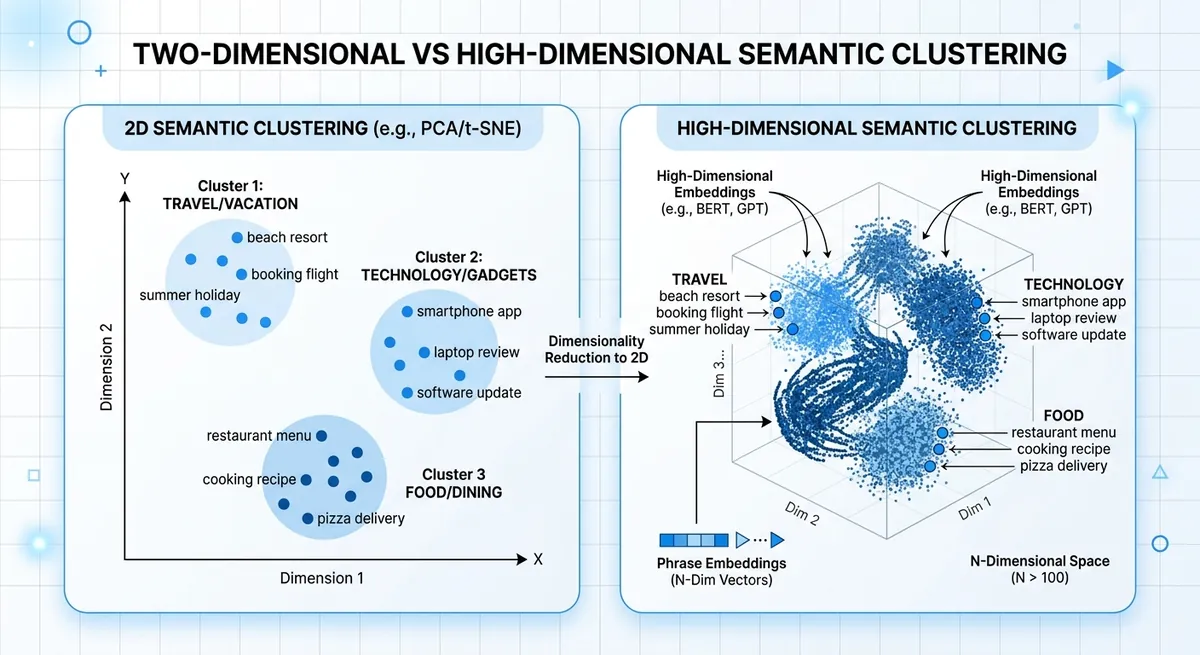
Embedding превращает текст в числа, чтобы похожие фразы оказывались рядом друг с другом в векторном пространстве. "Reset my password" и "I cannot sign in" должны располагаться близко. Каждое дополнительное измерение дает модели больше пространства для хранения нюансов, таких как намерение, тон или доменные термины. Если уменьшить вектор, вы сохраните основной смысл, но потеряете более тонкие детали.
Размерность text-embedding-3-small и изменения качества ранжирования#
Меньшая размерность может ускорить поиск и сократить объем хранения, но ранжирование ближайших соседей может измениться. Это проявляется, когда два намерения выглядят похожими на поверхности, но отличаются по действию, например "cancel plan" и "pause plan."
| Выбор размера вектора | Семантическая точность | Скорость выполнения | Хранилище на 1M векторов (float32) |
|---|---|---|---|
| 1536 (полный text-embedding-3-small) | Максимальное сохранение деталей | Медленнее, чем меньшие векторы | ~6.1 GB |
| 768 (сжатый) | Некоторая потеря деталей | Быстрее | ~3.1 GB |
| 512 (сжатый) | Более высокий риск потерь для близких намерений | Еще быстрее | ~2.0 GB |
Источник: максимальная размерность text-embedding-3-small из предоставленной базы знаний; расчет хранилища: dimensions × 4 bytes.
Практическая суть text-embedding-3-small Dimensions Explained такова: настраивайте размерность вместе с тестами релевантности, p95 latency и векторным хранилищем.
Варианты размерности text-embedding-3-small: практические диапазоны и компромиссы#
Для text-embedding-3-small нативный размер вектора составляет 1536 измерений. В реальных системах команды часто укорачивают векторы, чтобы снизить нагрузку на RAM, disk и ANN index. Объем хранения растет линейно с количеством измерений, поэтому каждый выбор размера напрямую влияет на стоимость и задержку. Это практическая основа text-embedding-3-small Dimensions Explained.
text-embedding-3-small Dimensions Explained: распространенные настройки и подходящие сценарии#
Если вам нужны примерные значения по умолчанию, эта таблица — хорошая отправная карта для A/B tests.
| Dimension | Raw storage per 1M vectors (float32) | Best fit | Typical risk |
|---|---|---|---|
| 256 | ~0.95 GB | Жесткие ограничения latency или бюджета, простое сопоставление намерений | Больше пропусков в нюансированных запросах |
| 384 | ~1.43 GB | Семантический поиск с фокусом на стоимость для коротких текстов | Более низкий recall в пограничных случаях |
| 512 | ~1.91 GB | Сбалансированный поиск по support docs, product help, FAQ | Некоторая потеря long-tail смысла |
| 768 | ~2.86 GB | Retrieval уровня balanced-plus, смешанные стили запросов | Умеренный рост инфраструктурных затрат |
| 1024 | ~3.81 GB | High-recall RAG по плотным документам | Более высокая память индекса и query time |
| 1536 | ~5.72 GB | Full-fidelity retrieval, нюансированное сходство | Максимальное давление на хранилище и latency |
Источник: диапазоны размерности из предоставленного плана и информации о модели (text-embedding-3-small = 1536). Хранилище рассчитывается как dimensions × 4 bytes × 1,000,000 vectors.
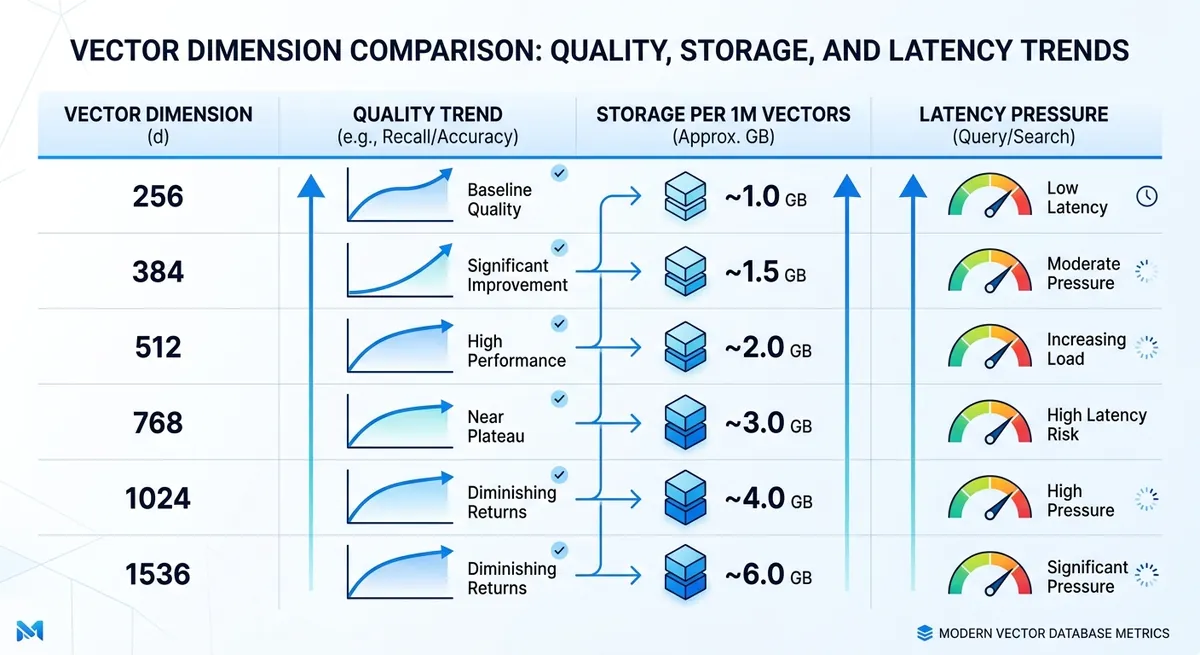
Компромиссы качества text-embedding-3-small: где начинается деградация#
Потеря качества обычно проявляется раньше в задачах, где важна точность. FAQ retrieval может оставаться пригодным на 384 или 512, тогда как юридический или медицинский поиск часто требует 1024 или 1536, чтобы сохранять тонкие смысловые различия.
Языковая смесь также меняет безопасный нижний порог. Моноязычные англоязычные нагрузки могут держаться на меньших размерах. Многоязычный трафик, code-switching и смешанные письменности обычно деградируют раньше, когда векторы становятся короткими.
Вы можете быстро провести этот тест через Crazyrouter с одним API key и сравнить retrieval quality при 512, 768 и 1536 на одном и том же eval set. Это дает измеримую точку отсечения вместо догадок.
Качество, задержка и стоимость: трехсторонний benchmark, который действительно нужен#
Вы уже видели, почему один показатель может вводить в заблуждение. Для text-embedding-3-small Dimensions Explained практический шаг — одновременно тестировать одну цель релевантности, один бюджет задержки и один бюджет хранения. Выберите минимальную размерность, которая все еще проходит вашу планку качества при вашем ограничении p95 latency.
Тестовый набор размерности text-embedding-3-small: соберите offline relevance, которому можно доверять#
Используйте реальные search logs, support tickets и chat prompts. Если возможно, соберите 200–500 примеров запросов. Такого размера достаточно, чтобы выявить слабые места и не замедлить команду.
Определите, что означает "good" для каждого запроса. Держите разметку простой: relevant, partially relevant, not relevant. Намеренно добавьте сложные случаи: короткие запросы, запросы с опечатками, доменные термины и многоязычные запросы. Если ваше приложение обслуживает смешанные языки, включите mixed-language queries в тот же набор.
Не допускайте, чтобы результаты размечал только один человек. Два reviewer быстро снижают bias.
Метрики benchmark для размерности text-embedding-3-small: качество и задержка вместе#
Отслеживайте качество ранжирования и скорость в одном запуске. Recall@k показывает, появляется ли правильный элемент в top-k. MRR и nDCG показывают, находится ли он ближе к вершине, куда кликают пользователи.
Для latency разделите путь: embedding time и retrieval time. Следите за p95 и p99, а не только за average latency. Медленные tail requests формируют пользовательский опыт.
| Dimension candidate | Known size per vector (float32) | Relative index memory | Quality metrics to track | Latency metrics to track |
|---|---|---|---|---|
| 1536 (text-embedding-3-small) | 6,144 bytes | 1x baseline | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| 3072 (text-embedding-3-large) | 12,288 bytes | ~2x vs 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| Кандидат меньшей размерности в вашем стеке | dims × 4 bytes | dims / 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
Источник: размерности моделей из списка моделей Crazyrouter (text-embedding-3-small: 1536, text-embedding-3-large: 3072). Расчет байтов использует векторы float32.
Модель стоимости размерности text-embedding-3-small: от хранилища к бизнес-влиянию#
Переведите размерность в деньги до rollout.
Хранилище на миллион векторов = dimension × 4 bytes × 1,000,000, затем умножьте на количество реплик. Добавьте накладные расходы индекса из вашей vector database.
<.-- IMAGE: Инфографика в стиле формулы для оценки векторного хранилища и годовой стоимости по размерности и размеру корпуса. -->
Теперь свяжите прирост качества с бизнес-сигналами, которые вы уже отслеживаете, например CTR, ticket deflection или conversion. Если большая размерность немного повышает nDCG, но удваивает память и не проходит p95, оставьте меньшую настройку. Если она достаточно повышает ranked relevance, чтобы повлиять на conversion, у вас есть понятное бизнес-обоснование.
Как выбрать правильную размерность по сценарию использования#
Если вы все еще угадываете размерность, эта часть text-embedding-3-small Dimensions Explained — короткий путь: сопоставьте размерность с нагрузкой, затем проверьте на небольшом eval set перед rollout.
text-embedding-3-small Dimensions Explained для RAG и enterprise search#
RAG и внутренний поиск быстро ломаются при падении recall. Пользователи задают один вопрос и уходят, если top results не содержат ключевые факты. Поэтому отправной точкой должно быть качество, а не хранилище.
Используйте 1536 как baseline для text-embedding-3-small, а затем тестируйте только один меньший размер после того, как подтвердите recall на сложных запросах. Сложные запросы — это длинные вопросы, редкие термины и смешанные намерения.
Chunking меняет результат сильнее, чем многие ожидают. Малые chunks плюс низкая размерность могут дважды потерять контекст: сначала при разбиении, затем при embedding. Если ваши chunks короткие, держите более высокую размерность. Если chunks длинные и чистые, можно тестировать меньший размер без слепого риска.
Размерности text-embedding-3-small для recommendations, clustering и semantic routing#
Этим системам обычно важны скорость и стабильная группировка, а не идеальный top-1 recall. Средняя настройка часто дает лучший компромисс.
Для routing приблизительного сходства часто достаточно, потому что модель второго этапа может re-rank или verify. Это значит, что меньшие размерности можно тестировать раньше, чем в RAG. Для clustering оценивайте cluster purity и drift по еженедельным данным, а не только по одному offline run.
Выберите минимальную размерность, которая сохраняет стабильность вашей downstream metric в течение двух полных циклов трафика.
text-embedding-3-small Dimensions Explained для многоязычных и доменно-специфичных нагрузок#
Доменный язык меняет правила. Юридические, медицинские или hardware термины могут быть близки в обычном языке, но далеки по смыслу. Меньшая размерность может размыть эти границы.
Многоязычный трафик требует проверок по каждому языку. Не усредняйте все в один score. Запустите один и тот же набор намерений по каждому крупному языковому сегменту, затем сравните паттерны пропусков. Размер, который работает на английском, может провалиться на mixed-language queries или транслитерированных терминах.
| Use case | Recommended starting dimension | What to measure before lowering | Common failure sign |
|---|---|---|---|
| RAG / enterprise search | 1536 | Recall на сложных запросах, answer grounding | Правильного документа нет в top results |
| Recommendations | Medium (test below 1536) | Стабильность CTR или conversion | Поднимаются похожие, но нерелевантные элементы |
| Semantic routing | Medium to lower | Route accuracy + fallback rate | Неверный route, более высокий fallback |
| Multilingual / domain-heavy | 1536 | Per-language recall, ошибки на уровне терминов | Редкие термины сопоставляются с общим смыслом |
Источник: информация о размерности моделей из списка моделей Crazyrouter (text-embedding-3-small: 1536, text-embedding-3-large: 3072). <.-- IMAGE: Матрица решений по use case (RAG, recsys, routing, multilingual) с рекомендуемыми стартовыми размерностями. -->
Руководство по реализации: API, векторная схема и шаги миграции#
Объяснение размерности text-embedding-3-small в API requests#
Безопасный baseline для text-embedding-3-small — 1536 измерений. Вы можете запросить меньший размер через поле dimensions, но держите этот размер фиксированным для каждого индекса. Если document vectors используют 1024, а query vectors — 1536, качество retrieval будет дрейфовать, даже если оба вызова проходят успешно.
Используйте одно config value для write и read paths, затем валидируйте каждый request: входной текст не пустой, длина вектора равна настроенной размерности, и каждое значение является действительным числом (без NaN, без Inf). Если validation fails, отправьте элемент в retry queue и заново выполните embedding с вашим default size.
Можно использовать OpenAI SDK с совместимым endpoint вроде https://ai.crazyrouter.us/v1, затем закрепить model и dimensions в одном общем config file, который используют все services.
Управление размерностью text-embedding-3-small в vector schema и index design#
Держите одну размерность на индекс, а query и document vectors — в одном и том же размере.
Используйте dimension-locked collection names, такие как kb_d1536_v1 и kb_d1024_v1. Такое именование делает миграции читаемыми и предотвращает незаметное смешивание.
<.-- IMAGE: Архитектурная схема, показывающая ingestion, embedding service, dual vector indexes и query router. -->
Когда dimensionality меняется, перестройте index settings с новыми векторами. Для HNSW заново настройте graph и search settings после rebuild. Для IVF заново обучите centroids на векторах новой размерности. Повторное использование старых index training data может ухудшить recall.
text-embedding-3-small dimensions explained для миграции со старых моделей#
Проводите миграцию по фазам:
| Phase | Write path | Read path | What to check |
|---|---|---|---|
| Dual-write | Old + new embeddings | Old index | Write success rate и vector validation errors |
| Shadow-read | Old + new embeddings | User sees old, logs new | Top-k overlap, latency, bad query cases |
| Cutover | Old + new embeddings | New index | Relevance pass rate и p95 latency target |
| Rollback | Keep dual-write active | Switch back to old | Trigger on error spike or relevance drop |
Источник: база знаний Crazyrouter (text-embedding-3-small at 1536 dimensions; OpenAI-compatible API; 300+ supported models).
Это практическая основа text-embedding-3-small Dimensions Explained: зафиксируйте размерность, тестируйте с shadow traffic и переходите только после измеренного parity.
Эксплуатация в production: мониторинг drift, регрессий качества и командный процесс#
Вы выбрали размерность с помощью offline tests. Хорошее начало. Реальный риск проявляется позже, когда новый контент, новая смесь запросов и изменения ранжирования попадают в production. В text-embedding-3-small Dimensions Explained долгосрочное качество обеспечивается плотным циклом: фиксированные eval data, проверки live behavior и контролируемые этапы rollout.
Настройте мониторинг drift размерности text-embedding-3-small#
Зафиксируйте eval set и metrics перед каждым изменением размерности. Держите golden query set, который соответствует реальным пользовательским намерениям, затем оценивайте его каждую неделю по одной и той же rubric. Совмещайте это с live signals, чтобы ловить drift рано, а не после накопления support tickets.
| Signal | What drift looks like | Review cadence | Action trigger |
|---|---|---|---|
| Golden set relevance score | Top results перестают совпадать с known-good answers | Weekly scorecard | Падение относительно последнего стабильного run |
| CTR on retrieval blocks | Пользователи меньше кликают по suggested docs | Daily | Устойчивое снижение |
| Task success rate | Больше sessions не завершают целевую задачу | Daily | Нисходящий тренд по segment |
| No-result rate | Растет число пустых retrieval responses | Daily | Spike after deploy |
Источник таблицы: operational runbook pattern, использованный в этом разделе (golden set + online metrics из предоставленного плана).
<.-- IMAGE: Макет dashboard с weekly golden-set score, CTR trend, no-result rate и alert thresholds -->
Безопасно проводите эксперименты с размерностью text-embedding-3-small в staging и production#
Начните в staging с replayed queries за последние 7 to 14 days. Перейдите в production с canary slice, затем расширяйтесь по user segment и region. Держите rollback готовым. Если качество падает, приостановите рост трафика, переключитесь на последнюю стабильную размерность и залогируйте, какие типы запросов провалились. Это сокращает incidents и дает чистые данные для следующего теста.
Командный процесс для экспериментов text-embedding-3-small Dimensions Explained#
Межкомандная оценка часто ломается, потому что люди тестируют в смешанных browser sessions. SEO, product и ML могут перезаписывать состояние друг друга, после чего никто не доверяет результату. Вы можете использовать изолированные профили DICloak, чтобы каждая роль тестировала одну и ту же build без session conflicts или account crossover.
Инструменты вроде DICloak позволяют задавать fixed proxy и session rules для каждого profile. Это означает, что тесты вашего "US-English account" и "EU account" каждый раз выполняются в стабильных сетевых условиях. Воспроизводимая настройка упрощает сравнение проверок ranking на основе размерности между teammates и дает повторяемый, безопасный путь для текущей работы над text-embedding-3-small Dimensions Explained.
Распространенные ошибки и финальный checklist выбора размерности#
Если вы дочитали до этого места, text-embedding-3-small Dimensions Explained должен закончиться решением о запуске, а не догадкой.
Ошибки размерности text-embedding-3-small, которые ломают production#
| Mistake | What goes wrong | What to do |
|---|---|---|
| Вы доверяете только vendor benchmark scores | В тестах search выглядит нормально, но реальные queries не попадают в intent | Соберите внутренний eval set из реальных user queries, затем оценивайте каждую dimension setting на этом наборе |
| Вы сокращаете storage cost и пропускаете quality checks | Меньший vector size экономит деньги, но click quality падает, а support tickets растут | Отслеживайте retrieval quality и user behavior вместе до rollout |
| Вы тестируете только relevance | Быстрые index settings все равно могут не пройти ваш p95 target | Измеряйте end-to-end latency: embed + index search + rerank |
Финальный checklist из 10 пунктов для go-live text-embedding-3-small Dimensions Explained#
- Очистите duplicates и broken text в source data.
- Покройте head, mid и tail queries в вашем benchmark.
- Сравните как минимум два размера: 1536 (text-embedding-3-small) и 3072 (text-embedding-3-large).
- Зафиксируйте top-k relevance для каждого размера на одном и том же query set.
- Зафиксируйте p95 latency от API call до финального ranked result.
- Переведите количество измерений в storage cost на миллион векторов.
- Запустите canary с реальным трафиком и success metrics.
- Подготовьте rollback steps до полного rollout.
- Назначьте одного owner для monitoring и alert response.
- Задайте cadence для retraining или re-embedding review.
Запускайте только тогда, когда relevance, p95 latency и storage cost проходят проверку вместе.
<.-- IMAGE: Одностраничная графика launch checklist для решений по размерности embedding. -->
Часто задаваемые вопросы#
В text-embedding-3-small Dimensions Explained какая лучшая размерность по умолчанию для старта?#
Практическая отправная точка — 512 для большинства команд или 1024, если ваш контент сложный (legal, technical, long-form docs). В text-embedding-3-small Dimensions Explained это дает сильный баланс качества, скорости и стоимости без слишком раннего избыточного commitment. Затем запустите небольшой benchmark на ваших реальных user queries и ожидаемых filters. Выберите минимальную размерность, которая все еще соответствует вашей цели релевантности, а не просто ту, которая лучше выглядит в игрушечном тесте.
Всегда ли снижение размерности в text-embedding-3-small Dimensions Explained ухудшает retrieval quality?#
Меньшая размерность не всегда заметно ухудшает результаты. Для короткого FAQ search или узких доменов падение может быть небольшим. Для широких catalogs, multilingual content или нюансированного semantic matching качество может снижаться быстрее. В text-embedding-3-small Dimensions Explained рассматривайте dimension как ручку настройки: сравните 256, 512 и 1024 на одном и том же query set. Оставьте минимальный размер, который сохраняет приемлемые Recall@k и ranking quality для ваших реальных пользователей.
Как размерности text-embedding-3-small влияют на стоимость vector database?#
Стоимость примерно линейно масштабируется с количеством измерений. Если сократить векторы с 1024 до 512, raw vector storage будет примерно вдвое меньше. Та же тенденция относится к использованию RAM и часто к query compute. Но учитывайте index overhead: ANN structures добавляют память для graph links, metadata и internal bookkeeping. Поэтому общая экономия существенная, но это не только vector bytes. На практике оценивайте полный index size, а не только embedding size, прежде чем задавать финальную размерность.
Нужно ли заново embedding всех документов при изменении размерности?#
Да. Вектор, построенный в одной размерности, нельзя смешивать с векторами другой размерности в одном согласованном индексе. При изменении размерности заново выполните embedding всех documents и rebuild index. Для production systems используйте более безопасную миграцию: dual-index rollout. Постройте новый индекс параллельно, отправьте в него часть трафика, сравните качество и latency, затем полностью переключитесь. Это позволяет избежать downtime и сохраняет стабильное поведение поиска во время перехода.
Какие metrics нужно отслеживать при сравнении размерностей?#
Отслеживайте три группы: relevance, speed и cost. Для relevance используйте Recall@k, nDCG и MRR на размеченном query set. Для speed следите за p50/p95/p99 latency, поскольку tail latency влияет на пользовательский опыт. Для cost измеряйте storage per million docs, RAM footprint и cost per 1,000 queries. В text-embedding-3-small Dimensions Explained такой scorecard помогает избежать односторонних решений, когда вы экономите хранилище, но слишком сильно ухудшаете ranking quality.
Подходит ли text-embedding-3-small для multilingual search при меньшей размерности?#
Может подходить, но multilingual search требует более строгого тестирования, чем single-language search. Меньшая размерность может объединять тонкие смыслы между языками, особенно для коротких запросов и mixed scripts. Начните с 512 или 1024, затем тестируйте по language pair, query length и domain terms. В text-embedding-3-small Dimensions Explained многоязычные setups часто выигрывают от большей размерности, когда важна precision. Выберите минимальную настройку, которая все еще достигает целей релевантности для каждого ключевого language segment.
Главный вывод: размерности text-embedding-3-small — это практический рычаг настройки: большая размерность может улучшать semantic fidelity, а меньшая снижает storage, latency и cost, поэтому правильный выбор зависит от ваших целей retrieval quality и системных ограничений. Относитесь к размеру размерности как к эмпирическому решению: benchmark recall, ranking quality и end-to-end performance на собственных данных вместо того, чтобы полагаться на defaults. Протестируйте несколько размерностей в своем pipeline на этой неделе, а затем зафиксируйте production setting на основе evidence, а не догадок.
Implementation Guides
Available in other languages: