简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Dimensions de text-embedding-3-small expliquées : Comment choisir la bonne taille pour la qualité et le coût
Un guide pratique des dimensions de text-embedding-3-small, comment choisir entre 256, 512, 1024 et 1536 dimensions.
Dimensions de text-embedding-3-small expliquées : Comment choisir la bonne taille pour la qualité et le coût#
Avec 1536 dimensions, un vecteur text-embedding-3-small stocké en float32 utilise 6 144 octets ; 10 millions de vecteurs nécessitent donc environ 61 Go avant la surcharge de l’index. Ce chiffre surprend souvent les équipes lorsque la recherche semble peu coûteuse à petite échelle, puis que les coûts mémoire augmentent et que le temps de requête s’allonge après l’expansion du corpus. La difficulté tient au fait que des dimensions plus élevées peuvent améliorer le classement sur un jeu de données, tout en gaspillant du stockage et en ajoutant de la latence sur un autre.
C’est le cœur de Dimensions de text-embedding-3-small expliquées : il n’existe pas de réglage universel gagnant pour toutes les charges de travail. Vous devez choisir la taille de dimension en testant ensemble votre objectif de pertinence, votre limite de latence p95 et votre budget de stockage vectoriel, pas séparément. Si vous optimisez uniquement la qualité, le coût augmente vite. Si vous réduisez uniquement la taille, la qualité de recherche peut se dégrader d’une manière visible pour les utilisateurs.
Vous allez voir une méthode de sélection pratique : construire un petit jeu d’évaluation, comparer la pertinence à deux ou trois tailles de dimensions, mesurer le temps de réponse de bout en bout, puis convertir le nombre de dimensions en coût de stockage réel par million de vecteurs. À partir de là, la bonne taille devient un choix d’ingénierie mesurable, pas une estimation.
Ce que signifie "Dimensions" dans text-embedding-3-small (et pourquoi cela change les résultats)#
En termes simples, Dimensions de text-embedding-3-small expliquées signifie une chose : la quantité de sens que vous conservez dans chaque vecteur. Le nombre de dimensions est un bouton de compression, pas un interrupteur de qualité. text-embedding-3-small a une taille maximale de 1536 dimensions (d’après la spécification du modèle dans la base de connaissances). Les tailles inférieures compressent davantage.
Dimensions de text-embedding-3-small expliquées : du sens sémantique aux vecteurs numériques#
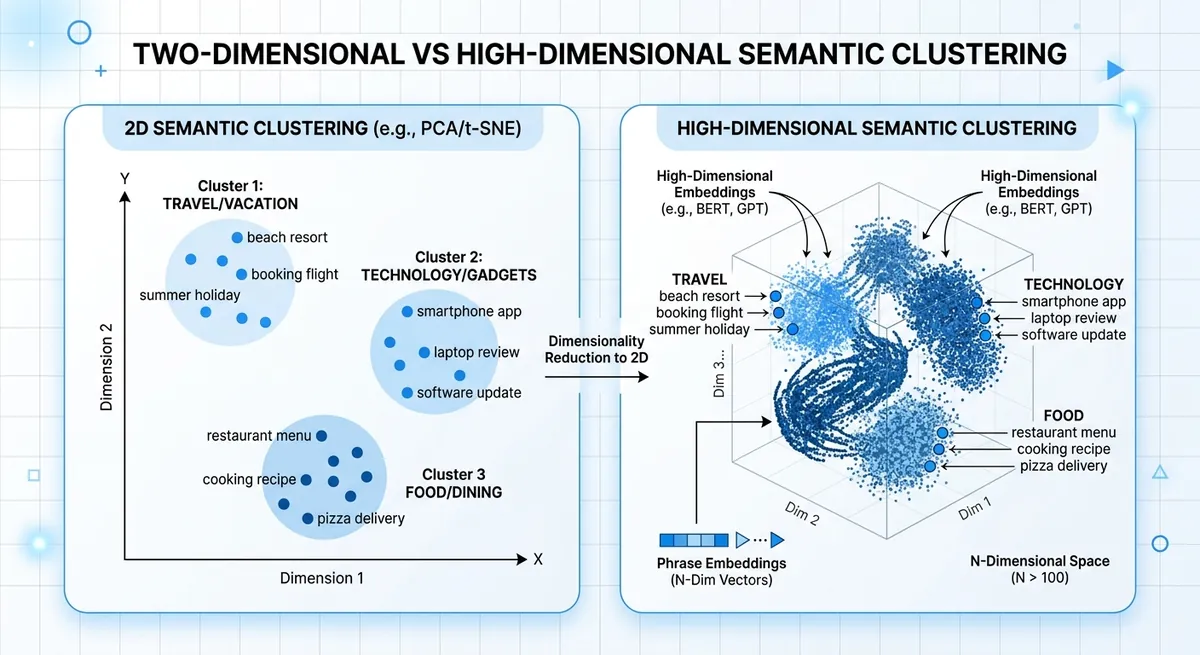
Un embedding transforme le texte en nombres afin que les expressions similaires se retrouvent proches les unes des autres dans l’espace vectoriel. "Reset my password" et "I cannot sign in" devraient se retrouver proches. Chaque dimension supplémentaire donne au modèle plus d’espace pour stocker des nuances comme l’intention, le ton ou les termes propres à un domaine. Si vous réduisez le vecteur, vous conservez le sens central, mais vous perdez des détails plus fins.
Taille des dimensions text-embedding-3-small et changements de qualité du classement#
Des dimensions plus faibles peuvent accélérer la recherche et réduire le stockage, mais le classement par plus proches voisins peut changer. Ce changement apparaît lorsque deux intentions semblent similaires en surface mais diffèrent dans l’action, comme "cancel plan" et "pause plan."
| Choix de taille de vecteur | Fidélité sémantique | Vitesse d’exécution | Stockage par 1M de vecteurs (float32) |
|---|---|---|---|
| 1536 (text-embedding-3-small complet) | Conservation maximale des détails | Plus lent que les vecteurs plus petits | ~6.1 GB |
| 768 (compressé) | Une certaine perte de détails | Plus rapide | ~3.1 GB |
| 512 (compressé) | Risque accru de perte sur des intentions proches | Encore plus rapide | ~2.0 GB |
Source : dimension maximale de text-embedding-3-small issue de la base de connaissances fournie ; calcul du stockage à partir de dimensions × 4 octets.
Voilà le cœur pratique de Dimensions de text-embedding-3-small expliquées : ajuster les dimensions avec des tests de pertinence, la latence p95 et le stockage vectoriel ensemble.
Options de dimensions text-embedding-3-small : plages pratiques et compromis#
Pour text-embedding-3-small, la taille native du vecteur est de 1536 dimensions. Dans les systèmes réels, les équipes raccourcissent souvent les vecteurs pour réduire la RAM, le disque et la charge de l’index ANN. Le stockage augmente linéairement avec le nombre de dimensions ; chaque choix de taille est donc un choix direct de coût et de latence. C’est le cœur pratique de Dimensions de text-embedding-3-small expliquées.
Dimensions de text-embedding-3-small expliquées : réglages courants et cas d’usage les plus adaptés#
Si vous avez besoin de valeurs par défaut approximatives, ce tableau constitue un bon point de départ pour les tests A/B.
| Dimension | Stockage brut par 1M de vecteurs (float32) | Meilleur usage | Risque typique |
|---|---|---|---|
| 256 | ~0.95 GB | Contraintes fortes de latence ou de budget, correspondance d’intention simple | Plus de ratés sur les requêtes nuancées |
| 384 | ~1.43 GB | Recherche sémantique orientée coût avec textes courts | Rappel plus faible sur les cas limites |
| 512 | ~1.91 GB | Recherche équilibrée pour docs de support, aide produit, FAQ | Une certaine perte de sens longue traîne |
| 768 | ~2.86 GB | Récupération plus équilibrée, styles de requêtes mixtes | Croissance modérée des coûts d’infrastructure |
| 1024 | ~3.81 GB | RAG à rappel élevé sur documents denses | Mémoire d’index et temps de requête plus élevés |
| 1536 | ~5.72 GB | Récupération pleine fidélité, similarité nuancée | Pression maximale sur le stockage et la latence |
Source : plages de dimensions issues du plan fourni et des informations du modèle (text-embedding-3-small = 1536). Le stockage est calculé comme dimensions × 4 octets × 1 000 000 vecteurs.
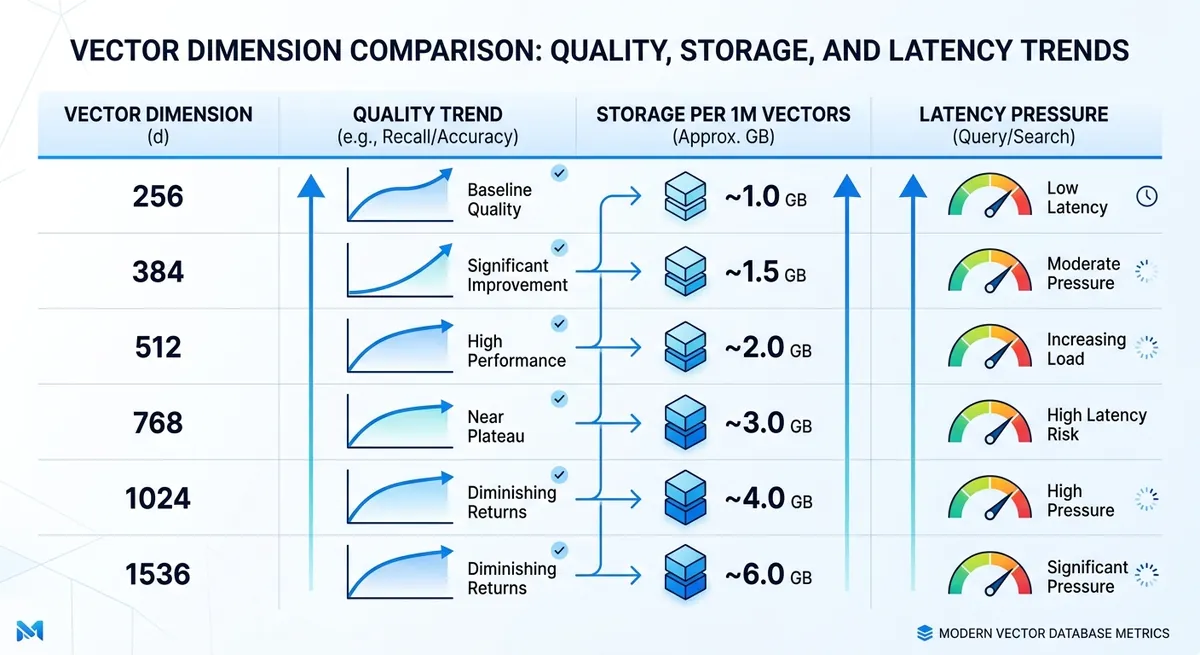
Compromis de qualité de text-embedding-3-small : où commence la dégradation#
La perte de qualité apparaît généralement plus tôt sur les tâches très sensibles à la précision. La récupération de FAQ peut rester utilisable à 384 ou 512, tandis que la recherche juridique ou médicale nécessite souvent 1024 ou 1536 pour préserver les différences fines de sens.
Le mélange linguistique modifie aussi le plancher sûr. Les charges monolingues en anglais peuvent tenir à des tailles plus faibles. Le trafic multilingue, le code-switching et les écritures mixtes ont tendance à se dégrader plus tôt lorsque les vecteurs raccourcissent.
Vous pouvez exécuter ce test rapidement via Crazyrouter avec une seule clé API et comparer la qualité de récupération à 512, 768 et 1536 sur le même jeu d’évaluation. Cela donne un point de coupure mesurable au lieu d’une estimation.
Qualité, latence et coût : le benchmark à trois axes dont vous avez réellement besoin#
Vous avez déjà vu pourquoi une seule métrique peut être trompeuse. Pour Dimensions de text-embedding-3-small expliquées, l’approche pratique consiste à tester en même temps un objectif de pertinence, un budget de latence et un budget de stockage. Choisissez la plus petite dimension qui respecte encore votre seuil de qualité sous votre limite de latence p95.
Jeu de test des dimensions text-embedding-3-small : construire une pertinence hors ligne fiable#
Utilisez de vrais logs de recherche, tickets de support et prompts de chat. Construisez 200 à 500 exemples de requêtes si possible. Cette taille suffit à exposer les points faibles sans ralentir votre équipe.
Définissez ce que "bon" signifie pour chaque requête. Gardez des labels simples : pertinent, partiellement pertinent, non pertinent. Ajoutez volontairement des cas difficiles : requêtes courtes, requêtes avec fautes de frappe, termes de domaine et requêtes multilingues. Si votre application sert plusieurs langues, incluez des requêtes mixtes dans le même jeu.
Ne laissez pas une seule personne étiqueter les résultats. Deux évaluateurs réduisent rapidement les biais.
Métriques de benchmark des dimensions text-embedding-3-small : qualité et latence ensemble#
Suivez la qualité du classement et la vitesse dans une même exécution. Recall@k indique si le bon élément apparaît dans le top-k. MRR et nDCG indiquent s’il apparaît près du sommet, là où les utilisateurs cliquent.
Pour la latence, séparez le chemin : temps d’embedding et temps de récupération. Surveillez p95 et p99, pas seulement la latence moyenne. Les requêtes lentes en queue de distribution façonnent l’expérience utilisateur.
| Candidat de dimension | Taille connue par vecteur (float32) | Mémoire d’index relative | Métriques de qualité à suivre | Métriques de latence à suivre |
|---|---|---|---|---|
| 1536 (text-embedding-3-small) | 6,144 bytes | 1x baseline | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| 3072 (text-embedding-3-large) | 12,288 bytes | ~2x vs 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| Candidat à dimension réduite dans votre stack | dims × 4 bytes | dims / 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
Source : dimensions des modèles issues de la liste de modèles Crazyrouter (text-embedding-3-small : 1536, text-embedding-3-large : 3072). Le calcul en octets utilise des vecteurs float32.
Modèle de coût des dimensions text-embedding-3-small : du stockage à l’impact métier#
Convertissez les dimensions en argent avant le déploiement.
Stockage par million de vecteurs = dimension × 4 bytes × 1,000,000, puis multipliez par le nombre de réplicas. Ajoutez la surcharge d’index de votre base de données vectorielle.
<.-- IMAGE : infographie de type formule pour estimer le stockage vectoriel et le coût annuel selon la dimension et la taille du corpus. -->
Reliez maintenant le gain de qualité aux signaux métier que vous suivez déjà, comme le CTR, la déviation de tickets ou la conversion. Si une dimension plus grande augmente légèrement le nDCG mais double la mémoire et manque le p95, gardez le réglage plus petit. Si elle améliore assez la pertinence classée pour faire bouger la conversion, vous avez un argument métier clair.
Comment choisir la bonne dimension selon le cas d’usage#
Si vous devinez encore la taille de dimension, cette partie de Dimensions de text-embedding-3-small expliquées est le raccourci : associez la dimension à la charge de travail, puis vérifiez avec un petit jeu d’évaluation avant le déploiement.
Dimensions de text-embedding-3-small expliquées pour le RAG et la recherche d’entreprise#
Le RAG et la recherche interne échouent vite lorsque le rappel baisse. Les utilisateurs posent une question, puis quittent si les premiers résultats manquent des faits clés. Votre point de départ doit donc être la qualité, pas le stockage.
Utilisez 1536 comme référence pour text-embedding-3-small, puis testez une seule taille inférieure uniquement après avoir confirmé le rappel sur les requêtes difficiles. Les requêtes difficiles sont les questions longues, les termes rares et les intentions mixtes.
Le chunking change le résultat plus que beaucoup ne l’imaginent. Des petits chunks combinés à de faibles dimensions peuvent perdre le contexte deux fois : une fois lors du découpage, une fois lors de l’embedding. Si vos chunks sont courts, conservez des dimensions plus élevées. Si vos chunks sont longs et propres, vous pouvez tester une taille plus faible sans risque aveugle.
Dimensions de text-embedding-3-small pour recommandations, clustering et routage sémantique#
Ces systèmes privilégient généralement la vitesse et la stabilité des regroupements, pas un rappel top-1 parfait. Un réglage moyen offre souvent le meilleur compromis.
Pour le routage, une similarité approximative suffit souvent, car un modèle de second niveau peut reclasser ou vérifier. Cela signifie que vous pouvez tester des dimensions plus faibles plus tôt que vous ne le feriez en RAG. Pour le clustering, évaluez la pureté des clusters et la dérive sur les données hebdomadaires, pas seulement sur une seule exécution hors ligne.
Choisissez la plus petite dimension qui garde encore votre métrique aval stable pendant deux cycles complets de trafic.
Dimensions de text-embedding-3-small expliquées pour les charges multilingues et propres à un domaine#
Le langage de domaine change la donne. Les termes juridiques, médicaux ou matériels peuvent sembler proches en langage courant, mais être éloignés en signification. Des dimensions plus faibles peuvent brouiller ces frontières.
Le trafic multilingue nécessite des vérifications par langue. Ne moyennez pas tout dans un seul score. Exécutez le même ensemble d’intentions sur chaque grand segment linguistique, puis comparez les motifs d’échec. Une taille qui fonctionne en anglais peut échouer sur des requêtes mixtes ou des termes translittérés.
| Cas d’usage | Dimension de départ recommandée | À mesurer avant de réduire | Signe d’échec courant |
|---|---|---|---|
| RAG / recherche d’entreprise | 1536 | Rappel sur requêtes difficiles, ancrage des réponses | Document correct absent des premiers résultats |
| Recommandations | Moyenne (tester sous 1536) | Stabilité du CTR ou de la conversion | Des éléments similaires mais non pertinents remontent |
| Routage sémantique | Moyenne à faible | Précision du routage + taux de fallback | Mauvaise route, fallback plus élevé |
| Multilingue / forte densité de domaine | 1536 | Rappel par langue, erreurs au niveau des termes | Termes rares mappés vers un sens générique |
Source : informations de dimensions des modèles issues de la liste de modèles Crazyrouter (text-embedding-3-small : 1536, text-embedding-3-large : 3072). <.-- IMAGE : matrice de décision par cas d’usage (RAG, recsys, routage, multilingue) avec dimensions de départ recommandées. -->
Guide d’implémentation : API, schéma vectoriel et étapes de migration#
Dimensions de text-embedding-3-small expliquées dans les requêtes API#
La référence sûre pour text-embedding-3-small est 1536 dimensions. Vous pouvez demander une taille plus petite avec le champ dimensions, mais gardez cette taille fixe par index. Si les vecteurs de documents utilisent 1024 et les vecteurs de requêtes utilisent 1536, la qualité de récupération dérivera même si les deux appels réussissent.
Utilisez une seule valeur de configuration pour les chemins d’écriture et de lecture, puis validez chaque requête : le texte d’entrée n’est pas vide, la longueur du vecteur est égale à la dimension configurée, et chaque valeur est un nombre réel (pas de NaN, pas de Inf). Si la validation échoue, routez l’élément vers une file de nouvelle tentative et ré-embeddez-le avec votre taille par défaut.
Vous pouvez utiliser le SDK OpenAI avec un endpoint compatible comme https://ai.crazyrouter.us/v1, puis figer le modèle et les dimensions dans un fichier de configuration partagé utilisé par tous les services.
Contrôle des dimensions text-embedding-3-small dans le schéma vectoriel et la conception d’index#
Gardez une seule dimension par index, et gardez les vecteurs de requête et de documents à cette même taille.
Utilisez des noms de collections verrouillés par dimension, comme kb_d1536_v1 et kb_d1024_v1. Cette convention rend les migrations lisibles et empêche les mélanges silencieux.
<.-- IMAGE : diagramme d’architecture montrant l’ingestion, le service d’embedding, deux index vectoriels et le routeur de requêtes. -->
Lorsque la dimensionnalité change, reconstruisez les paramètres d’index avec les nouveaux vecteurs. Pour HNSW, réajustez les paramètres de graphe et de recherche après la reconstruction. Pour IVF, réentraînez les centroïdes sur des vecteurs issus de la nouvelle taille de dimension. Réutiliser les anciennes données d’entraînement de l’index peut nuire au rappel.
Dimensions de text-embedding-3-small expliquées pour la migration depuis d’anciens modèles#
Exécutez la migration par phases :
| Phase | Chemin d’écriture | Chemin de lecture | À vérifier |
|---|---|---|---|
| Double écriture | Ancien + nouveaux embeddings | Ancien index | Taux de réussite d’écriture et erreurs de validation des vecteurs |
| Lecture fantôme | Ancien + nouveaux embeddings | L’utilisateur voit l’ancien, le nouveau est journalisé | Chevauchement top-k, latence, cas de mauvaises requêtes |
| Bascule | Ancien + nouveaux embeddings | Nouvel index | Taux de réussite de pertinence et objectif de latence p95 |
| Retour arrière | Garder la double écriture active | Revenir à l’ancien | Déclencher sur pic d’erreurs ou baisse de pertinence |
Source : base de connaissances Crazyrouter (text-embedding-3-small à 1536 dimensions ; API compatible OpenAI ; plus de 300 modèles pris en charge).
C’est le cœur pratique de Dimensions de text-embedding-3-small expliquées : verrouiller les dimensions, tester avec du trafic fantôme, et basculer uniquement après parité mesurée.
Opérations en production : surveiller la dérive, les régressions de qualité et le workflow d’équipe#
Vous avez choisi une taille de dimension avec des tests hors ligne. Bon départ. Le vrai risque apparaît plus tard, lorsque de nouveaux contenus, un nouveau mélange de requêtes et des changements de classement atteignent la production. Dans Dimensions de text-embedding-3-small expliquées, la qualité à long terme vient d’une boucle serrée : données d’évaluation fixes, vérifications du comportement réel et étapes de déploiement contrôlées.
Mettre en place une surveillance de dérive des dimensions text-embedding-3-small#
Verrouillez votre jeu d’évaluation et vos métriques avant chaque changement de dimension. Conservez un ensemble de requêtes de référence qui reflète les intentions réelles des utilisateurs, puis évaluez-le chaque semaine avec la même grille. Associez-le à des signaux live afin de détecter la dérive tôt, pas après l’accumulation de tickets de support.
| Signal | À quoi ressemble la dérive | Cadence de revue | Déclencheur d’action |
|---|---|---|---|
| Score de pertinence du jeu de référence | Les premiers résultats ne correspondent plus aux réponses connues comme bonnes | Tableau de bord hebdomadaire | Baisse par rapport à la dernière exécution stable |
| CTR sur les blocs de récupération | Les utilisateurs cliquent moins sur les docs suggérées | Quotidienne | Déclin durable |
| Taux de réussite des tâches | Plus de sessions échouent à terminer la tâche cible | Quotidienne | Tendance baissière par segment |
| Taux sans résultat | Les réponses de récupération vides augmentent | Quotidienne | Pic après déploiement |
Source du tableau : modèle de runbook opérationnel utilisé dans cette section (jeu de référence + métriques en ligne issus du plan fourni).
<.-- IMAGE : maquette de tableau de bord montrant le score hebdomadaire du jeu de référence, la tendance CTR, le taux sans résultat et les seuils d’alerte -->
Exécuter les expériences de dimensions text-embedding-3-small en toute sécurité en staging et en production#
Commencez en staging avec des requêtes rejouées des 7 à 14 derniers jours. Passez en production avec une tranche canary, puis élargissez par segment utilisateur et région. Gardez le retour arrière prêt. Si la qualité baisse, interrompez l’augmentation du trafic, revenez à la dernière dimension stable, et journalisez les types de requêtes qui ont échoué. Cela limite les incidents et fournit des données propres pour le test suivant.
Workflow d’équipe pour les expériences Dimensions de text-embedding-3-small expliquées#
L’évaluation interéquipes se casse souvent parce que les personnes testent dans des sessions navigateur mélangées. Le SEO, le produit et le ML peuvent écraser l’état les uns des autres, puis personne ne fait confiance au résultat. Vous pouvez utiliser des profils isolés DICloak afin que chaque rôle teste le même build sans conflits de session ni croisement de comptes.
Des outils comme DICloak vous permettent de définir des règles fixes de proxy et de session par profil. Cela signifie que vos tests "US-English account" et "EU account" s’exécutent chaque fois dans des conditions réseau stables. Une configuration reproductible facilite la comparaison des vérifications de classement basées sur les dimensions entre coéquipiers, et vous donne un chemin répétable et sécurisé pour le travail continu sur Dimensions de text-embedding-3-small expliquées.
Erreurs courantes et checklist finale de sélection des dimensions#
Si vous avez lu jusqu’ici, Dimensions de text-embedding-3-small expliquées devrait se terminer par une décision de lancement, pas par une estimation.
Erreurs de dimensions text-embedding-3-small qui cassent la production#
| Erreur | Ce qui se passe mal | Que faire |
|---|---|---|
| Vous faites uniquement confiance aux scores de benchmark fournisseur | La recherche semble correcte dans les tests, mais vos vraies requêtes manquent l’intention | Construire un jeu d’évaluation interne à partir de vraies requêtes utilisateur, puis noter chaque réglage de dimension sur ce jeu |
| Vous réduisez le coût de stockage et ignorez les contrôles qualité | Une taille de vecteur plus faible économise de l’argent, mais la qualité des clics baisse et les tickets de support augmentent | Suivre ensemble la qualité de récupération et le comportement utilisateur avant le déploiement |
| Vous testez uniquement la pertinence | Des réglages d’index rapides peuvent tout de même manquer votre objectif p95 | Mesurer la latence de bout en bout : embedding + recherche d’index + rerank |
Checklist finale en 10 points pour la mise en production de Dimensions de text-embedding-3-small expliquées#
- Nettoyer les doublons et les textes cassés dans les données sources.
- Couvrir les requêtes de tête, de milieu et de longue traîne dans votre benchmark.
- Comparer au moins deux tailles : 1536 (text-embedding-3-small) et 3072 (text-embedding-3-large).
- Enregistrer la pertinence top-k pour chaque taille sur le même jeu de requêtes.
- Enregistrer la latence p95 de l’appel API au résultat classé final.
- Convertir le nombre de dimensions en coût de stockage par million de vecteurs.
- Exécuter un canary avec du trafic réel et des métriques de réussite.
- Préparer les étapes de retour arrière avant le déploiement complet.
- Désigner un propriétaire pour la surveillance et la réponse aux alertes.
- Définir une cadence de revue pour le réentraînement ou le ré-embedding.
Expédiez uniquement lorsque la pertinence, la latence p95 et le coût de stockage passent ensemble.
<.-- IMAGE : graphique de checklist de lancement en une page pour les décisions de dimensions d’embedding. -->
Questions fréquentes#
Dans Dimensions de text-embedding-3-small expliquées, quelle est la meilleure dimension par défaut pour commencer ?#
Un point de départ pratique est 512 pour la plupart des équipes, ou 1024 si votre contenu est complexe (juridique, technique, documents longs). Dans Dimensions de text-embedding-3-small expliquées, cela offre un bon équilibre entre qualité, vitesse et coût sans surengagement précoce. Exécutez ensuite un petit benchmark avec vos vraies requêtes utilisateur et les filtres attendus. Choisissez la plus petite dimension qui respecte encore votre objectif de pertinence, pas seulement celle qui semble la meilleure dans un test jouet.
Réduire les dimensions dans Dimensions de text-embedding-3-small expliquées réduit-il toujours la qualité de récupération ?#
Des dimensions plus faibles ne nuisent pas toujours aux résultats de manière significative. Pour une recherche FAQ courte ou des domaines étroits, la baisse peut être faible. Pour de vastes catalogues, du contenu multilingue ou une correspondance sémantique nuancée, la qualité peut chuter plus vite. Dans Dimensions de text-embedding-3-small expliquées, traitez la dimension comme un bouton de réglage : comparez 256, 512 et 1024 sur le même jeu de requêtes. Gardez la plus petite taille qui préserve un Recall@k acceptable et une qualité de classement suffisante pour vos vrais utilisateurs.
Comment les dimensions text-embedding-3-small affectent-elles le coût d’une base de données vectorielle ?#
Le coût évolue approximativement de façon linéaire avec le nombre de dimensions. Si vous réduisez les vecteurs de 1024 à 512, le stockage vectoriel brut est environ divisé par deux. La même tendance s’applique à l’utilisation de la RAM et souvent au calcul de requêtes. Mais incluez la surcharge d’index : les structures ANN ajoutent de la mémoire pour les liens de graphe, les métadonnées et la tenue interne des données. Les économies totales sont donc importantes, mais ne se limitent pas aux octets du vecteur. En pratique, estimez la taille complète de l’index, pas seulement la taille des embeddings, avant de fixer une dimension finale.
Dois-je ré-embedder tous les documents lorsque je change de dimensions ?#
Oui. Un vecteur construit à une dimension ne peut pas être mélangé avec des vecteurs d’une autre dimension dans un index cohérent. Lorsque vous changez de dimensions, ré-embeddez tous les documents et reconstruisez l’index. Pour les systèmes de production, utilisez une migration plus sûre : exécutez un déploiement à double index. Construisez le nouvel index en parallèle, envoyez-lui une tranche de trafic, comparez qualité et latence, puis basculez complètement. Cela évite l’indisponibilité et garde le comportement de recherche stable pendant la transition.
Quelles métriques dois-je suivre lorsque je compare les dimensions ?#
Suivez trois groupes : pertinence, vitesse et coût. Pour la pertinence, utilisez Recall@k, nDCG et MRR sur un jeu de requêtes étiqueté. Pour la vitesse, surveillez les latences p50/p95/p99, car la latence de queue affecte l’expérience utilisateur. Pour le coût, mesurez le stockage par million de documents, l’empreinte RAM et le coût par 1 000 requêtes. Dans Dimensions de text-embedding-3-small expliquées, cette grille d’évaluation vous aide à éviter les choix unilatéraux où vous économisez du stockage tout en dégradant trop la qualité du classement.
text-embedding-3-small convient-il à la recherche multilingue avec des dimensions plus faibles ?#
Cela peut fonctionner, mais la recherche multilingue exige des tests plus stricts que la recherche monolingue. Des dimensions plus faibles peuvent fusionner des nuances de sens entre langues, surtout pour les requêtes courtes et les écritures mixtes. Commencez à 512 ou 1024, puis testez par paire de langues, longueur de requête et termes de domaine. Dans Dimensions de text-embedding-3-small expliquées, les configurations multilingues bénéficient souvent de dimensions plus grandes lorsque la précision compte. Choisissez le plus petit réglage qui respecte encore les objectifs de pertinence pour chaque segment linguistique clé.
L’idée essentielle est que les dimensions de text-embedding-3-small sont un levier de réglage pratique : des dimensions plus élevées peuvent améliorer la fidélité sémantique, tandis que des dimensions plus faibles réduisent le stockage, la latence et le coût ; le bon choix dépend donc de vos objectifs de qualité de récupération et des contraintes de votre système. Traitez la taille de dimension comme une décision empirique en benchmarkant le rappel, la qualité du classement et la performance de bout en bout sur vos propres données au lieu de vous reposer sur les valeurs par défaut. Testez plusieurs dimensions dans votre propre pipeline cette semaine, puis verrouillez votre réglage de production avec des preuves, pas des suppositions.
Implementation Guides
Available in other languages: