简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
อธิบาย Dimensions ของ text-embedding-3-small: วิธีเลือกขนาดที่เหมาะสมเพื่อคุณภาพและต้นทุน
คู่มือปฏิบัติสำหรับ dimensions ของ text-embedding-3-small
อธิบาย Dimensions ของ text-embedding-3-small: วิธีเลือกขนาดที่เหมาะสมเพื่อคุณภาพและต้นทุน#
ที่ 1536 dimensions เวกเตอร์ text-embedding-3-small หนึ่งตัวที่จัดเก็บเป็น float32 ใช้พื้นที่ 6,144 bytes ดังนั้นเวกเตอร์ 10 ล้านตัวต้องใช้พื้นที่ประมาณ 61 GB ก่อนรวม overhead ของดัชนี ตัวเลขนี้มักทำให้ทีมประหลาดใจ เพราะ retrieval ดูเหมือนมีต้นทุนต่ำเมื่อสเกลยังเล็ก แต่เมื่อ corpus ขยายขึ้น ค่า memory ก็เพิ่มขึ้นและ query time ก็ยาวขึ้นตามไปด้วย ส่วนที่ยากคือ dimensions ที่สูงขึ้นอาจช่วยปรับปรุง ranking ใน dataset หนึ่ง แต่การตั้งค่าเดียวกันอาจสิ้นเปลือง storage และเพิ่ม latency ในอีก dataset หนึ่ง
นี่คือแก่นของ text-embedding-3-small Dimensions Explained: ไม่มีการตั้งค่าเดียวที่ชนะในทุก workload คุณต้องเลือก dimension size โดยทดสอบ relevance target, ขีดจำกัด p95 latency และงบประมาณ vector storage ของระบบคุณร่วมกัน ไม่ใช่ทีละอย่าง หากคุณปรับเฉพาะคุณภาพ ต้นทุนจะเพิ่มขึ้นเร็วมาก หากคุณลดขนาดอย่างเดียว search quality อาจลดลงในแบบที่ผู้ใช้สังเกตได้
คุณจะได้เห็นวิธีเลือกที่ใช้งานได้จริง: สร้าง eval set ขนาดเล็ก เปรียบเทียบ relevance ที่ dimension size สองหรือสามค่า วัด response time แบบ end-to-end แล้วแปลงจำนวน dimensions เป็นต้นทุน storage จริงต่อเวกเตอร์หนึ่งล้านตัว จากนั้นขนาดที่เหมาะสมจะกลายเป็นการตัดสินใจเชิงวิศวกรรมที่วัดได้ ไม่ใช่การเดา
"Dimensions" หมายถึงอะไรใน text-embedding-3-small และทำไมจึงเปลี่ยนผลลัพธ์#
พูดแบบตรงไปตรงมา text-embedding-3-small Dimensions Explained หมายถึงสิ่งเดียว: คุณเก็บความหมายไว้ในแต่ละเวกเตอร์มากแค่ไหน จำนวน dimensions คือปุ่มปรับการบีบอัด ไม่ใช่สวิตช์เปิดปิดคุณภาพ
text-embedding-3-small มีขนาดสูงสุด 1536 dimensions ตาม model spec ใน knowledge base ขนาดที่ต่ำกว่านั้นคือการบีบอัดที่หนักขึ้น
อธิบาย dimensions ของ text-embedding-3-small: จากความหมายเชิงภาษาเป็นเวกเตอร์ตัวเลข#
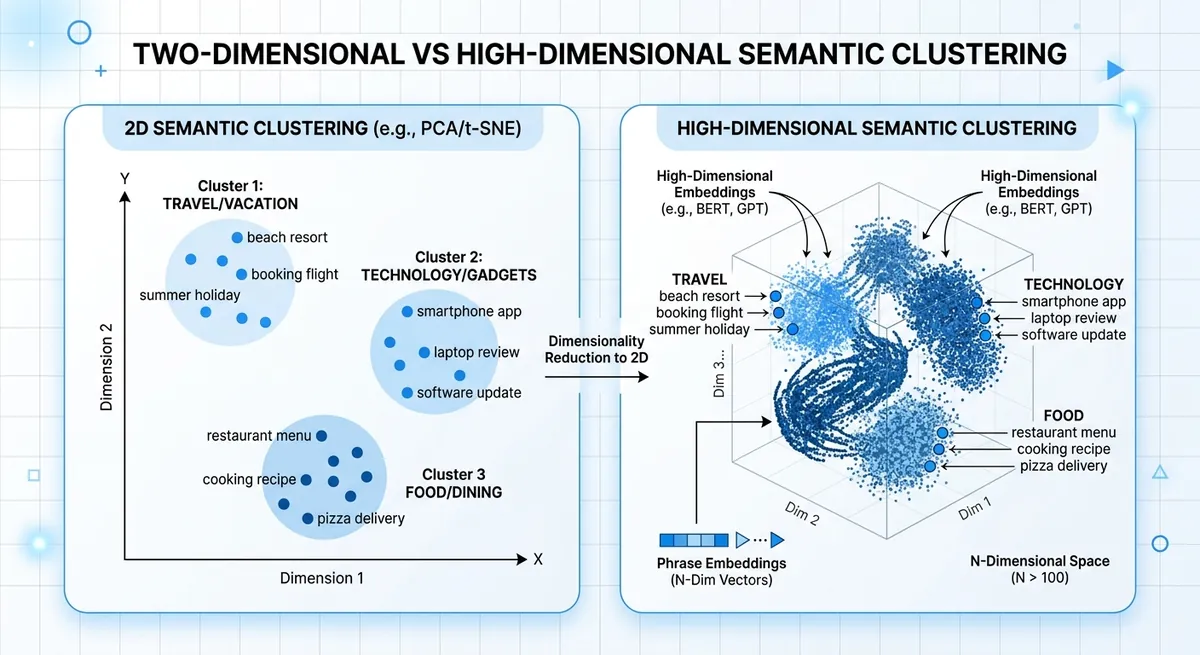
Embedding แปลงข้อความเป็นตัวเลขเพื่อให้วลีที่คล้ายกันอยู่ใกล้กันใน vector space
"Reset my password" และ "I cannot sign in" ควรอยู่ใกล้กัน
dimension ที่เพิ่มขึ้นแต่ละตัวให้พื้นที่กับโมเดลมากขึ้นในการเก็บรายละเอียด เช่น intent, tone หรือคำเฉพาะโดเมน
เมื่อคุณย่อเวกเตอร์ คุณยังคงเก็บความหมายหลักไว้ แต่รายละเอียดปลีกย่อยจะหายไปบางส่วน
ขนาด dimension ของ text-embedding-3-small และการเปลี่ยนแปลงของคุณภาพ ranking#
dimensions ที่ต่ำลงสามารถทำให้ search เร็วขึ้นและลด storage ได้ แต่ nearest-neighbor ranking อาจเปลี่ยนไป
การเปลี่ยนแปลงนี้จะเห็นชัดเมื่อสอง intent ดูคล้ายกันบนผิวเผิน แต่ต้องการ action ต่างกัน เช่น "cancel plan" เทียบกับ "pause plan"
| ตัวเลือกขนาดเวกเตอร์ | ความครบถ้วนของความหมาย | ความเร็วขณะรัน | Storage ต่อ 1M vectors (float32) |
|---|---|---|---|
| 1536 (full text-embedding-3-small) | เก็บรายละเอียดได้สูงสุด | ช้ากว่าเวกเตอร์ขนาดเล็ก | ~6.1 GB |
| 768 (compressed) | สูญเสียรายละเอียดบางส่วน | เร็วขึ้น | ~3.1 GB |
| 512 (compressed) | เสี่ยงสูญเสียมากขึ้นเมื่อ intent ใกล้กัน | เร็วยิ่งขึ้น | ~2.0 GB |
แหล่งที่มา: dimension สูงสุดของ text-embedding-3-small จาก knowledge base ที่ให้มา; การคำนวณ storage จาก dimensions × 4 bytes
นี่คือแก่นเชิงปฏิบัติของ text-embedding-3-small Dimensions Explained: ปรับ dimensions โดยดู relevance tests, p95 latency และ vector storage ร่วมกัน
ตัวเลือก Dimension ของ text-embedding-3-small: ช่วงที่ใช้จริงและ Tradeoffs#
สำหรับ text-embedding-3-small ขนาดเวกเตอร์ดั้งเดิมคือ 1536 dimensions ในระบบจริง ทีมมักย่อเวกเตอร์เพื่อลด RAM, disk และโหลดของ ANN index Storage เพิ่มขึ้นเชิงเส้นตามจำนวน dimensions ดังนั้นทุกการเลือกขนาดจึงเป็นการเลือกต้นทุนและ latency โดยตรง นี่คือแก่นเชิงปฏิบัติของ text-embedding-3-small Dimensions Explained
อธิบาย Dimensions ของ text-embedding-3-small: การตั้งค่าที่พบบ่อยและ use case ที่เหมาะที่สุด#
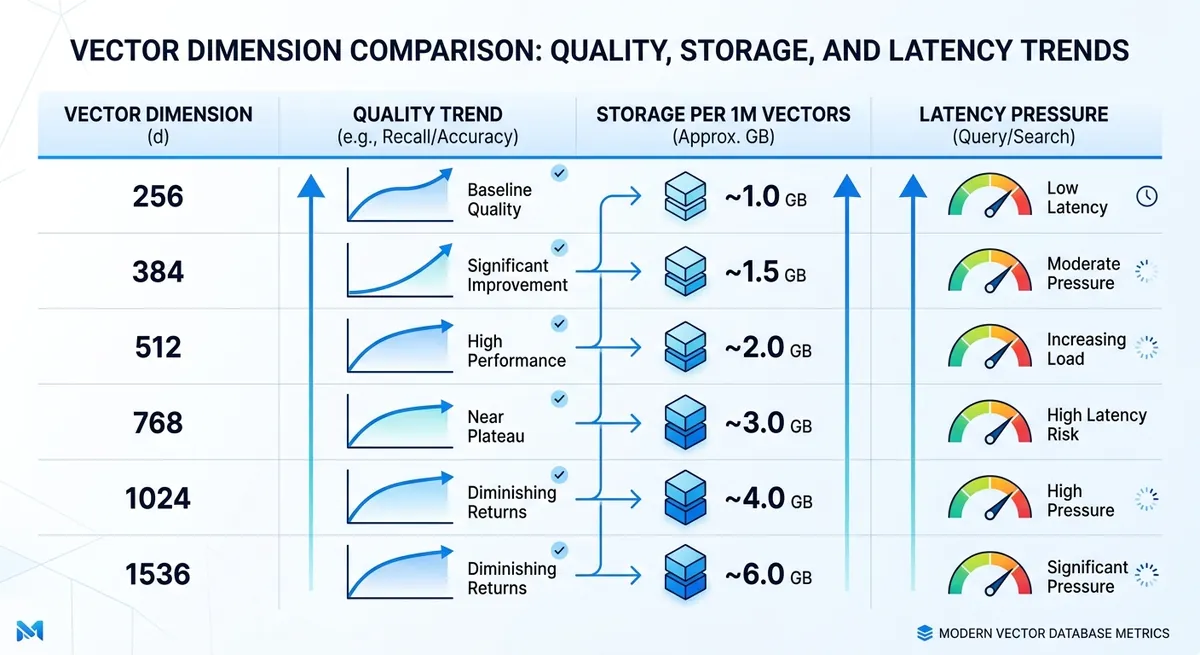
หากคุณต้องการค่าเริ่มต้นแบบคร่าว ๆ ตารางนี้เป็นแผนที่ตั้งต้นที่ดีสำหรับ A/B tests
| Dimension | Raw storage per 1M vectors (float32) | เหมาะที่สุดสำหรับ | ความเสี่ยงทั่วไป |
|---|---|---|---|
| 256 | ~0.95 GB | ข้อจำกัด latency หรืองบประมาณที่เข้มงวด, intent matching แบบง่าย | พลาดมากขึ้นใน query ที่มี nuance |
| 384 | ~1.43 GB | semantic search ที่เน้นต้นทุนกับข้อความสั้น | recall ต่ำลงใน edge cases |
| 512 | ~1.91 GB | search แบบสมดุลสำหรับ support docs, product help, FAQ | สูญเสียความหมาย long-tail บางส่วน |
| 768 | ~2.86 GB | retrieval แบบ balanced-plus, query style ผสม | infra cost เพิ่มระดับปานกลาง |
| 1024 | ~3.81 GB | RAG ที่ต้องการ high-recall บนเอกสารหนาแน่น | index memory และ query time สูงขึ้น |
| 1536 | ~5.72 GB | full-fidelity retrieval, similarity ที่ละเอียด | แรงกดดันด้าน storage และ latency สูงสุด |
แหล่งที่มา: ช่วง dimension จาก outline และ model info ที่ให้มา (text-embedding-3-small = 1536) Storage คำนวณจาก dimensions × 4 bytes × 1,000,000 vectors
Tradeoffs ด้านคุณภาพของ text-embedding-3-small: จุดที่คุณภาพเริ่มลดลง#
การสูญเสียคุณภาพมักปรากฏเร็วกว่าในงานที่เน้น precision สูง FAQ retrieval อาจยังใช้งานได้ที่ 384 หรือ 512 ขณะที่ legal search หรือ medical search มักต้องใช้ 1024 หรือ 1536 เพื่อรักษาความแตกต่างทางความหมายที่ละเอียด
การผสมภาษาก็เปลี่ยนค่าต่ำสุดที่ปลอดภัยเช่นกัน workload ภาษาอังกฤษภาษาเดียวอาจยังรับมือได้ที่ขนาดต่ำกว่า แต่ traffic หลายภาษา, code-switching และ script ผสมมักเสื่อมคุณภาพเร็วขึ้นเมื่อเวกเตอร์สั้นลง
คุณสามารถรันทดสอบนี้ได้อย่างรวดเร็วผ่าน Crazyrouter ด้วย API key เดียว แล้วเปรียบเทียบ retrieval quality ที่ 512, 768 และ 1536 บน eval set เดียวกัน วิธีนี้ให้ cutoff point ที่วัดได้แทนการเดา
คุณภาพ, Latency และต้นทุน: Benchmark สามทางที่คุณต้องใช้จริง#
คุณเห็นแล้วว่าการดู metric เดียวอาจทำให้เข้าใจผิด
สำหรับ text-embedding-3-small Dimensions Explained วิธีที่ใช้งานได้จริงคือทดสอบ relevance target หนึ่งค่า, latency budget หนึ่งค่า และ storage budget หนึ่งค่าไปพร้อมกัน เลือก dimension ที่เล็กที่สุดซึ่งยังผ่านเกณฑ์คุณภาพภายใต้ขีดจำกัด p95 latency ของคุณ
ชุดทดสอบ dimension ของ text-embedding-3-small: สร้าง offline relevance ที่เชื่อถือได้#
ใช้ search logs, support tickets และ chat prompts จริง หากทำได้ให้สร้างตัวอย่าง query 200–500 รายการ ขนาดนี้เพียงพอที่จะเผยจุดอ่อนโดยไม่ทำให้ทีมช้าลง
กำหนด label ว่า "ดี" หมายถึงอะไรสำหรับแต่ละ query ให้ label เรียบง่าย: relevant, partially relevant, not relevant
เพิ่มเคสยากโดยตั้งใจ เช่น query สั้น, query ที่สะกดผิด, คำเฉพาะโดเมน และ query หลายภาษา หากแอปของคุณรองรับหลายภาษา ให้รวม query ภาษาผสมไว้ในชุดเดียวกัน
อย่าให้คนเพียงคนเดียว label ผลลัพธ์ ผู้ตรวจสองคนช่วยลด bias ได้เร็ว
Metrics benchmark ของ text-embedding-3-small dimensions: คุณภาพและ latency ร่วมกัน#
ติดตาม ranking quality และความเร็วในการรันเดียวกัน
Recall@k บอกคุณว่า item ที่ถูกต้องปรากฏใน top-k หรือไม่ MRR และ nDCG บอกว่ามันอยู่ใกล้อันดับต้น ๆ แค่ไหน ซึ่งเป็นจุดที่ผู้ใช้คลิก
สำหรับ latency ให้แยก path เป็น embedding time และ retrieval time ดู p95 และ p99 ไม่ใช่แค่ average latency request ที่ช้าใน tail เป็นตัวกำหนดประสบการณ์ผู้ใช้
| Dimension candidate | Known size per vector (float32) | Relative index memory | Quality metrics to track | Latency metrics to track |
|---|---|---|---|---|
| 1536 (text-embedding-3-small) | 6,144 bytes | 1x baseline | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| 3072 (text-embedding-3-large) | 12,288 bytes | ~2x vs 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| Lower-dimension candidate in your stack | dims × 4 bytes | dims / 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
แหล่งที่มา: ขนาดโมเดลจาก Crazyrouter model list (text-embedding-3-small: 1536, text-embedding-3-large: 3072) ใช้เวกเตอร์ float32 สำหรับการคำนวณ bytes
รูปแบบต้นทุน dimension ของ text-embedding-3-small: จาก storage ไปสู่ผลกระทบทางธุรกิจ#
แปลง dimensions เป็นต้นทุนก่อนนำไปใช้งานจริง
พื้นที่จัดเก็บต่อเวกเตอร์หนึ่งล้านตัว = dimension × 4 bytes × 1,000,000 จากนั้นคูณด้วยจำนวน replica และเพิ่มค่าใช้จ่าย index overhead จาก vector database ของคุณ
<.-- IMAGE: สูตรสไตล์อินโฟกราฟิกสำหรับการประมาณการจัดเก็บเวกเตอร์และต้นทุนรายปีตามมิติและขนาดคลังข้อมูล -->
จากนั้นเชื่อมโยงคุณภาพที่เพิ่มขึ้นกับสัญญาณธุรกิจที่คุณติดตามอยู่แล้ว เช่น CTR, ticket deflection หรือ conversion rate หาก dimension ที่ใหญ่ขึ้นทำให้ nDCG สูงขึ้นเล็กน้อย แต่เพิ่ม memory เป็นสองเท่าและไม่ผ่าน p95 ให้ใช้การตั้งค่าที่เล็กกว่า หาก ranking relevance ดีขึ้นมากพอที่จะเปลี่ยน conversion rate คุณจะมี business case ที่ชัดเจน
วิธีเลือก dimension ที่เหมาะสมตาม use case#
หากคุณยังเดาขนาด dimension อยู่ ส่วนนี้ของ text-embedding-3-small Dimensions Explained คือทางลัด: จับคู่ dimension กับ workload แล้วตรวจสอบด้วย eval set ขนาดเล็กก่อนใช้งานจริง
อธิบาย dimensions ของ text-embedding-3-small สำหรับ RAG และ enterprise search#
RAG และ internal search ล้มเหลวอย่างรวดเร็วเมื่อ recall ลดลง ผู้ใช้ถามคำถามหนึ่งข้อ แล้วออกไปหากผลลัพธ์อันดับต้น ๆ ขาดข้อเท็จจริงสำคัญ ดังนั้นจุดเริ่มต้นของคุณควรเป็นคุณภาพ ไม่ใช่ storage
ใช้ 1536 เป็น baseline สำหรับ text-embedding-3-small จากนั้นค่อยทดสอบขนาดที่ต่ำกว่าเพียงหนึ่งระดับหลังจากคุณยืนยัน recall บน query ที่ยากแล้ว query ที่ยากหมายถึงคำถามยาว คำที่พบไม่บ่อย และ intent แบบผสม
Chunking เปลี่ยนผลลัพธ์มากกว่าที่หลายคนคาด Chunk ขนาดเล็กบวก dimension ต่ำอาจทำให้สูญเสีย context สองครั้ง: ครั้งหนึ่งตอนแบ่ง chunk และอีกครั้งตอน embedding หาก chunk ของคุณสั้น ให้คง dimension สูงไว้ หาก chunk ของคุณยาวและสะอาด คุณสามารถทดสอบขนาดต่ำลงได้โดยลดความเสี่ยง
dimensions ของ text-embedding-3-small สำหรับ recommendation, clustering และ semantic routing#
ระบบเหล่านี้มักสนใจความเร็วและการจัดกลุ่มที่เสถียร มากกว่า top-1 recall ที่สมบูรณ์แบบ การตั้งค่าระดับกลางจึงมักให้สมดุลดีที่สุด
สำหรับ routing ความคล้ายโดยประมาณมักเพียงพอ เพราะโมเดลขั้นที่สองสามารถ rerank หรือตรวจสอบได้ นั่นหมายความว่าคุณสามารถทดสอบ dimensions ที่ต่ำกว่าได้เร็วกว่าที่ทำใน RAG สำหรับ clustering ให้ตัดสินจาก cluster purity และ data drift รายสัปดาห์ ไม่ใช่แค่ offline run ครั้งเดียว
เลือก dimension ที่เล็กที่สุดซึ่งยังรักษา downstream metrics ของคุณให้เสถียรตลอด traffic cycle ครบสองรอบ
อธิบาย dimensions ของ text-embedding-3-small สำหรับ workload หลายภาษาและเฉพาะโดเมน#
ภาษาเฉพาะโดเมนเปลี่ยนโจทย์ คำศัพท์ด้านกฎหมาย การแพทย์ หรือฮาร์ดแวร์อาจอยู่ใกล้กันในภาษาธรรมชาติ แต่ห่างกันในความหมาย dimension ต่ำอาจทำให้เส้นแบ่งเหล่านี้พร่าเลือน
traffic หลายภาษาต้องการการตรวจสอบแยกตามภาษา อย่าเฉลี่ยทุกอย่างให้เป็นคะแนนเดียว รันชุด intent เดียวกันในแต่ละกลุ่มภาษาหลัก แล้วเปรียบเทียบรูปแบบการพลาด ขนาดที่ใช้งานได้ในภาษาอังกฤษอาจล้มเหลวกับ query ภาษาผสมหรือคำ long-tail
| Use case | Dimension เริ่มต้นที่แนะนำ | สิ่งที่ต้องวัดก่อนลดขนาด | สัญญาณความล้มเหลวทั่วไป |
|---|---|---|---|
| RAG / enterprise search | 1536 | recall บน query ที่ยาก, answer grounding | เอกสารที่ถูกต้องไม่อยู่ในผลลัพธ์อันดับต้น ๆ |
| Recommendation | กลาง (ทดสอบต่ำกว่า 1536) | ความเสถียรของ CTR หรือ conversion rate | item ที่คล้ายแต่ไม่เกี่ยวข้องเพิ่มขึ้น |
| Semantic routing | กลางถึงต่ำกว่า | route accuracy + fallback rate | route ผิด, fallback rate สูงขึ้น |
| Multilingual / domain-heavy | 1536 | recall แยกตามภาษา, ข้อผิดพลาดระดับคำศัพท์ | คำที่พบไม่บ่อยถูกแมปเป็นความหมายทั่วไป |
แหล่งที่มา: ข้อมูล dimension ของโมเดลจาก Crazyrouter model list (text-embedding-3-small: 1536, text-embedding-3-large: 3072)
<.-- IMAGE: เมทริกซ์การตัดสินใจตามกรณีการใช้งาน (RAG, recsys, routing, multilingual) พร้อมมิติเริ่มต้นที่แนะนำ -->
คำแนะนำการใช้งาน: API, Vector Schema และขั้นตอน Migration#
อธิบาย dimensions ของ text-embedding-3-small ใน API request#
baseline ที่ปลอดภัยสำหรับ text-embedding-3-small คือ 1536 dimensions คุณสามารถขอขนาดที่เล็กกว่าด้วย field dimensions แต่ต้องคงขนาดนั้นให้เหมือนกันต่อ index หาก document vectors ใช้ 1024 แต่ query vectors ใช้ 1536 คุณภาพ retrieval จะไม่เสถียร แม้ทั้งสอง call จะสำเร็จก็ตาม
ใช้ค่า configuration เดียวสำหรับ write path และ read path จากนั้นตรวจสอบในทุก request: input text ต้องไม่ว่าง, ความยาวเวกเตอร์ต้องเท่ากับ dimension ที่ configure ไว้ และทุกค่าต้องเป็นจำนวนจริง (ไม่มี NaN ไม่มี Inf) หาก validation ล้มเหลว ให้ส่ง item ไปยัง retry queue และ re-embed ด้วยขนาดเริ่มต้นของคุณ
คุณสามารถใช้ OpenAI SDK กับ endpoint ที่ compatible เช่น https://ai.crazyrouter.us/v1 จากนั้น pin model และ dimension ไว้ในไฟล์ configuration กลางไฟล์เดียวที่ทุก service ใช้ร่วมกัน
การควบคุม dimensions ของ text-embedding-3-small ใน vector schema และการออกแบบ index#
เก็บ dimension เดียวต่อ index และให้ query vectors กับ document vectors อยู่ในขนาดเดียวกัน
ใช้ชื่อ collection ที่ล็อก dimension เช่น kb_d1536_v1 และ kb_d1024_v1 การตั้งชื่อนี้ทำให้ migration อ่านง่ายและป้องกันการผสมกันแบบเงียบ ๆ
<.-- IMAGE: แผนภาพสถาปัตยกรรมแสดง ingestion, embedding service, ดัชนีเวกเตอร์คู่ และ query router -->
เมื่อ dimension เปลี่ยน ให้สร้าง index configuration ใหม่ด้วยเวกเตอร์ใหม่ สำหรับ HNSW ให้ปรับแต่ง graph และ search settings หลัง rebuild สำหรับ IVF ให้ฝึก centroids ใหม่บนเวกเตอร์จาก dimension size ใหม่ การใช้ข้อมูลฝึก index เก่าซ้ำอาจทำให้ recall แย่ลง
อธิบาย dimensions ของ text-embedding-3-small สำหรับ migration จากโมเดลเก่า#
รัน migration เป็นเฟส:
| เฟส | Write path | Read path | สิ่งที่ต้องตรวจสอบ |
|---|---|---|---|
| Dual write | embedding เก่า + ใหม่ | index เก่า | อัตราสำเร็จของ write และข้อผิดพลาด validation ของเวกเตอร์ |
| Shadow read | embedding เก่า + ใหม่ | ผู้ใช้เห็นของเก่า, log ของใหม่ | top-k overlap, latency, query case ที่แย่ |
| Cutover | embedding เก่า + ใหม่ | index ใหม่ | relevance pass rate และเป้าหมาย p95 latency |
| Rollback | คง dual write ต่อไป | สลับกลับไปของเก่า | ใช้เมื่อ error เพิ่มขึ้นหรือ relevance ลดลง |
แหล่งที่มา: Crazyrouter knowledge base (text-embedding-3-small ที่ 1536 dimensions; OpenAI-compatible API; รองรับ 300+ โมเดล)
นี่คือแก่นเชิงปฏิบัติของ text-embedding-3-small Dimensions Explained: ล็อก dimension ทดสอบด้วย shadow traffic และ cutover หลังจากวัด parity แล้วเท่านั้น
การดำเนินงาน Production: ตรวจสอบ Drift, Quality Regression และ Workflow ของทีม#
คุณเลือก dimension size ด้วย offline test ซึ่งเป็นจุดเริ่มต้นที่ดี ความเสี่ยงจริงมักปรากฏภายหลัง หลังจากเนื้อหาใหม่ query mix ใหม่ และการเปลี่ยนแปลง ranking ส่งผลใน production ใน text-embedding-3-small Dimensions Explained คุณภาพระยะยาวมาจาก loop ที่แน่น: eval data คงที่, live behavior monitoring และ rollout process ที่ควบคุมได้
ตั้งค่าการตรวจสอบ dimension drift สำหรับ text-embedding-3-small#
ล็อก eval set และ metrics ของคุณก่อนเปลี่ยน dimension ทุกครั้ง เก็บ golden query set ที่สะท้อน intent ผู้ใช้จริง จากนั้นให้คะแนนทุกสัปดาห์ด้วย rubric เดิม จับคู่กับสัญญาณสดเพื่อให้คุณจับ drift ได้เร็ว ไม่ใช่รอจน support tickets สะสม
| สัญญาณ | Drift มีลักษณะอย่างไร | ความถี่ในการทบทวน | Trigger สำหรับดำเนินการ |
|---|---|---|---|
| คะแนน relevance ของ golden set | ผลลัพธ์อันดับต้น ๆ ไม่ตรงกับคำตอบที่รู้ว่าดีอีกต่อไป | สัปดาห์ละครั้ง | ลดลงเทียบกับ stable run ล่าสุด |
| CTR ใน retrieval block | ผู้ใช้คลิกเอกสารที่แนะนำน้อยลง | ทุกวัน | ลดลงต่อเนื่อง |
| Task success rate | session มากขึ้นไม่สามารถจบงานเป้าหมายได้ | ทุกวัน | ลดลงตาม segment |
| No-result rate | retrieval response ว่างเพิ่มขึ้น | ทุกวัน | เพิ่มขึ้นหลัง rollout |
แหล่งที่มาของตาราง: รูปแบบ operational runbook ที่ใช้ในส่วนนี้ (golden set + online metrics จาก outline ที่ให้มา)
<.-- IMAGE: dashboard mock showing weekly golden-set score, CTR trend, no-result rate, and alert thresholds -->
รันการทดลอง dimension ของ text-embedding-3-small อย่างปลอดภัยใน staging และ production#
เริ่มใน staging ด้วยการ replay query จากช่วง 7 ถึง 14 วันที่ผ่านมา จากนั้นย้ายไป production ด้วย canary slice แล้วค่อยขยายตาม user segment และ region เตรียม rollback ให้พร้อม หากคุณภาพลดลง ให้หยุดการเพิ่ม traffic สลับกลับไปใช้ dimension ที่เสถียรล่าสุด และบันทึกประเภท query ที่ล้มเหลว วิธีนี้ช่วยทำให้ incident สั้นลงและให้ข้อมูลสะอาดสำหรับการทดสอบครั้งต่อไป
Workflow ของทีมสำหรับการอธิบาย text-embedding-3-small Dimensions#
การประเมินข้ามทีมมักล้มเหลวเพราะผู้คนทดสอบใน browser session ที่ปะปนกัน SEO, product และ ML อาจเขียนทับ state ของกันและกัน จากนั้นไม่มีใครเชื่อผลลัพธ์ คุณสามารถใช้ profile ที่แยกจากกันของ DICloak เพื่อให้แต่ละบทบาททดสอบ build เดียวกันโดยไม่มี session conflict หรือ account crossover
เครื่องมืออย่าง DICloak ช่วยให้คุณตั้งค่า proxy rules และ session แบบคงที่ต่อ profile ได้ นั่นหมายความว่าการทดสอบ "US-English account" และ "EU account" ของคุณทำงานในสภาพแวดล้อม network ที่เสถียรทุกครั้ง setup ที่ทำซ้ำได้ช่วยให้การตรวจสอบ ranking ตาม dimension เปรียบเทียบกันระหว่างเพื่อนร่วมทีมได้ง่ายขึ้น และให้เส้นทางที่ทำซ้ำได้และปลอดภัยสำหรับงาน text-embedding-3-small Dimensions Explained ในกระบวนการ production
ข้อผิดพลาดทั่วไปและ Checklist สุดท้ายสำหรับการเลือก Dimension#
หากคุณอ่านมาถึงตรงนี้ text-embedding-3-small Dimensions Explained ควรจบด้วยการตัดสินใจ launch ไม่ใช่การเดา
ข้อผิดพลาดด้าน dimension ของ text-embedding-3-small ที่ทำให้ production พัง#
| ข้อผิดพลาด | เกิดอะไรขึ้น | ต้องทำอะไร |
|---|---|---|
| คุณเชื่อเฉพาะ benchmark score ของ vendor | search ดูดีในการทดสอบ แต่ query จริงของคุณพลาด intent | สร้าง internal eval set จาก query ผู้ใช้จริง แล้วให้คะแนนการตั้งค่า dimension แต่ละแบบบนชุดนั้น |
| คุณลด storage cost แล้วข้าม quality check | เวกเตอร์ขนาดต่ำลงช่วยประหยัดเงิน แต่ click quality ลดลงและ support tickets เพิ่มขึ้น | ติดตาม retrieval quality และพฤติกรรมผู้ใช้ร่วมกันก่อน launch |
| คุณทดสอบเฉพาะ relevance | index setting ที่เร็วก็ยังอาจไม่ผ่านเป้าหมาย p95 ของคุณ | วัด latency แบบ end-to-end: embed + index search + rerank |
Checklist 10 ข้อสุดท้ายสำหรับการ launch text-embedding-3-small Dimensions Explained#
- ล้างข้อมูลซ้ำและข้อความที่เสียหายใน source data
- ครอบคลุม head, mid และ tail queries ใน benchmark ของคุณ
- เปรียบเทียบอย่างน้อยสองขนาด: 1536 (text-embedding-3-small) และ 3072 (text-embedding-3-large)
- บันทึก top-k relevance สำหรับแต่ละขนาดบน query set เดียวกัน
- บันทึก p95 latency ตั้งแต่ API call ไปจนถึงผลลัพธ์ ranking สุดท้าย
- แปลงจำนวน dimension เป็น storage cost ต่อเวกเตอร์หนึ่งล้านตัว
- รัน canary ด้วย traffic จริงและ success metrics
- เตรียม rollback procedure ก่อน full launch
- กำหนด owner หนึ่งคนสำหรับ monitoring และ alert response
- ตั้งความถี่สำหรับ retraining หรือ embedding recheck
launch เฉพาะเมื่อ relevance, p95 latency และ storage cost ผ่านร่วมกัน
<.-- IMAGE: One-page launch checklist graphic for embedding dimension decisions. -->
คำถามที่พบบ่อย#
ใน text-embedding-3-small Dimensions Explained dimension เริ่มต้นที่ดีที่สุดคืออะไร#
จุดเริ่มต้นที่ใช้งานได้จริงคือ 512 สำหรับทีมส่วนใหญ่ หรือ 1024 หากเนื้อหาของคุณซับซ้อน เช่น เอกสารกฎหมาย เทคนิค หรือเอกสารยาว ใน text-embedding-3-small Dimensions Explained ค่านี้ให้สมดุลที่แข็งแรงระหว่างคุณภาพ ความเร็ว และต้นทุน โดยไม่ผูกมัดมากเกินไปตั้งแต่ช่วงแรก จากนั้นให้รัน benchmark ขนาดเล็กด้วย query ผู้ใช้จริงและ filter ที่คาดว่าจะใช้ เลือก dimension ที่เล็กที่สุดซึ่งยังผ่านเป้าหมาย relevance ของคุณ ไม่ใช่ค่าที่ดูดีที่สุดใน toy test
การลด dimensions ใน text-embedding-3-small Dimensions Explained ทำให้ retrieval quality ลดลงเสมอหรือไม่#
dimensions ที่ต่ำกว่าไม่ได้ทำให้ผลลัพธ์เสียอย่างมีนัยสำคัญเสมอไป สำหรับ FAQ search แบบสั้นหรือโดเมนแคบ การลดลงอาจน้อยมาก สำหรับ catalog กว้าง เนื้อหาหลายภาษา หรือ semantic matching ที่ละเอียด คุณภาพอาจลดลงเร็วกว่า ใน text-embedding-3-small Dimensions Explained ให้มอง dimensions เป็นปุ่มปรับแต่ง: เปรียบเทียบ 256, 512 และ 1024 บน query set เดียวกัน แล้วใช้ขนาดที่เล็กที่สุดซึ่งยังรักษา Recall@k และ ranking quality ที่ยอมรับได้สำหรับผู้ใช้จริงของคุณ
dimensions ของ text-embedding-3-small ส่งผลต่อต้นทุน vector database อย่างไร#
ต้นทุนจะ scale โดยประมาณเป็นเส้นตรงตามจำนวน dimensions หากคุณลดเวกเตอร์จาก 1024 เป็น 512 raw vector storage จะลดลงประมาณครึ่งหนึ่ง แนวโน้มเดียวกันนี้มักเกิดกับการใช้ RAM และ search compute ด้วย แต่ต้องรวม index overhead: โครงสร้าง ANN เพิ่ม memory สำหรับ graph links, metadata และ internal accounting ดังนั้นการประหยัดโดยรวมยังชัดเจน แต่ไม่เท่ากับ vector bytes เพียงอย่างเดียว ในทางปฏิบัติ ให้ประมาณขนาด index ทั้งหมด ไม่ใช่แค่ embedding size ก่อนกำหนด dimension สุดท้าย
ฉันต้อง embed เอกสารทั้งหมดใหม่เมื่อเปลี่ยน dimensions หรือไม่#
ใช่ เวกเตอร์ที่สร้างด้วย dimension หนึ่งไม่สามารถผสมกับเวกเตอร์จากอีก dimension หนึ่งใน index เดียวที่สอดคล้องกันได้ เมื่อคุณเปลี่ยน dimensions ให้ embed เอกสารทั้งหมดใหม่และ rebuild index สำหรับระบบ production ให้ใช้ migration ที่ปลอดภัยกว่า: สร้าง index ใหม่แบบขนาน ส่ง traffic บางส่วนไปยัง index ใหม่ เปรียบเทียบคุณภาพและ latency แล้วค่อยสลับเต็มรูปแบบ วิธีนี้หลีกเลี่ยง downtime และรักษาพฤติกรรม search ให้เสถียรระหว่างการเปลี่ยนแปลง
ควรติดตาม metrics ใดเมื่อเปรียบเทียบ dimensions#
ติดตามสามกลุ่ม: relevance, speed และ cost สำหรับ relevance ให้ใช้ Recall@k, nDCG และ MRR บน labeled query set สำหรับ speed ให้ดู p50/p95/p99 latency เพราะ tail latency ส่งผลต่อประสบการณ์ผู้ใช้ สำหรับ cost ให้วัด storage ต่อเอกสารหนึ่งล้านรายการ, RAM footprint และต้นทุนต่อ 1,000 queries ใน text-embedding-3-small Dimensions Explained การให้คะแนนแบบนี้ช่วยให้คุณหลีกเลี่ยงการตัดสินใจด้านเดียวที่ประหยัด storage แต่ทำลาย ranking quality มากเกินไป
text-embedding-3-small เหมาะกับ multilingual search ที่ dimensions ต่ำกว่าหรือไม่#
ทำได้ แต่ multilingual search ต้องการการทดสอบที่เข้มงวดกว่าการค้นหาภาษาเดียว dimensions ที่ต่ำกว่าอาจรวมความหมายละเอียดอ่อนข้ามภาษาเข้าด้วยกัน โดยเฉพาะ query สั้นและ script ผสม เริ่มที่ 512 หรือ 1024 จากนั้นทดสอบตามคู่ภาษา ความยาว query และคำเฉพาะโดเมน ใน text-embedding-3-small Dimensions Explained setup หลายภาษามักได้ประโยชน์จาก dimensions ที่ใหญ่ขึ้นเมื่อความแม่นยำสำคัญ เลือกการตั้งค่าที่เล็กที่สุดซึ่งยังผ่านเป้าหมาย relevance สำหรับแต่ละกลุ่มภาษาหลัก
ข้อสรุปหลักคือ dimensions ของ text-embedding-3-small เป็นปุ่มปรับแต่งเชิงปฏิบัติ: dimensions ที่สูงขึ้นสามารถปรับปรุงความครบถ้วนของความหมาย ขณะที่ dimensions ที่ต่ำลงช่วยลด storage, latency และต้นทุน ดังนั้นตัวเลือกที่ถูกต้องจึงขึ้นอยู่กับเป้าหมาย retrieval quality และข้อจำกัดของระบบคุณ ให้ถือว่า dimension size เป็นการตัดสินใจเชิงประจักษ์ โดยเปรียบเทียบ recall, ranking quality และ performance แบบ end-to-end บนข้อมูลของคุณเอง แทนที่จะพึ่งค่าเริ่มต้น ทดสอบ dimensions หลายค่าใน pipeline ของคุณเองภายในสัปดาห์นี้ แล้วล็อกการตั้งค่า production ด้วยหลักฐาน ไม่ใช่การเดา
Implementation Guides
Available in other languages: