简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
text-embedding-3-small Afmetingen Uitgelegd: Hoe u de Juiste Grootte voor Kwaliteit en Kosten Kiest
Een praktische gids voor text-embedding-3-small afmetingen, hoe u kunt kiezen tussen 256, 512, 1024 en 1536 dimensies.
text-embedding-3-small Afmetingen Uitgelegd: Hoe u de Juiste Grootte voor Kwaliteit en Kosten Kiest#
Bij 1536 dimensies gebruikt een text-embedding-3-small-vector die als float32 is opgeslagen 6,144 bytes, waardoor 10 miljoen vectoren ongeveer 61 GB nodig hebben voordat index-overhead wordt meegerekend. Dat getal verrast teams vaak wanneer retrieval op kleine schaal goedkoop lijkt, maar de geheugenkosten stijgen en de querytijd toeneemt zodra de corpus groeit. Het lastige is dat hogere dimensies de ranking op de ene dataset kunnen verbeteren, terwijl dezelfde instelling op een andere dataset opslag verspilt en extra latency toevoegt.
Dat is de kern van text-embedding-3-small Afmetingen Uitgelegd: er is geen universele instelling die voor elke workload wint. U moet de dimensiegrootte kiezen door uw eigen relevantiedoel, p95-latencylimiet en budget voor vectoropslag samen te testen, niet afzonderlijk. Als u alleen op kwaliteit optimaliseert, lopen de kosten snel op. Als u alleen de grootte verkleint, kan de zoekkwaliteit op manieren teruglopen die gebruikers merken.
U ziet hier een praktische selectiemethode: bouw een kleine evaluatieset, vergelijk relevantie bij twee of drie dimensiegroottes, meet de end-to-end responstijd en zet het aantal dimensies om naar echte opslagkosten per miljoen vectoren. Daarna wordt de juiste grootte een meetbare engineeringkeuze, geen giswerk.
Wat "Dimensions" betekent in text-embedding-3-small (en waarom het uitkomsten verandert)#
In eenvoudige termen betekent text-embedding-3-small Afmetingen Uitgelegd één ding: hoeveel betekenis u in elke vector bewaart. Het aantal dimensies is een compressieknop, geen kwaliteitsschakelaar. text-embedding-3-small heeft een maximale grootte van 1536 dimensies (volgens de modelspecificatie in de kennisbank). Lagere groottes comprimeren sterker.
text-embedding-3-small dimensions explained: semantische betekenis naar numerieke vectoren#
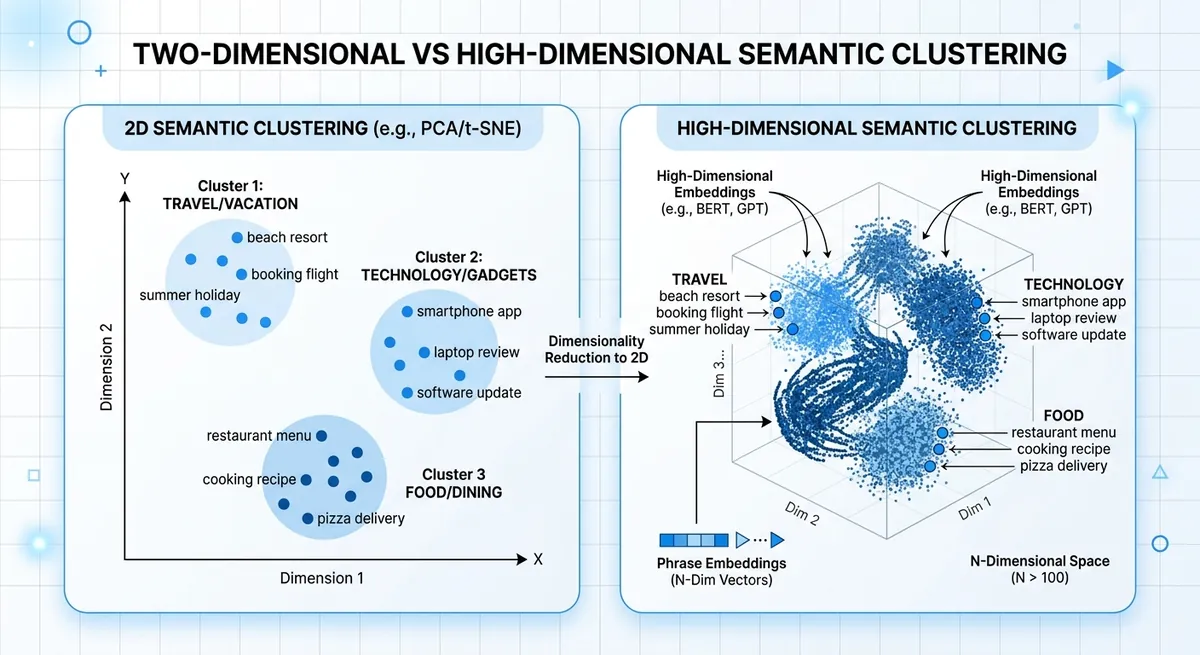
Een embedding zet tekst om in getallen, zodat vergelijkbare zinnen dicht bij elkaar in de vectorruimte liggen. "Reset my password" en "I cannot sign in" zouden dicht bij elkaar moeten uitkomen. Elke extra dimensie geeft het model meer ruimte om nuance op te slaan, zoals intentie, toon of domeintermen. Als u de vector verkleint, behoudt u de kernbetekenis maar verliest u fijnere details.
text-embedding-3-small dimensiegrootte en veranderingen in rankingkwaliteit#
Lagere dimensies kunnen zoeken versnellen en opslag verminderen, maar de nearest-neighbor-ranking kan verschuiven. Die verschuiving wordt zichtbaar wanneer twee intenties aan de oppervlakte op elkaar lijken maar in actie verschillen, zoals "cancel plan" versus "pause plan."
| Keuze voor vectorgrootte | Semantische getrouwheid | Runtime-snelheid | Opslag per 1M vectoren (float32) |
|---|---|---|---|
| 1536 (volledige text-embedding-3-small) | Hoogste detailbehoud | Langzamer dan kleinere vectoren | ~6.1 GB |
| 768 (gecomprimeerd) | Enig detailverlies | Sneller | ~3.1 GB |
| 512 (gecomprimeerd) | Meer verliesrisico bij dicht bij elkaar liggende intenties | Nog sneller | ~2.0 GB |
Bron: maximale dimensie van text-embedding-3-small uit de aangeleverde kennisbank; opslagberekening op basis van dimensions × 4 bytes.
Dat is de praktische kern van text-embedding-3-small Afmetingen Uitgelegd: stem dimensies af met relevantietests, p95-latency en vectoropslag samen.
text-embedding-3-small Dimensie-opties: Praktische bereiken en afwegingen#
Voor text-embedding-3-small is de native vectorgrootte 1536 dimensies. In echte systemen verkorten teams vectoren vaak om RAM, schijfgebruik en ANN-indexbelasting te verminderen. Opslag groeit lineair met het aantal dimensies, dus elke keuze voor grootte is direct een keuze voor kosten en latency. Dit is de praktische kern van text-embedding-3-small Afmetingen Uitgelegd.
text-embedding-3-small Afmetingen Uitgelegd: veelgebruikte instellingen en best passende use cases#
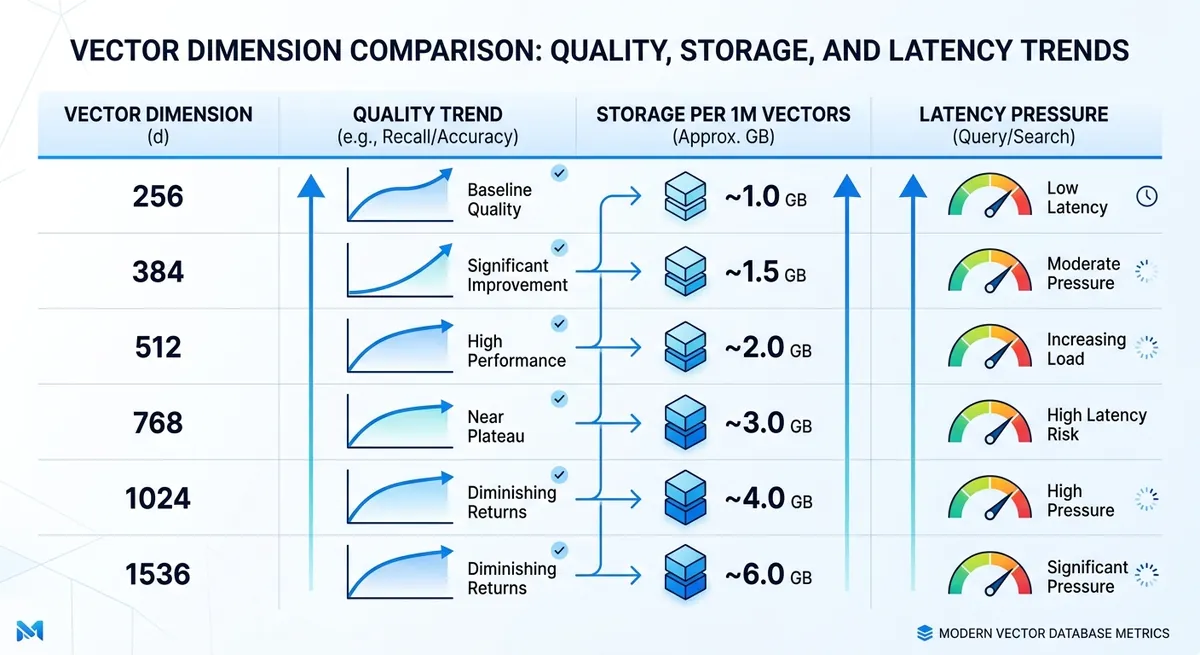
Als u grove standaardwaarden nodig hebt, is deze tabel een goed startpunt voor A/B-tests.
| Dimensie | Ruwe opslag per 1M vectoren (float32) | Beste fit | Typisch risico |
|---|---|---|---|
| 256 | ~0.95 GB | Strakke latency- of budgetlimieten, eenvoudige intentmatching | Meer missers bij genuanceerde queries |
| 384 | ~1.43 GB | Kostenbewuste semantische search met korte teksten | Lagere recall bij edge cases |
| 512 | ~1.91 GB | Gebalanceerde search voor supportdocumenten, producthulp, FAQ | Enig verlies van long-tail-betekenis |
| 768 | ~2.86 GB | Retrieval met extra balans, gemengde querystijlen | Gematigde groei van infrastructuurkosten |
| 1024 | ~3.81 GB | High-recall RAG over dichte documenten | Hoger indexgeheugen en langere querytijd |
| 1536 | ~5.72 GB | Retrieval met volledige getrouwheid, genuanceerde gelijkenis | Hoogste druk op opslag en latency |
Bron: dimensiebereiken uit de aangeleverde outline en modelinformatie (text-embedding-3-small = 1536). Opslag is berekend als dimensions × 4 bytes × 1,000,000 vectors.
text-embedding-3-small kwaliteitsafwegingen: waar degradatie begint#
Kwaliteitsverlies verschijnt meestal eerder bij taken die veel precisie vragen. FAQ-retrieval kan bruikbaar blijven bij 384 of 512, terwijl juridische of medische search vaak 1024 of 1536 nodig heeft om subtiele betekenisverschillen te behouden.
Ook de taalmix verandert de veilige ondergrens. Monolinguale Engelse workloads kunnen bij lagere groottes overeind blijven. Meertalige traffic, code-switching en gemengde schriftsystemen hebben de neiging eerder te degraderen wanneer vectoren korter worden.
U kunt deze test snel uitvoeren via Crazyrouter met één API-sleutel en retrievalkwaliteit vergelijken bij 512, 768 en 1536 op dezelfde evaluatieset. Dat geeft een meetbaar afkappunt in plaats van giswerk.
Kwaliteit, latency en kosten: de drievoudige benchmark die u echt nodig hebt#
U hebt al gezien waarom één metriek misleidend kan zijn. Voor text-embedding-3-small Afmetingen Uitgelegd is de praktische stap om één relevantiedoel, één latencybudget en één opslagbudget tegelijk te testen. Kies de kleinste dimensie die nog steeds aan uw kwaliteitslat voldoet binnen uw p95-latencylimiet.
text-embedding-3-small dimensietestset: bouw offline relevantie die u vertrouwt#
Gebruik echte zoeklogs, supporttickets en chatprompts. Bouw indien mogelijk 200-500 queryvoorbeelden. Die omvang is genoeg om zwakke plekken bloot te leggen zonder uw team te vertragen.
Label wat "goed" betekent voor elke query. Houd labels eenvoudig: relevant, gedeeltelijk relevant, niet relevant. Voeg bewust moeilijke gevallen toe: korte queries, queries met typefouten, domeintermen en meertalige queries. Als uw app gemengde talen ondersteunt, neem gemengdtalige queries op in dezelfde set.
Laat niet slechts één persoon resultaten labelen. Twee reviewers verminderen bias snel.
text-embedding-3-small dimensions benchmark metrics: kwaliteit en latency samen#
Volg rankingkwaliteit en snelheid in één run. Recall@k vertelt u of het juiste item in de top-k verschijnt. MRR en nDCG vertellen u of het dicht bij de top verschijnt, waar gebruikers klikken.
Splits voor latency het pad op: embeddingtijd en retrievaltijd. Let op p95 en p99, niet alleen op gemiddelde latency. Trage tail-requests bepalen de gebruikerservaring.
| Dimensiekandidaat | Bekende grootte per vector (float32) | Relatief indexgeheugen | Kwaliteitsmetrics om te volgen | Latencymetrics om te volgen |
|---|---|---|---|---|
| 1536 (text-embedding-3-small) | 6,144 bytes | 1x baseline | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| 3072 (text-embedding-3-large) | 12,288 bytes | ~2x vs 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
| Kandidaat met lagere dimensie in uw stack | dims × 4 bytes | dims / 1536 | Recall@k, MRR, nDCG | Embedding latency, retrieval p95/p99 |
Bron: modeldimensies uit de Crazyrouter-modellijst (text-embedding-3-small: 1536, text-embedding-3-large: 3072). Byteberekening gebruikt float32-vectoren.
text-embedding-3-small dimensiekostenmodel: van opslag naar businessimpact#
Zet dimensies om naar geld voordat u uitrolt.
Opslag per miljoen vectoren = dimension × 4 bytes × 1,000,000, vermenigvuldig daarna met het aantal replica's. Voeg index-overhead van uw vectordatabase toe.
<.-- IMAGE: Infographic in formulevorm voor het schatten van vectoropslag en jaarlijkse kosten per dimensie en corpusgrootte. -->
Koppel daarna kwaliteitsverbetering aan businesssignalen die u al volgt, zoals CTR, ticketdeflectie of conversie. Als een grotere dimensie nDCG een beetje verhoogt maar het geheugen verdubbelt en p95 mist, behoud dan de kleinere instelling. Als deze de gerankte relevantie genoeg verhoogt om conversie te beïnvloeden, hebt u een duidelijke businesscase.
Hoe u de juiste dimensie kiest per use case#
Als u nog steeds gokt naar de dimensiegrootte, is dit deel van text-embedding-3-small Afmetingen Uitgelegd de shortcut: koppel dimensie aan workload en verifieer daarna met een kleine evaluatieset voordat u uitrolt.
text-embedding-3-small Afmetingen Uitgelegd voor RAG en enterprise search#
RAG en interne search falen snel wanneer recall daalt. Gebruikers stellen één vraag en haken af als de topresultaten belangrijke feiten missen. Uw startpunt moet daarom kwaliteit zijn, niet opslag.
Gebruik 1536 als baseline voor text-embedding-3-small en test daarna pas één lagere grootte nadat u recall op moeilijke queries hebt bevestigd. Moeilijke queries zijn lange vragen, zeldzame termen en gemengde intentie.
Chunking verandert het resultaat meer dan mensen verwachten. Kleine chunks plus lage dimensies kunnen twee keer context verliezen: één keer bij het splitsen en één keer bij embedding. Als uw chunks kort zijn, houd dan hogere dimensies aan. Als uw chunks lang en schoon zijn, kunt u een lagere grootte testen zonder blind risico.
text-embedding-3-small dimensies voor aanbevelingen, clustering en semantische routing#
Deze systemen geven meestal om snelheid en stabiele groepering, niet om perfecte top-1-recall. Een middelmatige instelling geeft vaak de beste afweging.
Voor routing is benaderende gelijkenis vaak genoeg, omdat een second-stage model kan re-ranken of verifiëren. Dat betekent dat u lagere dimensies eerder kunt testen dan u bij RAG zou doen. Beoordeel voor clustering clusterzuiverheid en drift over wekelijkse data, niet alleen één offline run.
Kies de kleinste dimensie die uw downstream-metriek twee volledige trafficcycli stabiel houdt.
text-embedding-3-small Afmetingen Uitgelegd voor meertalige en domeinspecifieke workloads#
Domeintaal verandert het spel. Juridische, medische of hardwaretermen kunnen in gewone taal dicht bij elkaar liggen maar qua betekenis ver uit elkaar. Lagere dimensies kunnen deze grenzen vervagen.
Meertalige traffic vraagt om checks per taal. Middel niet alles uit tot één score. Draai dezelfde intentieset over elk belangrijk taalsegment en vergelijk daarna mispatronen. Een grootte die in het Engels werkt, kan falen bij gemengdtalige queries of getranslitereerde termen.
| Use case | Aanbevolen startdimensie | Wat te meten voordat u verlaagt | Veelvoorkomend faalsignaal |
|---|---|---|---|
| RAG / enterprise search | 1536 | Recall op moeilijke queries, antwoordgronding | Correct document staat niet in topresultaten |
| Aanbevelingen | Medium (test onder 1536) | Stabiliteit van CTR of conversie | Vergelijkbare maar irrelevante items stijgen |
| Semantische routing | Medium tot lager | Route accuracy + fallback rate | Verkeerde route, hogere fallback |
| Meertalig / domeinzwaar | 1536 | Recall per taal, fouten op termniveau | Zeldzame termen worden gekoppeld aan generieke betekenis |
Bron: modeldimensie-informatie uit de Crazyrouter-modellijst (text-embedding-3-small: 1536, text-embedding-3-large: 3072). <.-- IMAGE: Beslismatrix per use case (RAG, recsys, routing, multilingual) met aanbevolen startdimensies. -->
Implementatiegids: API, vectorschema en migratiestappen#
text-embedding-3-small dimensions explained in API-requests#
De veilige baseline voor text-embedding-3-small is 1536 dimensies. U kunt een kleinere grootte aanvragen met het veld dimensions, maar houd die grootte vast per index. Als documentvectoren 1024 gebruiken en queryvectoren 1536, zal retrievalkwaliteit verschuiven, zelfs als beide calls slagen.
Gebruik één configuratiewaarde voor write- en read-paden en valideer vervolgens elke request: inputtekst is niet leeg, de vectorlengte is gelijk aan de geconfigureerde dimensie en elke waarde is een echt getal (geen NaN, geen Inf). Als validatie faalt, stuur het item dan naar een retry-queue en embed opnieuw met uw standaardgrootte.
U kunt de OpenAI SDK gebruiken met een compatibel endpoint zoals https://ai.crazyrouter.us/v1, en daarna model en dimensies vastpinnen in één gedeeld configuratiebestand dat door alle services wordt gebruikt.
text-embedding-3-small dimensiecontrole in vectorschema en indexontwerp#
Houd één dimensie per index aan en houd query- en documentvectoren op dezelfde grootte.
Gebruik dimensie-vergrendelde collectienamen zoals kb_d1536_v1 en kb_d1024_v1. Deze naamgeving houdt migraties leesbaar en voorkomt stille vermenging.
<.-- IMAGE: Architectuurdiagram met ingestion, embedding service, dubbele vectorindexen en queryrouter. -->
Wanneer dimensionaliteit verandert, bouw dan indexinstellingen opnieuw met de nieuwe vectoren. Voor HNSW moet u na de rebuild graph- en search-instellingen opnieuw afstemmen. Voor IVF traint u centroids opnieuw op vectoren met de nieuwe dimensiegrootte. Hergebruik van oude indextrainingdata kan recall schaden.
text-embedding-3-small dimensions explained voor migratie vanaf oudere modellen#
Voer migratie in fasen uit:
| Fase | Write-pad | Read-pad | Wat te controleren |
|---|---|---|---|
| Dual-write | Old + new embeddings | Old index | Write success rate en vector validation errors |
| Shadow-read | Old + new embeddings | User sees old, logs new | Top-k overlap, latency, bad query cases |
| Cutover | Old + new embeddings | New index | Relevance pass rate en p95 latency target |
| Rollback | Keep dual-write active | Switch back to old | Trigger on error spike or relevance drop |
Bron: Crazyrouter-kennisbank (text-embedding-3-small op 1536 dimensies; OpenAI-compatible API; 300+ ondersteunde modellen).
Dit is de praktische kern van text-embedding-3-small Afmetingen Uitgelegd: vergrendel dimensies, test met shadow traffic en stap pas over na gemeten pariteit.
Productie-operaties: drift monitoren, kwaliteitsregressies en teamworkflow#
U hebt een dimensiegrootte gekozen met offline tests. Goed begin. Het echte risico verschijnt later, nadat nieuwe content, een nieuwe querymix en rankingverschuivingen productie raken. In text-embedding-3-small Afmetingen Uitgelegd komt langetermijnkwaliteit uit een strakke loop: vaste evaluatiedata, live gedragschecks en gecontroleerde uitrolstappen.
Richt driftmonitoring in voor text-embedding-3-small-dimensies#
Vergrendel uw evaluatieset en metrics vóór elke dimensiewijziging. Houd een golden queryset bij die echte gebruikersintentie weerspiegelt en score deze vervolgens elke week met dezelfde rubric. Combineer dat met live signalen zodat u drift vroeg opmerkt, niet pas nadat supporttickets zich opstapelen.
| Signaal | Hoe drift eruitziet | Reviewritme | Actietrigger |
|---|---|---|---|
| Relevancescore van golden set | Topresultaten komen niet meer overeen met bekende goede antwoorden | Wekelijkse scorecard | Daling versus laatste stabiele run |
| CTR op retrievalblokken | Gebruikers klikken minder op voorgestelde documenten | Dagelijks | Aanhoudende daling |
| Taaksuccespercentage | Meer sessies ronden de doelactie niet af | Dagelijks | Neerwaartse trend per segment |
| No-result rate | Lege retrievalresponses nemen toe | Dagelijks | Piek na deploy |
Tabelbron: operationeel runbook-patroon gebruikt in deze sectie (golden set + online metrics uit de aangeleverde outline).
<.-- IMAGE: dashboardmock-up met wekelijkse golden-set-score, CTR-trend, no-result rate en alertdrempels -->
Voer text-embedding-3-small-dimensie-experimenten veilig uit in staging en productie#
Begin in staging met gereplayde queries van de laatste 7 tot 14 dagen. Ga naar productie met een canary-slice en breid daarna uit per gebruikerssegment en regio. Houd rollback klaar. Als kwaliteit daalt, pauzeer de trafficgroei, schakel terug naar de laatste stabiele dimensie en log welke querytypen faalden. Dit houdt incidenten kort en levert schone data op voor de volgende test.
Teamworkflow voor text-embedding-3-small Afmetingen Uitgelegd-experimenten#
Evaluatie tussen teams loopt vaak stuk doordat mensen testen in gemengde browsersessies. SEO, product en ML kunnen elkaars state overschrijven, waarna niemand het resultaat vertrouwt. U kunt geïsoleerde profielen van DICloak gebruiken zodat elke rol dezelfde build test zonder sessieconflicten of accountoverlap.
Tools zoals DICloak laten u vaste proxy- en sessieregels per profiel instellen. Dat betekent dat uw tests voor een "US-English account" en "EU account" elke keer onder stabiele netwerkomstandigheden draaien. Een reproduceerbare setup maakt dimensiegebaseerde rankingchecks eenvoudiger te vergelijken tussen teamgenoten en geeft u een herhaalbaar, veilig pad voor doorlopend text-embedding-3-small Afmetingen Uitgelegd-werk.
Veelvoorkomende fouten en een definitieve checklist voor dimensieselectie#
Als u tot hier hebt gelezen, zou text-embedding-3-small Afmetingen Uitgelegd moeten eindigen in een launchbeslissing, niet in een gok.
text-embedding-3-small-dimensiefouten die productie breken#
| Fout | Wat er misgaat | Wat te doen |
|---|---|---|
| U vertrouwt alleen op vendorscores uit benchmarks | Search ziet er in tests goed uit, maar uw echte queries missen intentie | Bouw een interne evaluatieset op basis van echte gebruikersqueries en score daarna elke dimensie-instelling op die set |
| U verlaagt opslagkosten en slaat kwaliteitschecks over | Lagere vectorgrootte bespaart geld, maar klikkwaliteit daalt en supporttickets nemen toe | Volg retrievalkwaliteit en gebruikersgedrag samen vóór uitrol |
| U test alleen relevantie | Snelle indexinstellingen kunnen nog steeds uw p95-doel missen | Meet end-to-end latency: embed + index search + rerank |
Definitieve 10-puntenchecklist voor text-embedding-3-small Afmetingen Uitgelegd go-live#
- Schoon duplicaten en kapotte tekst in brondata op.
- Dek head-, mid- en tail-queries af in uw benchmark.
- Vergelijk ten minste twee groottes: 1536 (text-embedding-3-small) en 3072 (text-embedding-3-large).
- Leg top-k-relevantie vast voor elke grootte op dezelfde queryset.
- Leg p95-latency vast van API-call tot definitief gerankt resultaat.
- Zet het aantal dimensies om naar opslagkosten per miljoen vectoren.
- Draai een canary met echte traffic en succesmetrics.
- Bereid rollbackstappen voor vóór volledige uitrol.
- Wijs één eigenaar aan voor monitoring en alertrespons.
- Stel een ritme in voor retraining- of re-embeddingreviews.
Ship alleen wanneer relevantie, p95-latency en opslagkosten samen slagen.
<.-- IMAGE: Grafische launchchecklist van één pagina voor beslissingen over embeddingdimensies. -->
Veelgestelde vragen#
In text-embedding-3-small Afmetingen Uitgelegd, wat is de beste standaarddimensie om mee te starten?#
Een praktisch startpunt is 512 voor de meeste teams, of 1024 als uw content complex is (juridisch, technisch, long-form documenten). In text-embedding-3-small Afmetingen Uitgelegd geeft dit een sterke balans tussen kwaliteit, snelheid en kosten zonder u vroeg vast te leggen. Draai daarna een kleine benchmark met uw echte gebruikersqueries en verwachte filters. Kies de kleinste dimensie die nog steeds aan uw relevantiedoel voldoet, niet alleen de dimensie die er in een speelgoedtest het beste uitziet.
Vermindert het verlagen van dimensies in text-embedding-3-small Afmetingen Uitgelegd altijd de retrievalkwaliteit?#
Lagere dimensies schaden resultaten niet altijd op een betekenisvolle manier. Voor korte FAQ-search of smalle domeinen kan de daling klein zijn. Voor brede catalogi, meertalige content of genuanceerde semantische matching kan kwaliteit sneller terugvallen. Behandel dimensie in text-embedding-3-small Afmetingen Uitgelegd als een afstemknop: vergelijk 256, 512 en 1024 op dezelfde queryset. Houd de kleinste grootte die aanvaardbare Recall@k en rankingkwaliteit voor uw echte gebruikers behoudt.
Hoe beïnvloeden text-embedding-3-small-dimensies de kosten van een vectordatabase?#
Kosten schalen grofweg lineair met het aantal dimensies. Als u vectoren verlaagt van 1024 naar 512, is ruwe vectoropslag ongeveer de helft. Dezelfde trend geldt voor RAM-gebruik en vaak ook querycompute. Maar reken index-overhead mee: ANN-structuren voegen geheugen toe voor graph links, metadata en interne boekhouding. De totale besparing is dus sterk, maar bestaat niet alleen uit vectorbytes. Schat in de praktijk de volledige indexgrootte, niet alleen de embeddinggrootte, voordat u een definitieve dimensie instelt.
Moet ik alle documenten opnieuw embedden wanneer ik dimensies wijzig?#
Ja. Een vector die op één dimensie is gebouwd, kan niet met vectoren uit een andere dimensie in één consistente index worden gemengd. Wanneer u dimensies wijzigt, moet u alle documenten opnieuw embedden en de index opnieuw opbouwen. Gebruik voor productiesystemen een veiligere migratie: draai een dual-index-uitrol. Bouw de nieuwe index parallel, stuur een deel van de traffic ernaartoe, vergelijk kwaliteit en latency en stap daarna volledig over. Dit voorkomt downtime en houdt zoekgedrag stabiel tijdens de overgang.
Welke metrics moet ik volgen wanneer ik dimensies vergelijk?#
Volg drie groepen: relevantie, snelheid en kosten. Gebruik voor relevantie Recall@k, nDCG en MRR op een gelabelde queryset. Let voor snelheid op p50/p95/p99-latency, omdat tail-latency de gebruikerservaring beïnvloedt. Meet voor kosten opslag per miljoen documenten, RAM-footprint en kosten per 1,000 queries. In text-embedding-3-small Afmetingen Uitgelegd helpt deze scorecard u eenzijdige keuzes te vermijden waarbij u opslag bespaart maar rankingkwaliteit te veel schaadt.
Is text-embedding-3-small geschikt voor meertalige search bij lagere dimensies?#
Het kan werken, maar meertalige search vraagt strengere tests dan single-language search. Lagere dimensies kunnen subtiele betekenis tussen talen samenvoegen, vooral bij korte queries en gemengde schriftsystemen. Start bij 512 of 1024 en test daarna per taalpaar, querylengte en domeintermen. In text-embedding-3-small Afmetingen Uitgelegd profiteren meertalige setups vaak van grotere dimensies wanneer precisie belangrijk is. Kies de kleinste instelling die nog steeds aan relevantiedoelen voldoet voor elk belangrijk taalsegment.
De kernconclusie is dat text-embedding-3-small-dimensies een praktische afstemhefboom zijn: hogere dimensies kunnen semantische getrouwheid verbeteren, terwijl lagere dimensies opslag, latency en kosten verminderen, waardoor de juiste keuze afhangt van uw doelen voor retrievalkwaliteit en uw systeembeperkingen. Behandel dimensiegrootte als een empirische beslissing door recall, rankingkwaliteit en end-to-end performance op uw eigen data te benchmarken in plaats van op standaardwaarden te vertrouwen. Test deze week meerdere dimensies in uw eigen pipeline en vergrendel daarna uw productie-instelling met bewijs, niet met giswerk.
Implementation Guides
Available in other languages: