 简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
2026年10月8日226 次浏览简体中文Comparison
Claude Haiku 5.5 vs Sonnet 4.6:谁更适合日常主力?
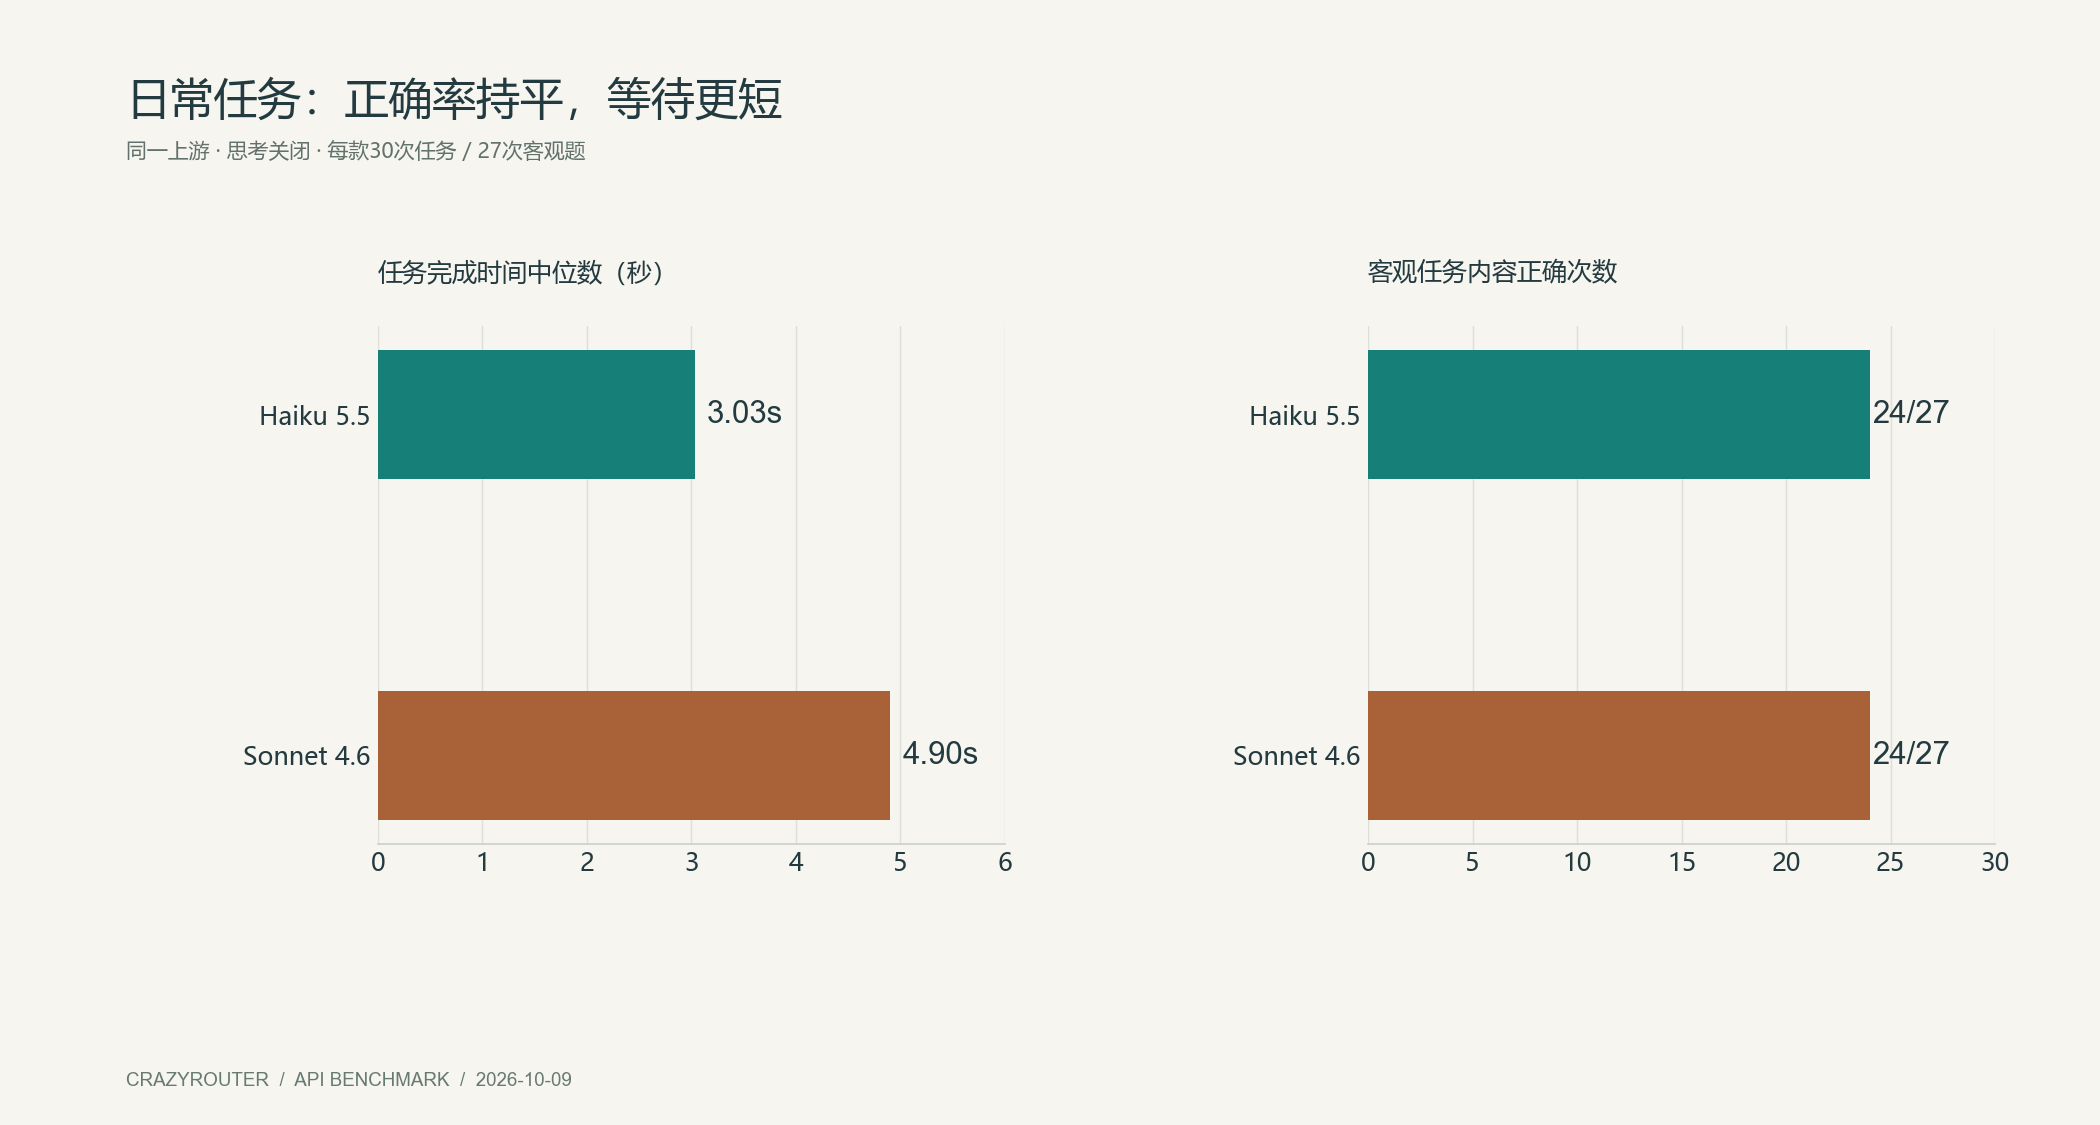
同一上游完成10类任务、每类3轮:Haiku 5.5与Sonnet 4.6均答对24/27道客观题,完成耗时中位数3.03秒与4.90秒。本文还原JSON格式问题、长规则思考复测与中文改写失误。
同一上游完成10类任务、每类3轮:Haiku 5.5与Sonnet 4.6均答对24/27道客观题,完成耗时中位数3.03秒与4.90秒。本文还原JSON格式问题、长规则思考复测与中文改写失误。
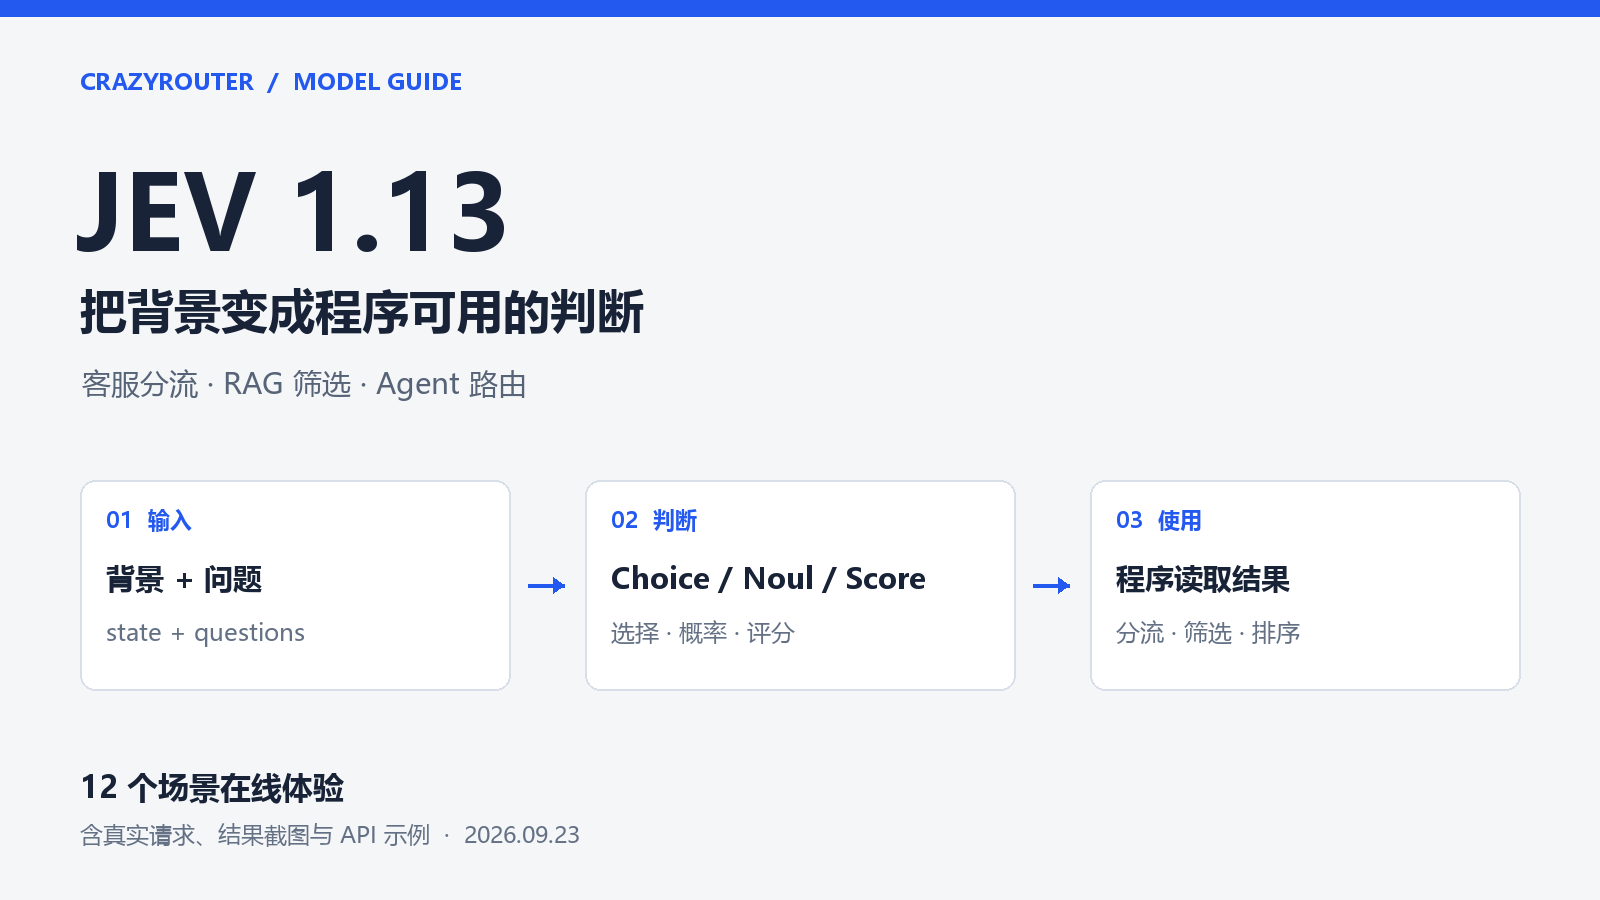
JEV 1.13 擅长把自然语言变成程序能直接使用的选择、概率和评分。本文结合中文客服分流、退款判断、RAG 筛选的实际调用,解释 Choice、Noul、Score 三种用法,并带你在 Crazyrouter JEV Decision Playground 体验 12 个可编辑场景,查看结果并复制 API 接入代码。
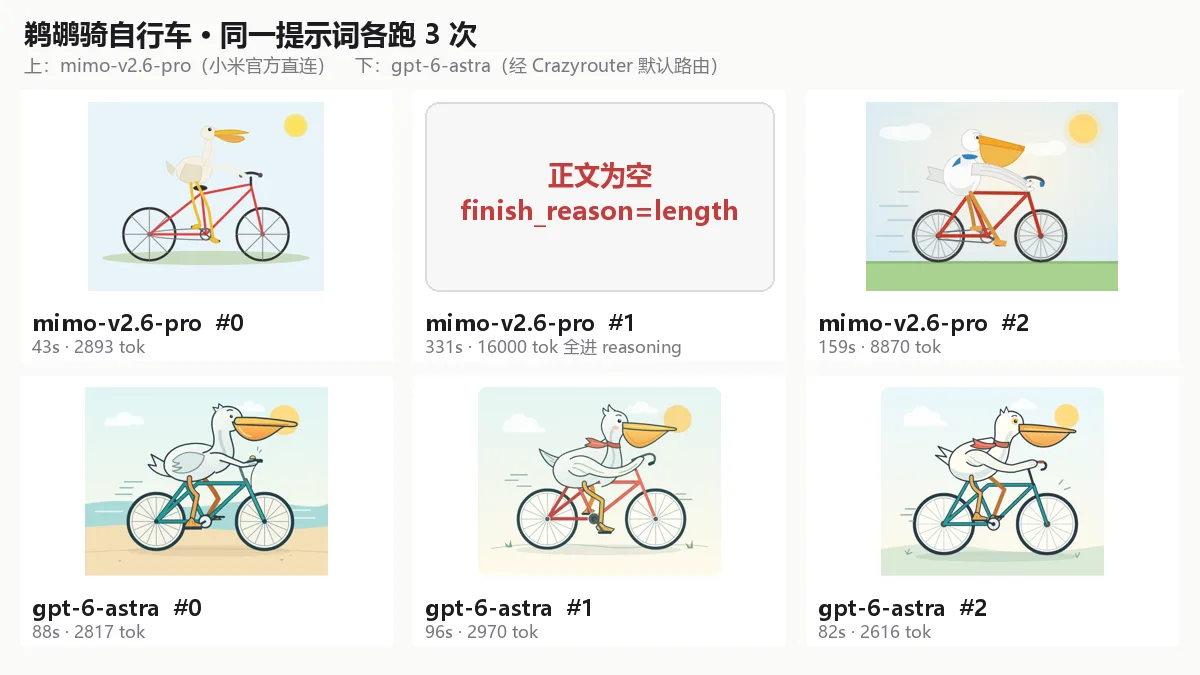
用鹈鹕骑车 SVG、糖果盒错误信念、字母计数、藏头诗等 8 道趣味探针各跑 3 次,实测小米 mimo-v2.6-pro 与 gpt-6-astra。7 道两边全对;鹈鹕 SVG 上 gpt 3/3、mimo 2/3 且一次正文为空。另抓到 gpt-6-astra 默认路由每次被注入约 4100 token。附 SVG 原件与原始记录。
同样的 Claude、GPT、Gemini 模型,Crazyrouter 比官方定价低 35%~45% 且充值零手续费;RPM 不分档、按业务定制;报错有真人一对一跟进。这篇文章把三点差异讲清楚,并附上具体价格对比。
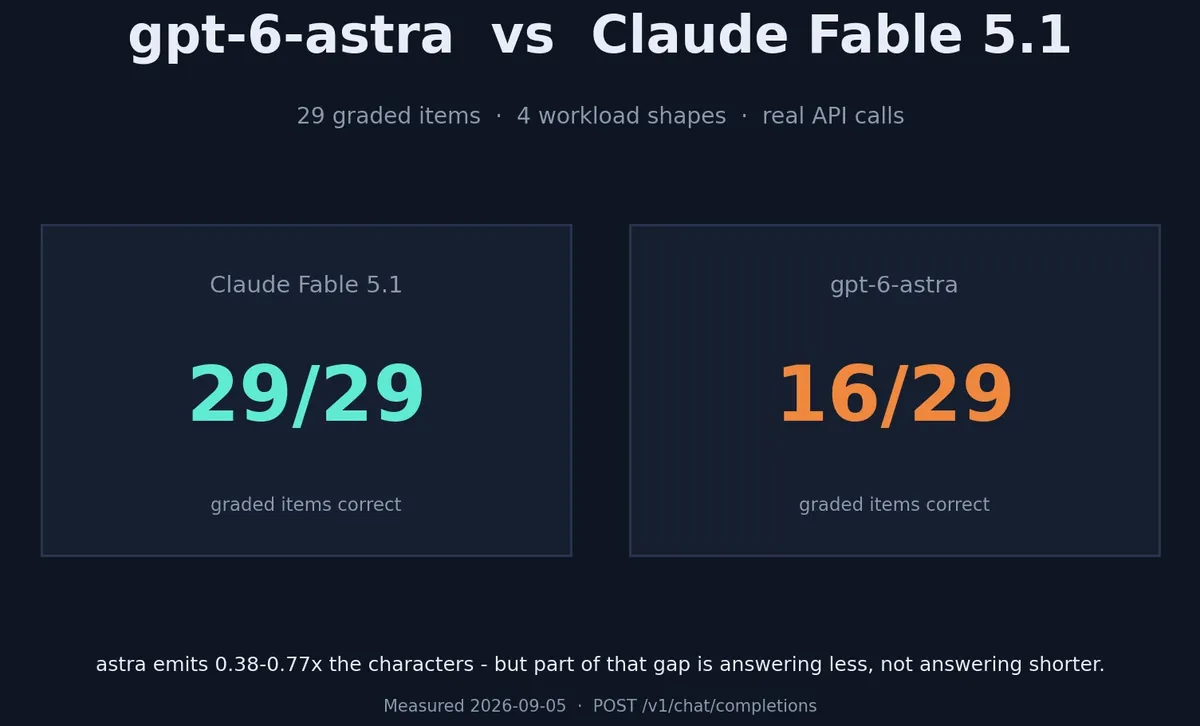
把 gpt-6-astra 与 claude-fable-5-1 放在同一套负载下实测 29 个判分项。结论:fable-5-1 拿到 29/29,astra 16/29。astra 输出字符只有 fable 的 0.38–0.77 倍,但其中相当一部分不是简洁而是答少了——在"三条规则并列"的题上它 5/6 只给一条,2/6 给出的规则号本身是错的;在带假前提的题上 5/6 顺着错误前提作答。另附跨模型族对比的三个前提条件和一个统一端点计量陷阱。
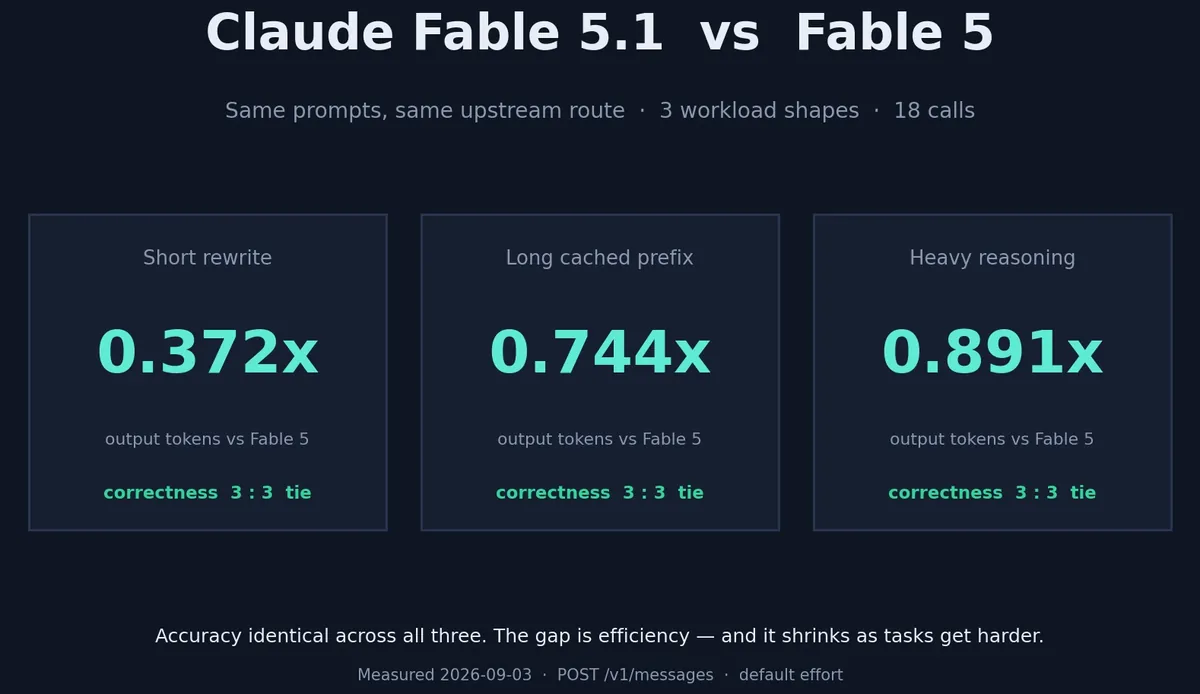
把 claude-fable-5-1 与 claude-fable-5 钉在同一条上游路径上,用短改写、长缓存前缀、重推理三种负载各跑 3 次,记录正确性、输出 token、thinking 预算与延迟。结论:三组正确率全部打平,5.1 用 0.372/0.744/0.891 倍的输出 token 给出同样正确的答案,且官方标注会返回 400 的 7 项破坏性变更实测全部静默返回 200。
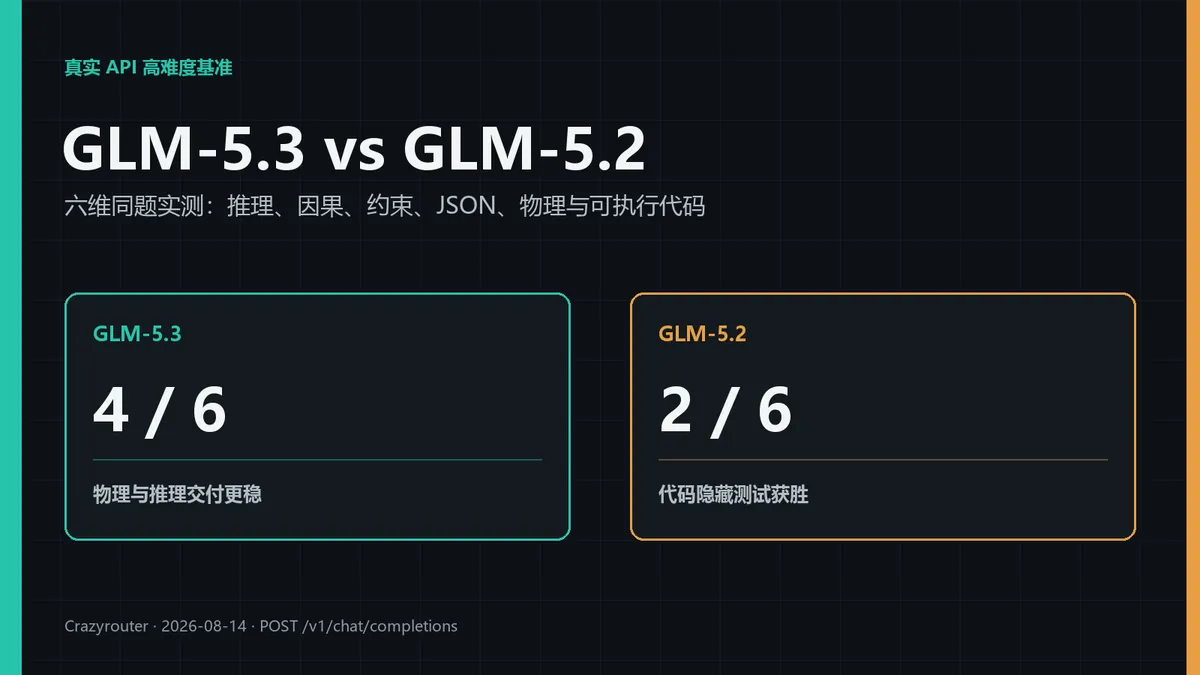
六道高难度同题 API 实测:GLM-5.3 首次交付 4/6,GLM-5.2 为 2/6,但 GLM-5.2 赢得可执行代码隐藏测试。
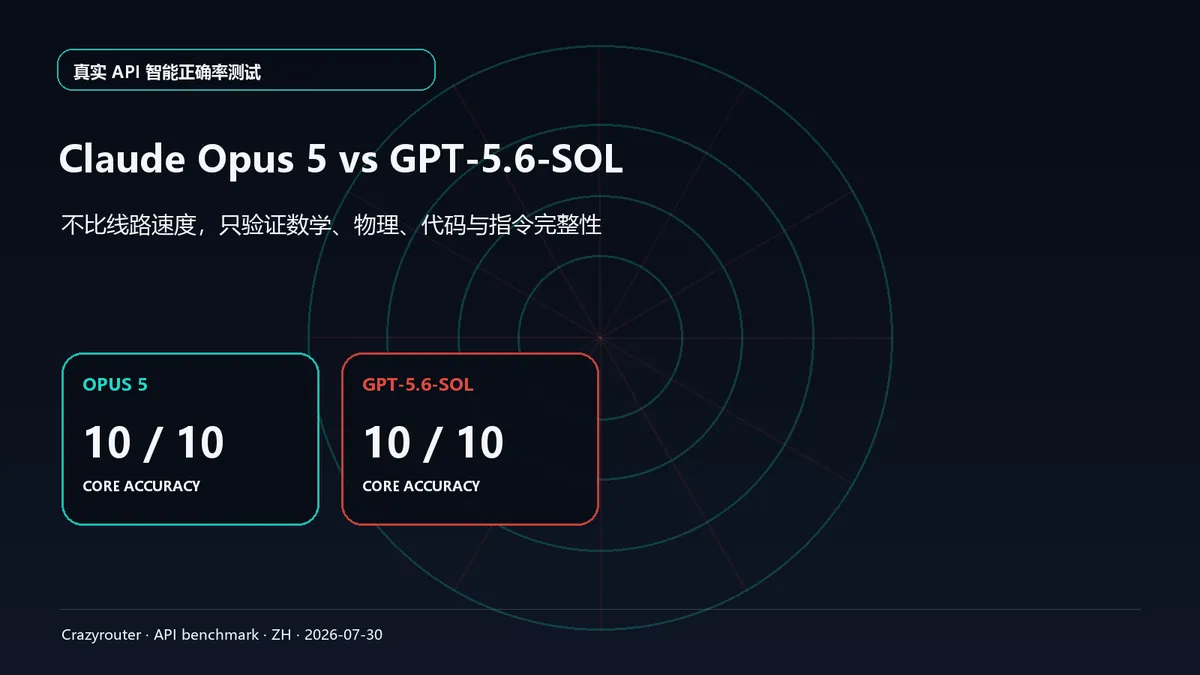
使用同一 Crazyrouter OpenAI-compatible API,对 Claude Opus 5 与 GPT-5.6-SOL 进行 10 道数学、物理、逻辑、统计和可执行代码测试。本文不比较受线路影响的响应速度,重点核验核心答案正确率、完整任务通过率、隐藏测试和严格 JSON 指令遵守。