简体中文
 繁體中文
 English
 Français
 Русский
 日本語
 Tiếng Việt
 한국어
 Deutsch
 Español
 Italiano
 Português
 العربية
 ไทย
 Bahasa Indonesia
 Bahasa Melayu
 Türkçe
 Polski
 Nederlands
 Dansk
 Norsk
 Қазақша
Gemini 2.5 Flash Lite vs GPT 4.1 Mini:图片理解 API 实测对比(Crazyrouter Base URL)
本文用 Crazyrouter OpenAI 兼容接口实测 gemini-2.5-flash-lite 与 gpt-4.1-mini 的图片理解表现,比较识别准确率、延迟、价格、usage 信号和生产选型建议。
Gemini 2.5 Flash Lite vs GPT 4.1 Mini:图片理解 API 实测对比(Crazyrouter Base URL)#
这篇文章补充对比 gemini-2.5-flash-lite 和 gpt-4.1-mini 的图片理解表现。测试统一使用 Crazyrouter Base URL:
https://cn.crazyrouter.com/v1
请求格式是 OpenAI 兼容 chat/completions,图片通过 messages[].content[] 里的 image_url 传入。每个模型测试两张公开图片:Python logo 与 GitHub logo;每张图跑 3 次,所以每个模型共 6 次请求。
测试时间:
2026-06-21T13:36:32Z。这是实测结果,不是模型官网介绍。
结论先行#
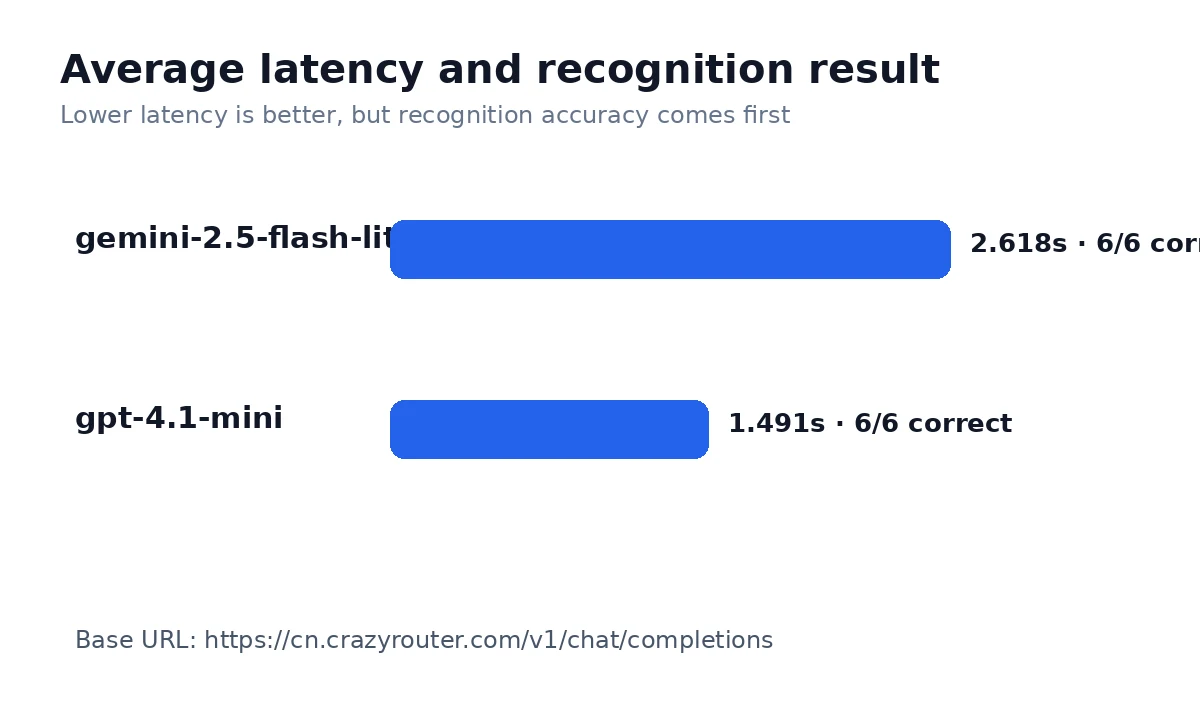
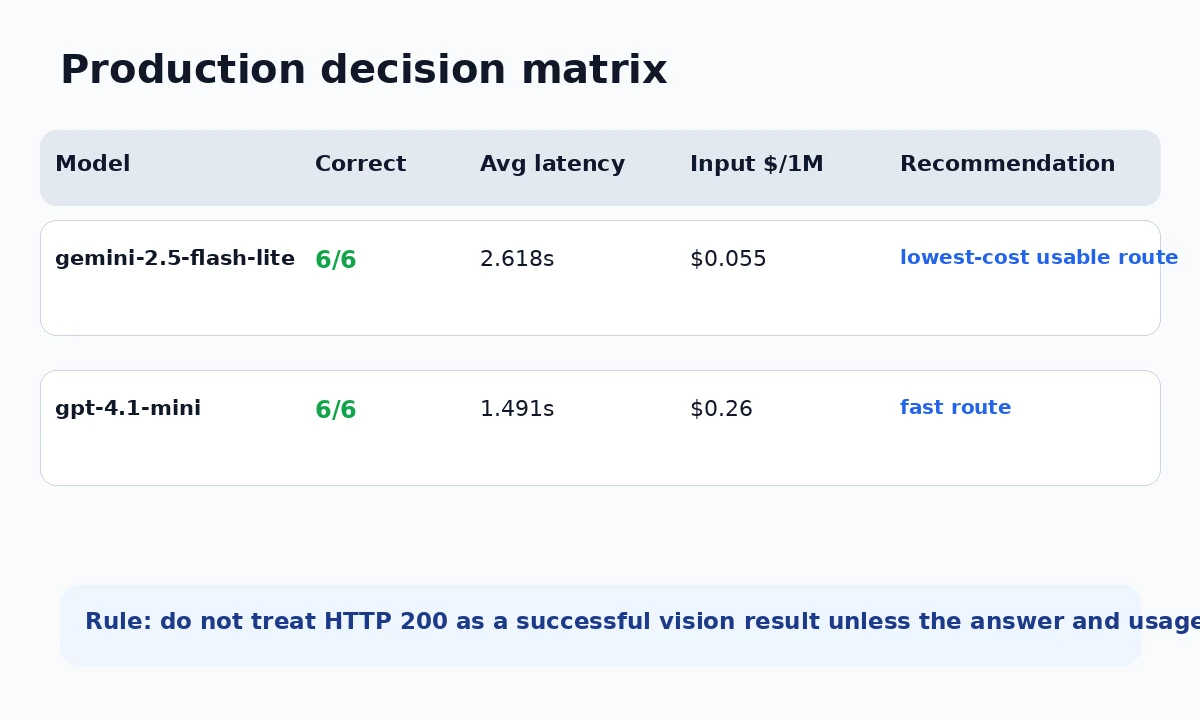
gemini-2.5-flash-lite 识图正确 6/6;gpt-4.1-mini 识图正确 6/6。 速度上 gpt-4.1-mini 更快。 成本上 gemini-2.5-flash-lite 输入价更低。
快速建议:
- 追求速度:选
gpt-4.1-mini - 追求低成本:选
gemini-2.5-flash-lite - 不要只看 HTTP 200,要看是否真的识图和 usage 信号
测试方法#
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_CRAZYROUTER_API_KEY",
    base_url="https://cn.crazyrouter.com/v1"
)

response = client.chat.completions.create(
    model="gemini-2.5-flash-lite",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "Identify the main logo or object in this image."},
            {
                "type": "image_url",
                "image_url": {
                    "url": "https://raw.githubusercontent.com/github/explore/main/topics/python/python.png",
                    "detail": "low"
                }
            }
        ]
    }],
    max_tokens=40,
    temperature=0,
)
代码里的 API endpoint 不加 UTM。人看的链接才加 UTM,例如 Crazyrouter 官网。
核心数据#
| 指标 | gemini-2.5-flash-lite | gpt-4.1-mini |
|---|---|---|
| HTTP 成功 | 6/6 | 6/6 |
| 识别正确 | 6/6 | 6/6 |
| no-image 回复 | 0 | 0 |
| 平均延迟 | 2.618s | 1.491s |
| 中位延迟 | 2.627s | 1.292s |
| 最快请求 | 1.302s | 1.239s |
| 最慢请求 | 4.195s | 2.189s |
| 输入价(USD / 1M tokens) | $0.055 | $0.26 |
| 输出价(USD / 1M tokens) | $0.22 | $1.04 |
输出样例#
| 任务 | 模型 | 输出样例 | 延迟 | Prompt tokens |
|---|---|---|---|---|
logo_python | gemini-2.5-flash-lite | The Python programming language logo. | 2.616s | 1109 |
logo_python | gpt-4.1-mini | Python programming language official logo with two snakes. | 1.69s | 159 |
logo_github | gemini-2.5-flash-lite | The GitHub logo. | 2.638s | 1109 |
logo_github | gpt-4.1-mini | GitHub's black cat silhouette logo inside a circle. | 1.239s | 159 |
为什么 HTTP 200 不等于图片理解成功?#
图片理解链路里,HTTP 状态码只能说明请求被接口接受并返回了响应。它不能证明模型真的看到了图片。
这次 Gemini 补测尤其说明了这一点:gemini-2.5-flash 返回了 200,但输出出现了“未提供图片”、CBC logo、飞船等错误结果;usage 里也能看到 prompt token / image token 信号异常。因此文章里把“识别正确率”和“no-image 回复”单独列出来,而不是只看请求是否成功。
生产环境怎么选?#
gemini-2.5-flash-lite 的定位:低价 Gemini 轻量模型,本轮 image_url 识图 6/6 正确。
gpt-4.1-mini 的定位:本轮最快,适合低延迟线上产品。
建议在生产里按任务分层:
- 简单 logo / 图标识别:优先选择本轮 6/6 正确且成本低的路线;
- 实时交互:优先看平均延迟和尾部延迟;
- Gemini 路线:必须额外做视觉 smoke test,不能只用文本健康检查;
- 网关出站流量敏感:还要看
image_url是上游 URL 透传,还是网关下载后转 inline/base64。
最终建议#
- 追求速度:选
gpt-4.1-mini - 追求低成本:选
gemini-2.5-flash-lite - 不要只看 HTTP 200,要看是否真的识图和 usage 信号
如果你要复现测试,可以直接使用:
base_url = "https://cn.crazyrouter.com/v1"
更多模型价格可以看 Crazyrouter Pricing。